Ekstrak catatan sintetis ini ke JSON dengan bidang id, owner, deadline, dan evidence: [R1] Masalah 41: Ana bertanggung jawab atas perbaikan ekspor; belum ada tenggat yang disepakati. [R2] Masalah 42: peninjauan jatuh tempo 15 Oktober; penanggung jawab belum ditetapkan; tahun tidak disebutkan. Gunakan null untuk nilai yang tidak ada dan pertahankan tanggal parsial sesuai yang diberikan. Kutip sumber dalam evidence. Jangan mengarang tahun atau penanggung jawab. Periksa setiap bidang terhadap catatannya; ini tugas pemformatan teks, bukan operasi basis data.
API Claude Fable 5.1 untuk Pemrograman dan Riset
Bandingkan harga API Claude Fable 5.1 dan pilihan integrasi untuk pemrograman serta riset bertahap. Tinjau panduan penalaran dan uji perintah teks secara daring.
Harga dan penagihan API Claude Fable 5.1
Harga resmi
- Input
- $10.0000 /M
- Output
- $50.0000 /M
- Input cache
- $0.2500 /M
- Penulisan cache (5 mnt)
- $12.5000 /M
- Penulisan cache (1 jam)
- $20.0000 /M
Harga API Hop Hemat 45%
- Input
- $5.5000 /M
- Output
- $27.5000 /M
- Input cache
- $0.1375 /M
- Penulisan cache (5 mnt)
- $6.8750 /M
- Penulisan cache (1 jam)
- $11.0000 /M
Harga referensi belum diverifikasi secara independen. Periksa tarif terkini, satuan penagihan, dan ketentuan penerbit yang berlaku sebelum membandingkan biaya.
Alat percakapan daring Claude Fable 5.1
Pengaturan model
Apa fungsi memori?
Memori menyertakan giliran percakapan yang selesai dan dapat digunakan kembali dalam permintaan berikutnya, sehingga Anda dapat mengajukan pertanyaan lanjutan tanpa mengulangi konteks.
Apa yang terjadi ketika dinonaktifkan?Hanya pesan baru Anda dan perintah sistem yang dikirim. Pesan yang ada tetap terlihat; mengaktifkan kembali memori akan menyertakan lagi giliran sebelumnya yang memenuhi syarat.
Apakah ini memori jangka panjang?Tidak. Ini adalah konteks percakapan, bukan memori lintas percakapan terpisah. Balasan yang gagal, dihentikan, terpotong, atau tidak dapat digunakan kembali dikecualikan. Riwayat lebih banyak dapat menggunakan lebih banyak token masukan dan meningkatkan biaya.
Parameter lanjutan
0 karakter atau lebih(0/Tanpa batas tetap)
Tidak ada batas karakter tetap; seluruh permintaan tunduk pada batas ukuran permintaan dan konteks model. Ini bukan hitungan token. Percakapan

Apa yang dapat saya bantu hari ini?
Belum ada data respons Siap
Contoh perintah Claude Fable 5.1
Ini adalah perintah evaluasi untuk Claude Fable 5.1, bukan keluaran model yang tercatat. Perintah ini hanya menganalisis teks yang disediakan; tidak menjalankan kode, memeriksa sistem produksi, atau membuktikan kinerja konteks panjang. Periksa bukti yang dikutip dan kriteria penerimaan, lalu tinjau metadata respons serta penggunaan sebelum penggunaan produksi.
Gunakan hanya sampel dokumen ini: [P1] Perbaikan ekspor lulus pemeriksaan staging. [P2] Rilis Jumat diusulkan, belum disetujui. [P3] Mei akan meninjau pesan kesalahan pada Selasa. [P4] Belum ada penanggung jawab dokumentasi. Kembalikan tabel klaim, kutipan pendukung yang persis, ID paragraf, dan ketidakpastian. Apakah rilis produksi disetujui? Siapa penanggung jawab dokumentasi? Tandai fakta yang belum ada sebagai tidak diketahui. Setiap kutipan harus sesuai sampel yang disediakan; jangan menyimpulkan keberhasilan produksi dari staging. Sampel kecil ini tidak menguji panjang konteks maksimum.
Tinjau kebijakan webhook pembayaran fiktif ini: setiap POST yang gagal dicoba ulang tiga kali, tidak ada kunci idempotensi yang disimpan, dan saldo didebit sebelum respons dikirim. Identifikasi risiko penagihan ganda, usulkan perubahan minimal dan tiga pengujian penerimaan. Gunakan hanya fakta ini; jangan mengasumsikan akses ke kode, alat, atau sistem produksi.
Apa itu Claude Fable 5.1?
Pemrograman dan riset bertahap
Claude Fable 5.1 adalah model yang dirilis Anthropic pada 1 September 2026, berfokus pada analisis berkelanjutan, tugas bertahap, dan kolaborasi dengan alat. Alih-alih sekadar memberikan jawaban cepat, model ini cocok untuk masalah pemrograman kompleks serta riset mendalam yang memerlukan pemikiran lebih dalam. Spesifikasi aslinya mendukung masukan teks dan gambar, keluaran teks, jendela konteks satu juta token, serta hingga 128K token keluaran. API aslinya menggunakan tingkat high secara bawaan, dengan tingkat penalaran yang dapat disesuaikan dengan tugas.
Coba percakapan teks sebelum mengintegrasikan API
Alat daring API Hop memungkinkan Anda mencoba Fable 5.1 dengan cepat: masuk, buat kunci API, dan tambahkan sedikit saldo untuk mulai mengevaluasi model tanpa mengintegrasikan API atau membeli langganan. Anda tidak perlu membuka akun Anthropic terpisah, tetapi ini bukan jaminan bebas pembatasan akun; ketentuan platform yang berlaku tetap berlaku. Halaman ini mendukung percakapan teks, bukan unggahan berkas, penelusuran web, atau eksekusi kode.
Untuk apa Claude Fable 5.1 dapat digunakan?
Penelusuran kesalahan dan peninjauan kode
Anthropic mencantumkan pengembangan lintas basis kode, peninjauan kode, dan pekerjaan kinerja sebagai kasus penggunaan utama Fable 5.1. Berikan jejak kesalahan, kode relevan, detail lingkungan, serta langkah reproduksi, dan model dapat membaca kesalahan kompiler, stack, serta sumber pustaka yang belum dikenal untuk mengikuti ketergantungan dan mengusulkan solusi. Seorang pelanggan menjelaskan crash langka yang belum sepenuhnya diselesaikan timnya selama bertahun-tahun: Fable 5.1 membongkar pustaka eksternal, membandingkan crash dump, dan menelusuri masalah ke cacat pustaka tersebut, hingga akhirnya menyelesaikannya.
Anda juga dapat memintanya memeriksa kompatibilitas antarmuka, jalur pengecualian, pemeriksaan izin, pembersihan sumber daya, serta konsistensi data. Perlakukan model sebagai asisten berpengalaman yang mengusulkan pilihan, sementara pengembang tetap bertanggung jawab atas keputusan.
Riset dan analisis
Riset dan analisis merupakan kasus penggunaan utama lainnya. Selain meringkas materi, Fable 5.1 dapat melanjutkan perhitungan seputar pertanyaan, mengamati hasil, dan menyesuaikan pendekatan. Seorang pelanggan melaporkan bahwa tugas optimasi memerlukan perintah tambahan dengan Fable 5 tetapi tidak lagi memerlukan panduan yang sama dengan Fable 5.1. Dengan alat pencarian atau data yang disediakan aplikasi, model dapat menganalisis data publik, menyusun usulan, dan menghasilkan penilaian sesuai kebutuhan Anda; halaman teks ini sendiri tidak menelusuri web.
Data publik dapat memuat banyak gangguan. Kami menyarankan membangun sumber tepercaya berdasarkan pemahaman Anda tentang bisnis, atau menggunakan API data API Hop yang dipilih tim rekayasa dan bisnis kami.
Penulisan dan penyusunan dokumen
Peningkatan utama penulisan Fable 5.1 adalah ungkapan lebih jelas dan kepatuhan lebih baik terhadap kebutuhan penulisan, bukan sekadar menghasilkan artikel lebih panjang. Panduan penulisan Anthropic menyarankan mempertahankan model sebagai asisten alih-alih memperlakukannya sebagai penulis utama konten, serta tetap meninjau dan menilai sendiri konten hasil AI.
Anthropic menyarankan menentukan audiens, informasi atau masalah yang perlu dijawab bagi pembaca, informasi yang wajib disertakan, serta ungkapan yang harus dihindari. Tujuan, struktur, dan contoh konkret lebih mungkin menghasilkan draf berguna daripada sekadar meminta artikel profesional.
Dokumen panjang dan diskusi beberapa giliran
Dalam perbandingan Artificial Analysis, Fable 5.1 memiliki indeks gabungan lebih tinggi daripada Kimi K3, tetapi mendapat 85% dibanding 89% Kimi K3 pada penalaran konteks panjang AA-LCR v1.1. Konfigurasinya Fable 5.1 pada Max dengan Default Fallback dan Kimi K3 pada Max. Karena itu Kimi K3 memimpin pengujian penalaran dokumen panjang khusus ini; hasil ini tidak mendukung penyebutan Fable 5.1 sebagai model dokumen panjang terkuat.
Setelah pemadatan konteks dalam alur kerja panjang, batasan penting, keputusan yang telah dibuat, atau detail presisi dapat hilang, seperti dibahas dalam panduan perintah Anthropic. Jika dapat diimplementasikan dalam aplikasi Anda, kami menyarankan mempertahankan informasi penting pada setiap percakapan.
Tolok ukur Claude Fable 5.1: pemrograman, penalaran, dan kecepatan
Evaluasi peluncuran Anthropic dan evaluasi independen Artificial Analysis disajikan terpisah di bawah. Pengaturannya berbeda, dan keduanya bukan pengukuran API Hop.
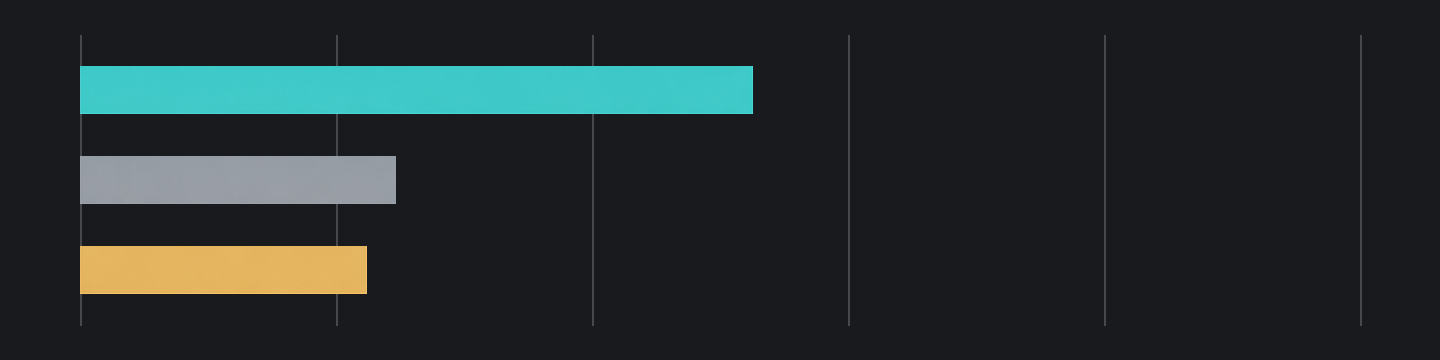
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
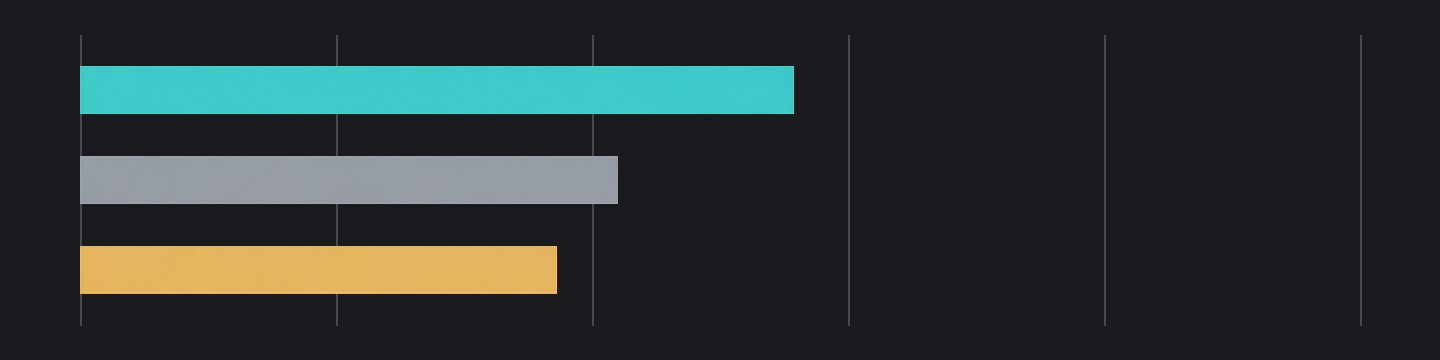
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
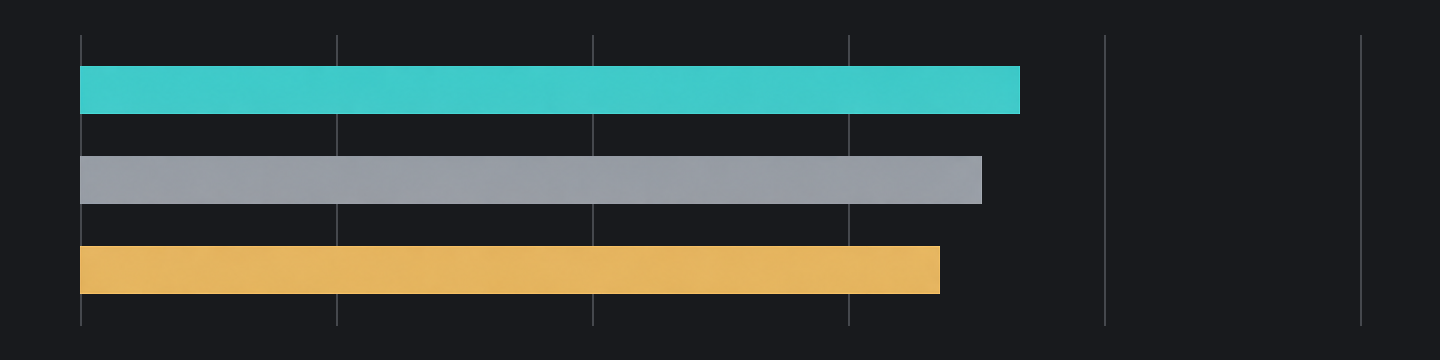
Fable 5.1: 60.9%Fable 5: 57.8%
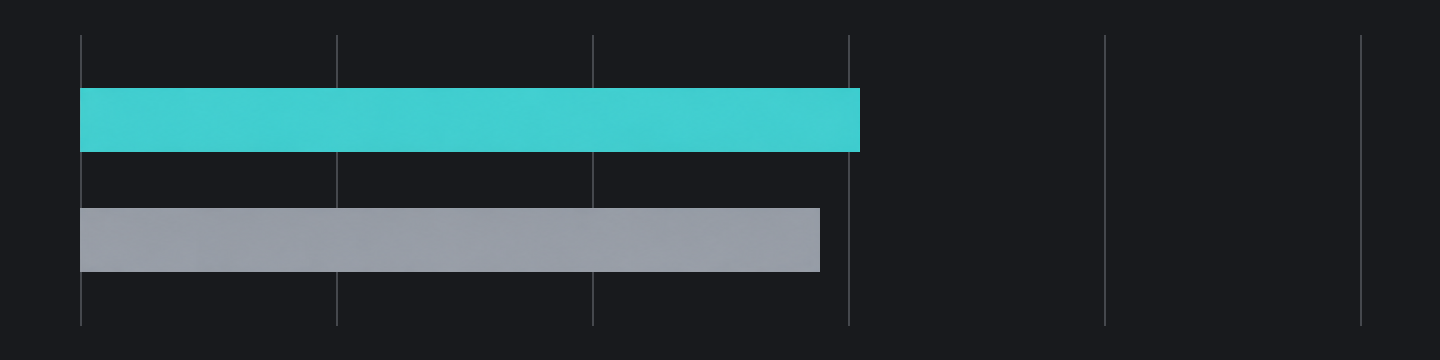
Fable 5.1: 65.0%Fable 5: 63.8%
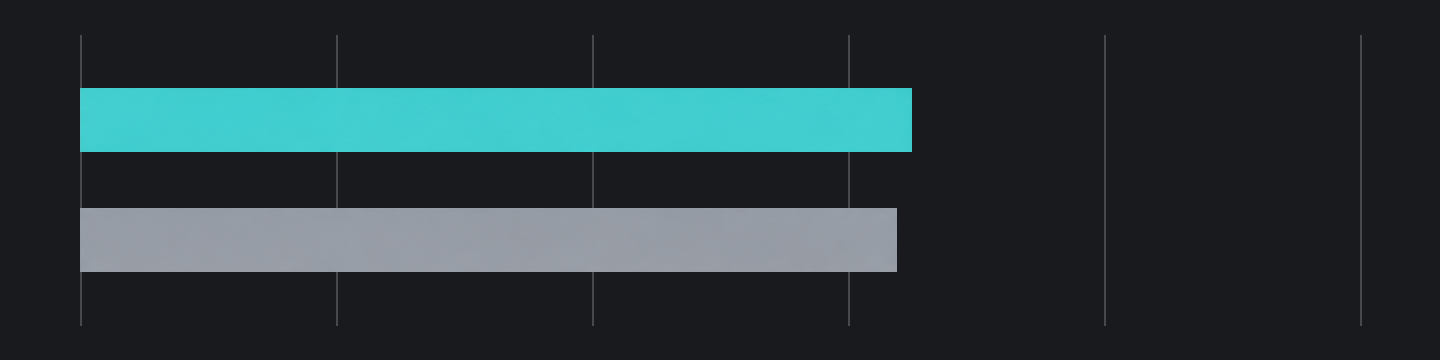
Pemrograman: lonjakan terbesar pada pekerjaan terminal
Peningkatan pemrograman paling jelas pada Fable 5.1 terjadi dalam tugas terminal yang memerlukan pengoperasian lingkungan, pemrosesan hasil eksekusi, dan kelanjutan pekerjaan, bukan peningkatan rata-rata di setiap tugas pemrograman. Anthropic melaporkan peningkatan dibanding Fable 5 sebesar 27.9 poin persentase pada Terminal-Bench-Science 0.1, 13.8 poin pada Terminal-Bench 4.0, dan 2.9 poin pada CursorBench 3.2.0. Perbedaan ini menunjukkan eksekusi tugas kompleks yang lebih kuat, bukan lonjakan seragam kualitas pembuatan kode.
Nilainya terletak pada menghubungkan analisis dengan tindakan praktis. Anthropic menjelaskan pengembangan lintas basis kode, penulisan pengujian secara mandiri, serta penggunaan hasil visual untuk memeriksa apakah implementasi memenuhi tujuannya. Interpretasi kami adalah model lebih siap memahami, mengubah, memverifikasi, dan menyempurnakan solusi alih-alih berhenti pada usulan masuk akal.
Penalaran: peningkatan lebih kecil yang bergantung pada pengaturan
Penalaran meningkat, tetapi beberapa pengujian yang dipublikasikan menunjukkan peningkatan lebih kecil daripada tugas terminal. Pada Humanity's Last Exam, skor tanpa alat naik dari 57.8% Fable 5 menjadi 60.9%, dan skor dengan alat dari 63.8% menjadi 65.0%: peningkatan 3.1 dan 1.2 poin persentase.
Kami tidak melihat tingkat penalaran sebagai sakelar sederhana ketika lebih tinggi selalu berarti lebih pintar. Panduan Anthropic mendefinisikannya sebagai kendali utama atas kemampuan, latensi, dan biaya, serta mencatat bahwa label tingkat penalaran yang identik lintas model tidak mewakili jumlah pemikiran yang identik.
Diskusi komunitas memberikan contoh tandingan yang berguna. Pengguna Hacker News seaurchinzee menafsirkan kartu sistem sebagai menunjukkan bahwa tingkat penalaran tertinggi tidak berkinerja terbaik pada FrontierCode Extended, dan pengaturan lebih tinggi dapat meningkatkan perubahan yang tidak diminta. Ini menyangkut evaluasi pemrograman tertentu, bukan HLE, tetapi menyoroti bahwa penalaran lebih banyak tidak selalu berarti kepatuhan tugas lebih baik. Cakupan penting bersama kebenaran, dan panduan perintah Anthropic secara terpisah membahas perubahan tambahan serta perluasan cakupan.
Indeks independen dan kapasitas pemrosesan: dua pertanyaan terpisah
Menurut kami, kemampuan keseluruhan dan kecepatan respons Fable 5.1 harus dievaluasi terpisah, bukan diringkas menjadi satu skor. Berdasarkan pemeriksaan pada 4 Oktober 2026, Artificial Analysis mencatat Intelligence Index 53 untuk konfigurasi Max, Default Fallback, sekitar 66.2 token keluaran per detik, dan sekitar 259.12 detik hingga token pertama.
Pada tugas menggambar SVG yang sama, high memerlukan sekitar 29.6 detik dan max sekitar 13 menit 54 detik. Kami menilai hasil tingkat penalaran tertinggi lebih baik, tetapi waktu tunggu serta penggunaan keluaran juga meningkat secara substansial. Kesimpulan kami adalah penalaran tambahan dapat memperbaiki beberapa keluaran kompleks.
Claude Fable 5.1 dibanding Fable 5, GPT-5.6 Sol, dan Kimi K3
Bukti paling langsung yang mendukung Fable 5.1 tetap keunggulannya pada tugas terminal. Tabel berikut merupakan evaluasi peluncuran Anthropic.
Fable 5.1: 53Kimi K3: 44
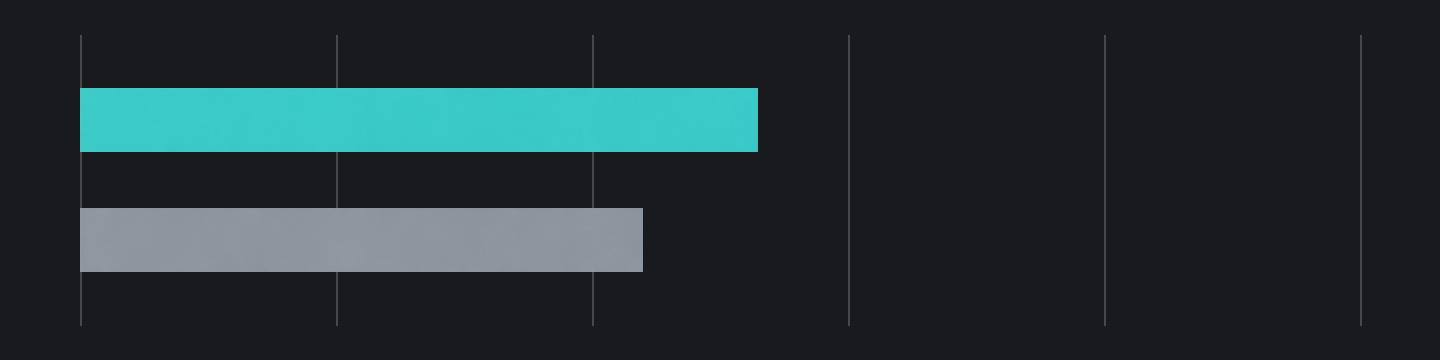
Fable 5.1: 52%Kimi K3: 13%
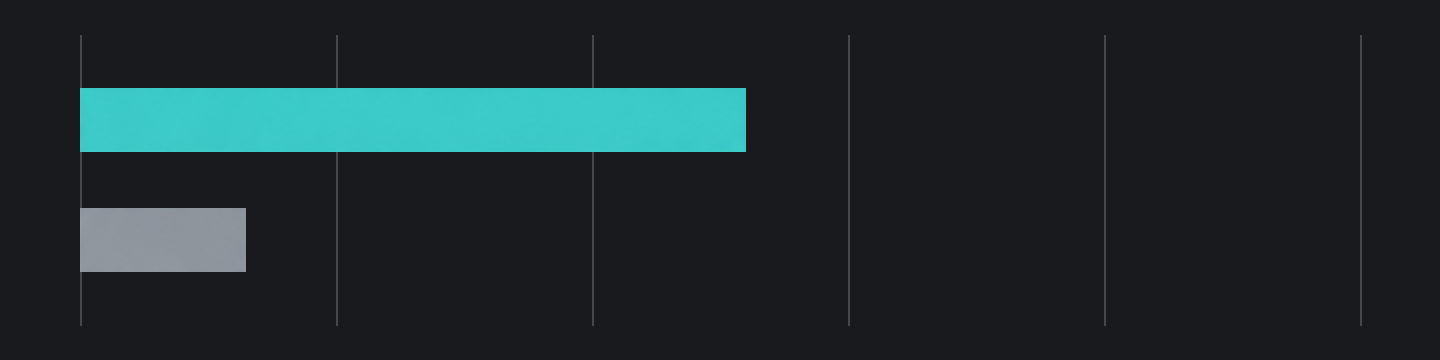
Fable 5.1: 85%Kimi K3: 89%
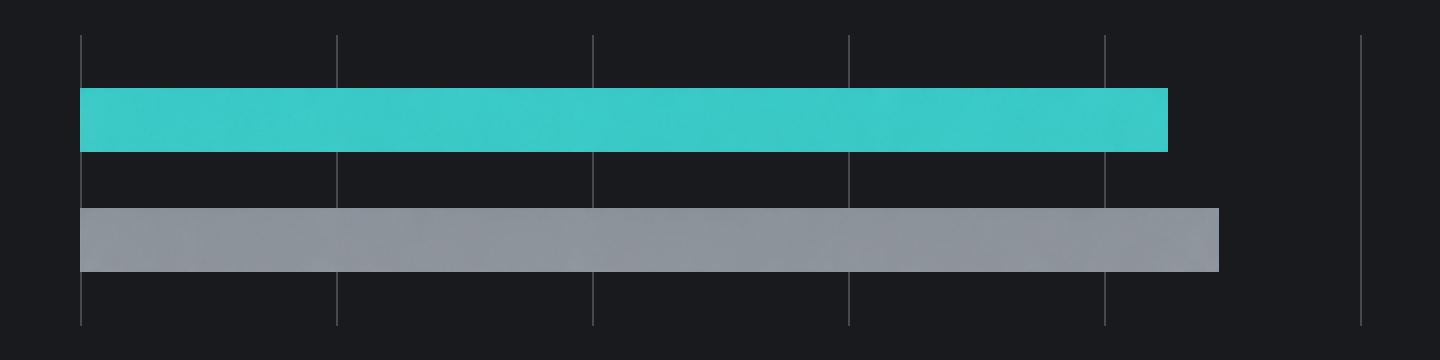
| Tolok ukur | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Dibanding Fable 5 dan GPT-5.6 Sol: keunggulan paling jelas pada pemrograman terminal
Skor ini menunjukkan keunggulan Fable 5.1 atas GPT-5.6 Sol lebih besar pada kedua tolok ukur terminal daripada CursorBench. Seorang pelanggan melaporkan Fable 5.1 menyamai atau sedikit melampaui Fable 5 dalam pengujiannya sambil mengurangi biaya per tugas, sehingga mulai menggunakan model untuk peninjauan kode.
Dibanding Kimi K3: penalaran dokumen panjang membalik peringkat
Penilaian kami adalah Fable 5.1 lebih kuat pada evaluasi gabungan dalam perbandingan ini. Artificial Analysis mencatat indeks 53 untuk Fable 5.1 dan 44 untuk Kimi K3, dengan skor Terminal-Bench 4.0 masing-masing 52% serta 13%. Pada penalaran konteks panjang AA-LCR v1.1, peringkat berbalik: Fable 5.1 mendapat 85% dan Kimi K3 mendapat 89%.
Sebagian pengguna mungkin lebih menyukai penjelasan Kimi K3 dan beralih untuk peninjauan kode atau pemahaman masalah. Kesimpulan kami saat ini adalah Fable 5.1 memimpin kemampuan gabungan, sementara Kimi K3 memimpin pengujian dokumen panjang khusus ini.
Mengapa menggunakan Claude Fable 5.1 melalui API Hop?
Penagihan berdasarkan penggunaan dan optimasi biaya model
Biaya mengikuti tarif API Hop saat ini dan penggunaan sebenarnya. Isi saldo sesuai kebutuhan.
Model AI dan API data terpadu, dengan akses banyak model di satu tempat
Satu kunci API menghubungkan banyak model AI dan layanan data, mengurangi biaya integrasi serta memungkinkan pergantian dengan satu klik. Aplikasi bisnis membutuhkan AI dan data.
Log panggilan dan kontrol akses aplikasi, dengan kejelasan setiap panggilan
Setiap panggilan API dicatat di dasbor Anda. Buat kunci API terpisah untuk aplikasi berbeda.
Evaluasi keluaran berdasarkan tugas Anda
Gunakan ID model yang didokumentasikan dan parameter yang didukung melalui API Hop. Evaluasi keluaran berdasarkan kriteria penerimaan Anda sendiri, lalu periksa catatan penggunaan serta metadata respons sebelum penggunaan produksi. Nama model atau contoh tidak menjamin setiap hasil.
Cara menggunakan Claude Fable 5.1 di API Hop
Setelah membuat kunci API di konsol, ikuti dokumentasi untuk mulai menggunakan Claude Fable 5.1.
Siapkan akun Anda dan uji secara daring
Masuk, pastikan saldo Anda, dan buat kunci API.
Coba di ruang uji
Jelajahi kemampuan model di ruang uji untuk menemukan cara terbaik menggunakannya.
Integrasikan Claude Fable 5.1 ke bisnis Anda
Ikuti dokumentasi pengembang kami untuk mengintegrasikan Claude Fable 5.1 ke bisnis Anda.
Peningkatan model mendatang
Untuk beralih ke model lebih baru, pastikan dahulu ID tepatnya dikembalikan katalog model untuk kunci API Anda. Jika model mendukung endpoint dan bidang permintaan yang sama, perbarui ID model, lalu uji format respons, streaming, batas keluaran, dan penagihan sebelum mengirim lalu lintas produksi. Untuk tugas gambar atau video asinkron, verifikasi juga pengiriman tugas, polling status, dan pengambilan hasil.
Pertanyaan umum API Claude Fable 5.1
Apakah Claude Fable 5.1 merupakan model API yang sama dengan Fable 5?
Tidak. Claude Fable 5.1 (nama model API: claude-fable-5-1) merupakan versi peningkatan Claude Fable 5 (nama model API: claude-fable-5). Gunakan parameter model yang benar saat memanggil API.
Mengapa thinking kosong atau jawaban tidak lengkap?
Fable 5.1 asli menggunakan penalaran adaptif secara bawaan dan dapat tidak menampilkan teks penalaran. Permintaan biasa tidak memerlukan parameter thinking, dan thinking kosong saja bukan kegagalan. Untuk jawaban tidak lengkap, periksa status penyelesaian dan batas keluaran, dengan menyediakan ruang cukup untuk penalaran serta teks akhir.
Bagaimana memecahkan masalah autentikasi, saldo, atau kesalahan akses?
Ikuti dokumentasi kesalahan API untuk mendiagnosis masalah.
Dapatkah saya menggunakan OpenAI Responses untuk Claude Fable 5.1?
OpenAI Responses tidak didukung. Claude memiliki format Claude Messages sendiri; lihat dokumentasi untuk detailnya.
Dapatkah saya memaksa panggilan alat atau menyunting percakapan Messages asli?
Fable 5.1 asli tidak mendukung jenis tool_choice paksa any atau tool. Berhati-hatilah saat memutar ulang penalaran tersimpan setelah menyunting pesan sebelumnya. Pertahankan blok konten assistant asli dan tanda tangannya secara utuh selama kelanjutan alat.
Apakah memori percakapan bersifat permanen?
Tidak. API tidak otomatis mempertahankan konteks percakapan untuk permintaan berikutnya. Kelola riwayat sendiri dan sertakan konteks yang diperlukan pada setiap permintaan. Memori jangka panjang harus diimplementasikan oleh aplikasi Anda.
API teks terkait
Contoh API Claude Fable 5.1 dan parameter yang didukung
Panduan mulai cepat API Claude Fable 5.1
claude-fable-5-1model wajib diisi; contoh ini menggunakan ID model halaman saat ini. Periksa akses model untuk kunci API Anda melalui GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages memerlukan max_tokens. Batas dalam contoh ini dapat diubah, bukan nilai bawaan hulu atau batas model. Penalaran dapat menghabiskannya sebelum teks jawaban muncul; sesuaikan dengan tugas Anda dan periksa biaya keluaran.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Referensi kelompok dan protokol
Claude Messages
Dokumentasi API lengkapAPI native yang kompatibel dengan Claude Messages. Endpoint ini menggunakan bentuk permintaan dan respons Anthropic Messages, termasuk panggilan alat dan peristiwa SSE Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages