Extraia estes registros sintéticos em JSON com id, owner, deadline e evidence: [R1] Problema 41: Ana cuida da correção de exportação; sem prazo acordado. [R2] Problema 42: revisão até 15 de outubro; sem responsável; ano não informado. Use null para valores ausentes e preserve datas parciais. Cite a fonte em evidence. Não invente ano ou responsável. Confira cada campo com seu registro; é formatação de texto, não uma operação de banco de dados.
API Claude Fable 5.1 para programação e pesquisa
Compare preços da API e opções de integração do Claude Fable 5.1 para programação e pesquisa em várias etapas. Confira orientações de raciocínio e teste prompts de texto online.
Preços e cobrança da API Claude Fable 5.1
Preço oficial
- Entrada
- $10.0000 /M
- Saída
- $50.0000 /M
- Entrada em cache
- $0.2500 /M
- Gravação em cache (5 min)
- $12.5000 /M
- Gravação em cache (1 h)
- $20.0000 /M
Preço do API Hop Economia 45%
- Entrada
- $5.5000 /M
- Saída
- $27.5000 /M
- Entrada em cache
- $0.1375 /M
- Gravação em cache (5 min)
- $6.8750 /M
- Gravação em cache (1 h)
- $11.0000 /M
Preço de referência não verificado de forma independente. Confira as tarifas atuais, unidades de cobrança e condições aplicáveis do fornecedor antes de comparar custos.
Ferramenta de chat online Claude Fable 5.1
Configurações do modelo
O que a memória faz?
Inclui as interações concluídas e reutilizáveis desta conversa na próxima solicitação, permitindo fazer perguntas de acompanhamento sem repetir o contexto.
O que acontece quando está desativada?Somente a nova mensagem e um eventual prompt do sistema são enviados. As mensagens existentes continuam visíveis; reativar a memória inclui novamente as interações anteriores elegíveis.
É uma memória de longo prazo?Não. É o contexto desta conversa, não uma memória entre conversas separadas. Respostas com falha, interrompidas, truncadas ou não reutilizáveis são excluídas. Mais histórico pode usar mais tokens de entrada e aumentar o custo.
Parâmetros avançados
0 ou mais caracteres(0/Sem limite fixo)
Sem limite fixo de caracteres; a solicitação completa está sujeita aos limites de tamanho e de contexto do modelo. Isto não é uma contagem de tokens. Conversa

Como posso ajudar você hoje?
Ainda não há dados de resposta Pronto
Exemplos de prompts para Claude Fable 5.1
Estes são prompts de avaliação para Claude Fable 5.1, não saídas registradas. Eles analisam apenas o texto fornecido; não executam código, não inspecionam sistemas de produção e não comprovam desempenho em contextos longos. Confira as evidências citadas e os critérios de aceitação, depois revise os metadados e o uso antes de usar em produção.
Use apenas este documento: [P1] A correção de exportação passou nas verificações de homologação. [P2] A publicação na sexta foi proposta, não aprovada. [P3] Mei revisará as mensagens de erro na terça. [P4] A documentação não tem responsável. Retorne tabela com afirmação, citação exata, ID do parágrafo e incerteza. A publicação em produção está aprovada? Quem cuida da documentação? Marque fatos ausentes como desconhecidos. Toda citação deve coincidir com a amostra; não infira sucesso em produção pela homologação. Esta pequena amostra não testa o contexto máximo.
Revise esta política fictícia de webhook de pagamento: cada POST com falha é repetido três vezes, nenhuma chave de idempotência é salva e o saldo é debitado antes da resposta. Identifique riscos de cobrança duplicada, proponha mudanças mínimas e três testes de aceitação. Use apenas esses fatos; não presuma acesso ao código, ferramentas ou sistemas de produção.
O que é Claude Fable 5.1?
Programação e pesquisa em várias etapas
O Claude Fable 5.1 é um modelo da Anthropic lançado em 1 de setembro de 2026, focado em análise contínua, tarefas de várias etapas e colaboração com ferramentas. É adequado a problemas complexos de programação e pesquisa aprofundada, não apenas respostas rápidas. Suas especificações nativas aceitam texto e imagem, produzem texto, oferecem um milhão de tokens de contexto e até 128K tokens de saída. A API nativa usa esforço high por padrão, ajustável à tarefa.
Teste o chat antes de integrar a API
A ferramenta on-line da API Hop permite testar rapidamente o Fable 5.1: entre, crie uma chave de API e adicione um pouco de crédito, sem integração nem assinatura. Não é preciso uma conta Anthropic separada, mas isso não garante ausência de restrições; os termos da plataforma continuam valendo. Esta página oferece texto, não upload de arquivos, navegação web ou execução de código.
Para que usar o Claude Fable 5.1?
Depuração e revisão de código
A Anthropic lista desenvolvimento entre bases de código, revisão e desempenho entre os usos principais do Fable 5.1. Forneça rastros de erro, código, detalhes do ambiente e reprodução: ele pode ler erros do compilador, pilhas e fontes de bibliotecas desconhecidas para seguir dependências e propor soluções. Um cliente descreveu uma falha rara que a equipe não resolvera totalmente durante anos: o Fable 5.1 desmontou uma biblioteca externa, comparou dumps e rastreou a causa até um defeito nela, resolvendo-o.
Você também pode pedir verificações de compatibilidade, exceções, permissões, liberação de recursos e consistência dos dados. Trate-o como assistente experiente que propõe opções; a responsabilidade pelas decisões continua com os desenvolvedores.
Pesquisa e análise
Pesquisa e análise são outro uso central. Além de resumir, o Fable 5.1 pode desenvolver cálculos, observar resultados e ajustar a abordagem. Um cliente relatou que uma otimização exigia mais orientação no Fable 5, mas não no Fable 5.1. Com ferramentas de busca ou dados fornecidas pela aplicação, pode analisar dados públicos, redigir propostas e avaliações; esta página de texto não navega na web.
Dados públicos podem conter muito ruído. Sugerimos fontes confiáveis baseadas no seu conhecimento do negócio ou APIs de dados API Hop selecionadas por nossas equipes de engenharia e negócio.
Redação e rascunhos de documentos
As melhorias de escrita do Fable 5.1 são clareza e maior aderência aos requisitos, não apenas textos mais longos. A Anthropic recomenda mantê-lo como assistente, não autor principal, e continuar revisando e julgando pessoalmente o conteúdo de IA.
A Anthropic recomenda especificar público, informação ou problema do leitor, conteúdo obrigatório e expressões a evitar. Objetivos concretos, estrutura e exemplos tendem a gerar rascunhos mais úteis que pedir apenas um artigo profissional.
Documentos longos e discussão em várias rodadas
Na Artificial Analysis, o Fable 5.1 tem índice composto maior que o Kimi K3, mas obtém 85% contra 89% do Kimi K3 no AA-LCR v1.1 de contexto longo. As configurações são Fable 5.1 Max com Default Fallback e Kimi K3 Max. O Kimi K3 lidera esse teste específico; isso não sustenta chamar o Fable 5.1 de melhor modelo para documentos longos.
Após compactar o contexto em fluxos longos, podem se perder restrições, decisões ou detalhes precisos, como discute a orientação da Anthropic. Se sua aplicação permitir, sugerimos preservar as informações essenciais em toda conversa.
Benchmarks do Claude Fable 5.1: código, raciocínio e velocidade
As avaliações de lançamento da Anthropic e as independentes da Artificial Analysis aparecem separadamente. As configurações diferem e nenhuma é medição da API Hop.
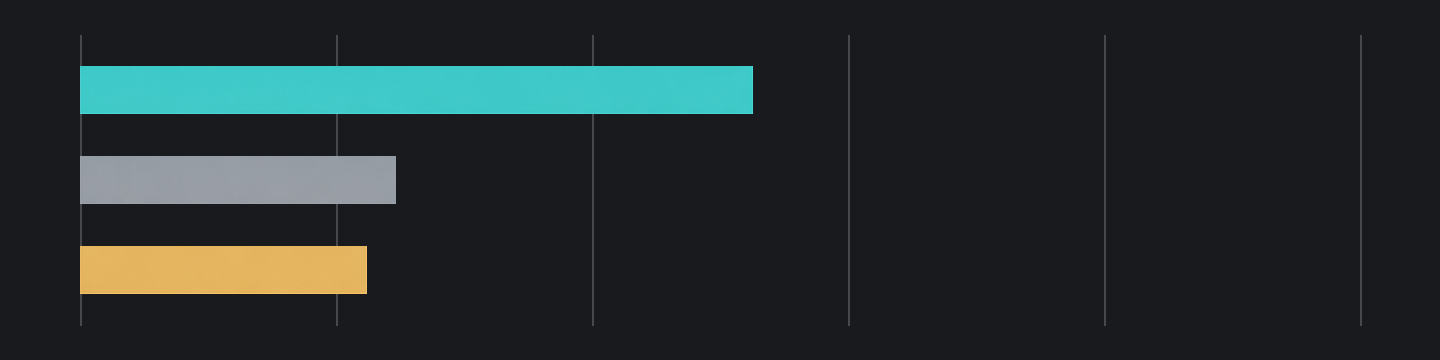
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
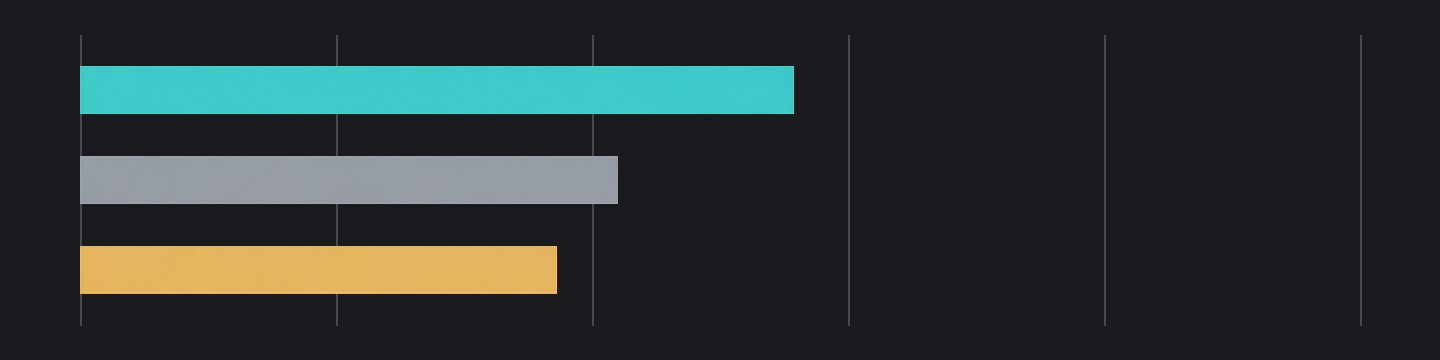
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
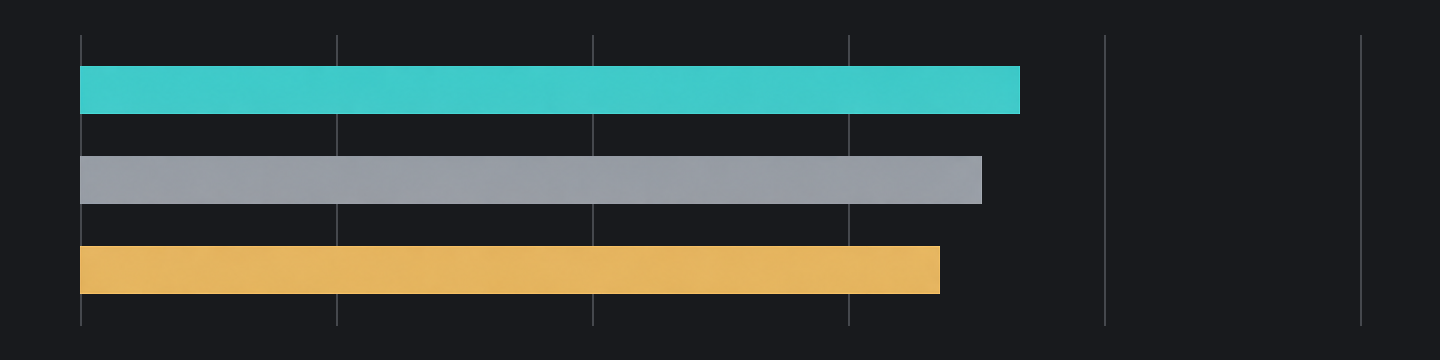
Fable 5.1: 60.9%Fable 5: 57.8%
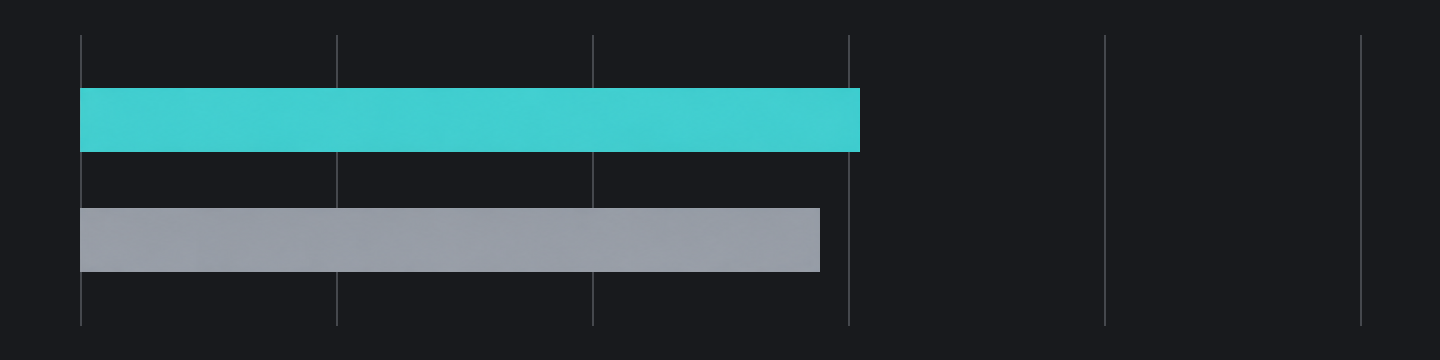
Fable 5.1: 65.0%Fable 5: 63.8%
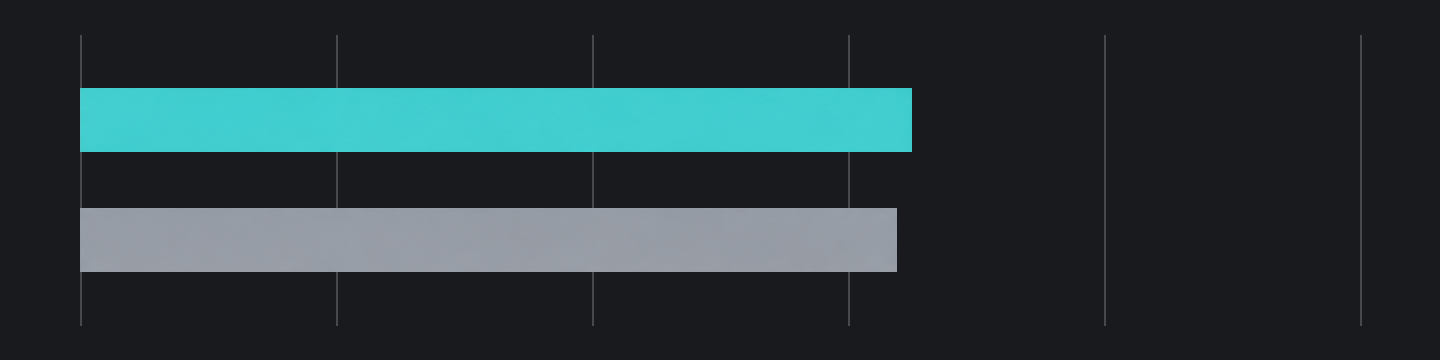
Código: o maior avanço está no terminal
O avanço mais claro do Fable 5.1 está em tarefas de terminal que exigem operar um ambiente, processar resultados e continuar, não em melhora uniforme de toda programação. A Anthropic relata ganhos sobre o Fable 5 de 27.9 pontos percentuais no Terminal-Bench-Science 0.1, 13.8 no Terminal-Bench 4.0 e 2.9 no CursorBench 3.2.0. Isso sugere execução mais forte de tarefas complexas, não um salto uniforme na geração de código.
O valor está em ligar análise e ação prática. A Anthropic descreve desenvolvimento entre bases, escrita independente de testes e verificação visual dos objetivos. Interpretamos isso como maior capacidade de entender, modificar, verificar e refinar a solução, sem parar em uma proposta plausível.
Raciocínio: ganhos menores conforme a configuração
O raciocínio melhorou, mas alguns testes mostram ganhos menores que os de terminal. No Humanity's Last Exam, sem ferramentas sobe dos 57.8% do Fable 5 para 60.9%, e com ferramentas de 63.8% para 65.0%: aumentos de 3.1 e 1.2 pontos percentuais.
Não vemos esforço como um botão em que maior sempre significa mais inteligência. A Anthropic o define como controle principal de capacidade, latência e custo e observa que rótulos iguais entre modelos não representam a mesma quantidade de pensamento.
A comunidade oferece um contraponto útil. O usuário seaurchinzee do Hacker News interpreta a ficha do sistema como indicação de que o esforço máximo não é o melhor no FrontierCode Extended e pode aumentar mudanças não solicitadas. É uma avaliação específica de código, não HLE, mas mostra que mais raciocínio nem sempre significa maior aderência. Escopo importa junto com correção; a orientação da Anthropic trata separadamente mudanças extras e expansão de escopo.
Índice independente e vazão: duas questões distintas
Consideramos que capacidade geral e velocidade do Fable 5.1 devem ser avaliadas separadamente. Na consulta de 4 de outubro de 2026, a Artificial Analysis registra para Max, Default Fallback índice de inteligência 53, cerca de 66.2 tokens de saída por segundo e aproximadamente 259.12 segundos até o primeiro token.
Na mesma tarefa de desenho SVG, high levou cerca de 29.6 segundos e max aproximadamente 13 minutos e 54 segundos. Consideramos melhor o resultado de esforço máximo, mas a espera e o uso de saída aumentaram muito. Nossa conclusão é que raciocínio adicional pode melhorar algumas saídas complexas.
Claude Fable 5.1 em comparação com Fable 5, GPT-5.6 Sol e Kimi K3
A evidência mais direta a favor do Fable 5.1 continua sendo a vantagem no terminal. A tabela abaixo é uma avaliação de lançamento da Anthropic.
Fable 5.1: 53Kimi K3: 44
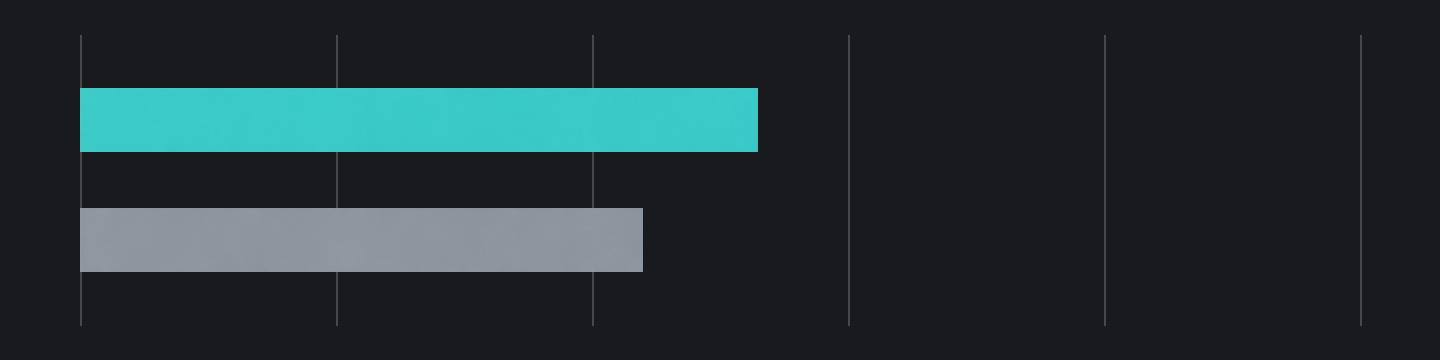
Fable 5.1: 52%Kimi K3: 13%
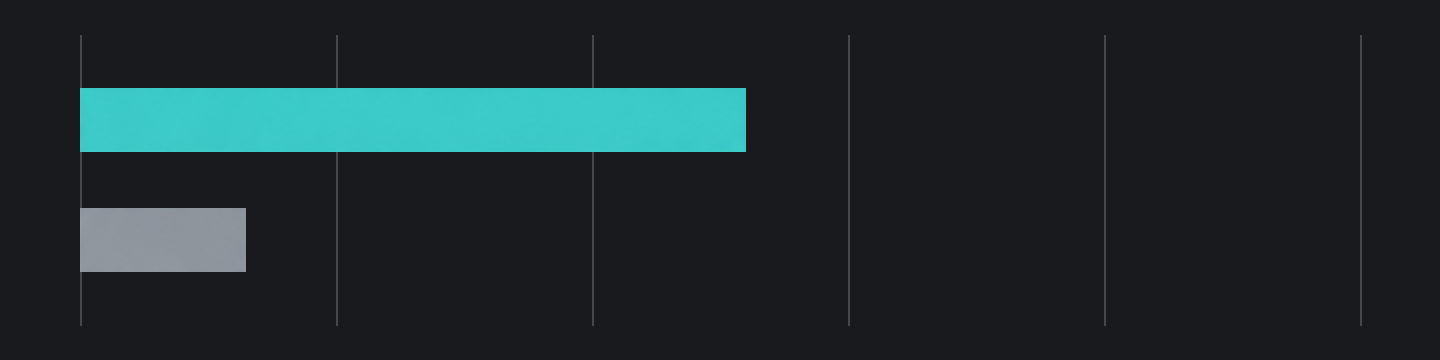
Fable 5.1: 85%Kimi K3: 89%
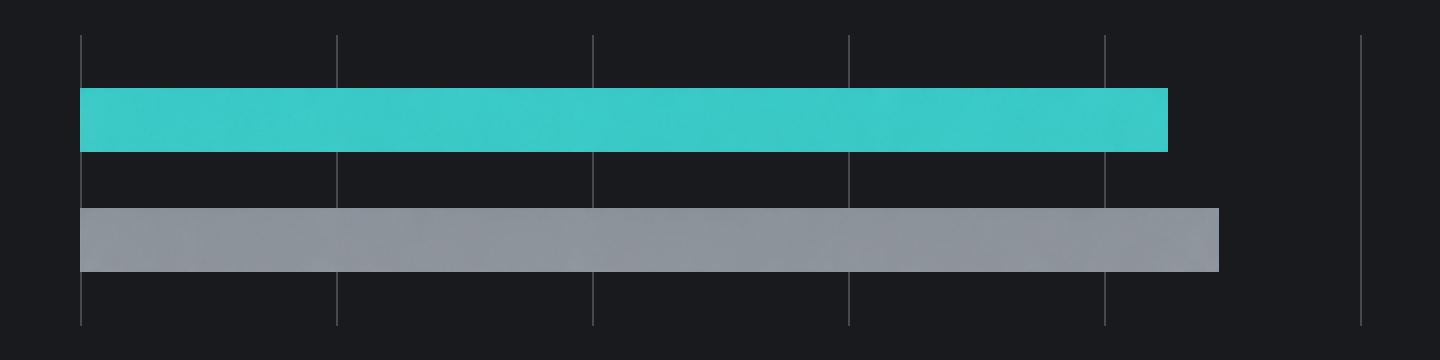
| Teste de referência | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Contra Fable 5 e GPT-5.6 Sol: vantagem mais clara na programação de terminal
As notas mostram vantagem maior do Fable 5.1 sobre o GPT-5.6 Sol nos dois benchmarks de terminal que no CursorBench. Um cliente relatou que o Fable 5.1 igualou ou superou levemente o Fable 5 reduzindo o custo por tarefa, levando-o a adotá-lo na revisão de código.
Contra Kimi K3: raciocínio com documentos longos inverte a classificação
Nossa avaliação favorece o Fable 5.1 na comparação composta. A Artificial Analysis registra índice 53 para o Fable 5.1 e 44 para o Kimi K3, com 52% e 13% no Terminal-Bench 4.0. No AA-LCR v1.1 de contexto longo, a ordem se inverte: Fable 5.1 tem 85% e Kimi K3 89%.
Alguns usuários podem preferir as explicações do Kimi K3 e usá-lo para revisão de código ou compreensão de problemas. Nossa conclusão atual: o Fable 5.1 lidera na capacidade composta, e o Kimi K3 neste teste específico de documentos longos.
Por que usar Claude Fable 5.1 pela API Hop?
Cobrança por uso e otimização de custos do modelo
A cobrança segue as tarifas atuais da API Hop e o uso real. Recarregue conforme necessário.
Modelos de IA e APIs de dados unificados, com acesso a vários modelos em um só lugar
Uma chave API conecta vários modelos de IA e serviços de dados, reduzindo custos de integração e permitindo alternar com um clique. Aplicações de negócios precisam tanto de IA quanto de dados.
Registros de chamadas e controles de acesso, com clareza em cada chamada
Cada chamada API é registrada no painel. Crie chaves API separadas para diferentes aplicações.
Avalie as saídas de acordo com sua tarefa
Use o ID documentado do modelo e os parâmetros aceitos pela API Hop. Avalie as saídas pelos seus critérios de aceitação e confira os registros de uso e metadados antes da produção. Um nome de modelo ou exemplo não garante cada resultado.
Como usar Claude Fable 5.1 na API Hop
Após criar uma chave API no console, siga a documentação para começar com Claude Fable 5.1.
Prepare sua conta e teste online
Entre, confirme seu saldo e crie uma chave API.
Experimente na área de testes
Explore os recursos do modelo na área de testes para encontrar a melhor forma de usá-lo.
Integre Claude Fable 5.1 ao seu negócio
Siga nossa documentação para desenvolvedores para integrar Claude Fable 5.1 ao seu negócio.
Atualizações futuras do modelo
Para mudar para um modelo mais novo, confirme primeiro que seu ID exato aparece no catálogo da sua chave API. Se ele aceitar o mesmo endpoint e os mesmos campos, atualize o ID e teste formatos de resposta, streaming, limites de saída e cobrança antes do tráfego de produção. Para tarefas assíncronas de imagem ou vídeo, verifique também envio, consulta de status e obtenção do resultado.
Perguntas frequentes sobre a API Claude Fable 5.1
Claude Fable 5.1 é o mesmo modelo API que Fable 5?
Não. Claude Fable 5.1 (nome API: claude-fable-5-1) é uma versão atualizada de Claude Fable 5 (nome API: claude-fable-5). Use o parâmetro model correto na chamada API.
Por que thinking está vazio ou a resposta incompleta?
Fable 5.1 nativo usa raciocínio adaptativo por padrão e pode omitir seu texto. Solicitações comuns não precisam de thinking; thinking vazio, por si só, não é uma falha. Se a resposta estiver incompleta, confira o estado de conclusão e o orçamento de saída, deixando espaço para raciocínio e texto final.
Como diagnosticar erros de autenticação, saldo ou acesso?
Siga a documentação de erros da API para diagnosticar o problema.
Posso usar OpenAI Responses para Claude Fable 5.1?
OpenAI Responses não é aceito. Claude tem seu próprio formato Claude Messages; consulte a documentação para detalhes.
Posso forçar uma chamada de ferramenta ou editar uma conversa Messages nativa?
Fable 5.1 nativo não aceita os tipos forçados de tool_choice any ou tool. Tenha cuidado ao reenviar o raciocínio preservado após editar mensagens anteriores. Mantenha intactos os blocos nativos de conteúdo assistant e suas assinaturas nas continuações de ferramentas.
A memória da conversa é permanente?
Não. A API não mantém automaticamente o contexto para solicitações seguintes. Gerencie o histórico e inclua o contexto necessário em cada solicitação. A memória de longo prazo deve ser implementada pela aplicação.
APIs de texto relacionadas
Exemplos de API e parâmetros aceitos de Claude Fable 5.1
Início rápido da API Claude Fable 5.1
claude-fable-5-1model é obrigatório; estes exemplos usam o ID do modelo desta página. Verifique o acesso da sua chave API com GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages exige max_tokens. O orçamento do exemplo é editável, não é um padrão do provedor nem um limite do modelo. O raciocínio pode esgotá-lo antes de responder; ajuste-o à tarefa e confira os custos de saída.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Referência da família e do protocolo
Claude Messages
Documentação completa da APIAPI nativa compatível com Claude Messages. Este endpoint usa as estruturas de requisição e resposta Anthropic Messages, incluindo chamadas de ferramentas e eventos SSE Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages