Извлеките синтетические записи в JSON с полями id, owner, deadline, evidence: [R1] Задача 41: Ana отвечает за исправление экспорта; срок не согласован. [R2] Задача 42: проверка к 15 октября; ответственный не назначен; год не указан. Для отсутствующих значений используйте null, сохраняйте неполные даты. Цитируйте источник в evidence. Не придумывайте год или ответственного. Сверьте каждое поле с записью; это форматирование текста, не операция с базой данных.
API Claude Fable 5.1 для программирования и исследований
Сравните цены API и варианты интеграции Claude Fable 5.1 для многоэтапного программирования и исследований. Изучите рекомендации по рассуждениям и проверьте текстовые промпты онлайн.
Цены и оплата API Claude Fable 5.1
Официальная цена
- Вход
- $10.0000 /M
- Выход
- $50.0000 /M
- Кешированный ввод
- $0.2500 /M
- Запись в кеш (5 мин)
- $12.5000 /M
- Запись в кеш (1 час)
- $20.0000 /M
Цена API Hop Экономия 45%
- Вход
- $5.5000 /M
- Выход
- $27.5000 /M
- Кешированный ввод
- $0.1375 /M
- Запись в кеш (5 мин)
- $6.8750 /M
- Запись в кеш (1 час)
- $11.0000 /M
Справочная цена не проверена независимо. Перед сравнением затрат проверьте актуальные тарифы поставщика, единицы тарификации и применимые условия.
Онлайн-чат Claude Fable 5.1
Настройки модели
Для чего нужна память?
Добавляет завершённые, пригодные для повторного использования реплики этого разговора в следующий запрос, чтобы можно было задавать уточняющие вопросы без повторения контекста.
Что происходит при отключении?Отправляются только новое сообщение и системная инструкция, если она задана. Старые сообщения остаются видимыми; включение памяти снова добавляет подходящие предыдущие реплики.
Это долговременная память?Нет. Это контекст текущего разговора, а не память между разными разговорами. Неудачные, остановленные, обрезанные или непригодные для повторного использования ответы исключаются. Более длинная история может увеличить расход входных токенов и стоимость.
Дополнительные параметры
От 0 символов(0/Без фиксированного лимита)
Фиксированного ограничения на число символов нет; весь запрос ограничен размером запроса и контекстом модели. Это не количество токенов. Диалог

Чем я могу помочь сегодня?
Данных ответа пока нет Готово
Примеры промптов для Claude Fable 5.1
Это оценочные промпты для Claude Fable 5.1, а не записанные ответы модели. Они анализируют только предоставленный текст, не выполняют код, не проверяют рабочие системы и не доказывают качество работы с длинным контекстом. Проверьте цитируемые доказательства и критерии приёмки, а перед промышленным использованием — метаданные ответа и расход.
Используйте только образец: [P1] Исправление экспорта прошло проверки на стенде. [P2] Релиз в пятницу предложен, но не одобрен. [P3] Mei проверит сообщения об ошибках во вторник. [P4] Ответственный за документацию не назначен. Верните таблицу: утверждение, точная цитата, ID абзаца, неопределённость. Одобрен ли рабочий релиз? Кто отвечает за документацию? Недостающие факты неизвестны. Цитаты должны совпадать с образцом; не выводите успех в рабочей среде из стендовых проверок. Этот небольшой образец не проверяет максимальную длину контекста.
Проверьте вымышленную политику платёжного webhook: каждый неудачный POST повторяется трижды, ключ идемпотентности не сохраняется, баланс списывается до отправки ответа. Назовите риски повторных списаний, предложите минимальные изменения и три приёмочных теста. Используйте только эти факты; не предполагается доступ к коду, инструментам или рабочим системам.
Что такое Claude Fable 5.1?
Многоэтапное программирование и исследования
Claude Fable 5.1 — модель Anthropic, выпущенная 1 сентября 2026 года для длительного анализа, многоэтапных задач и взаимодействия с инструментами. Она подходит для сложного программирования и глубоких исследований, а не только быстрых ответов. Нативно поддерживаются текст и изображения на входе, текст на выходе, миллион токенов контекста и до 128K токенов вывода. Нативный API по умолчанию использует high; уровень усилий можно адаптировать.
Попробуйте текстовый чат до интеграции API
Онлайн-инструмент API Hop позволяет быстро попробовать Fable 5.1: войдите, создайте ключ API и внесите немного средств без интеграции или подписки. Отдельный аккаунт Anthropic не нужен, но это не гарантия от ограничений; условия платформы сохраняются. Страница поддерживает текстовые беседы, а не загрузку файлов, просмотр веба или выполнение кода.
Для чего использовать Claude Fable 5.1?
Отладка и проверка кода
Anthropic относит к основным применениям Fable 5.1 разработку между кодовыми базами, ревью и оптимизацию. Предоставьте трассировки, код, среду и воспроизведение: модель может читать ошибки компилятора, стеки и исходники незнакомых библиотек, прослеживать зависимости и предлагать решение. Клиент описал редкое падение, не решённое годами: Fable 5.1 дизассемблировала внешнюю библиотеку, сравнила дампы, нашла дефект в ней и в итоге устранила его.
Можно проверять совместимость интерфейсов, исключения, права, освобождение ресурсов и согласованность данных. Рассматривайте модель как опытного помощника, предлагающего варианты; ответственность за решения остаётся у разработчиков.
Исследования и анализ
Исследования и анализ — ещё одно основное применение. Помимо резюме, Fable 5.1 может выполнять расчёты, наблюдать результаты и менять подход. Клиент сообщил, что оптимизация требовала дополнительных подсказок с Fable 5, но не с Fable 5.1. С поисковыми или информационными инструментами приложения модель может анализировать открытые данные и готовить предложения и оценки; сама текстовая страница не просматривает веб.
Открытые данные могут содержать много шума. Мы советуем формировать надёжные источники на основе знания бизнеса либо использовать API данных API Hop, отобранные инженерной и бизнес-командами.
Написание текстов и проектов документов
Главные улучшения Fable 5.1 в письме — ясность и соблюдение требований, а не просто длина статей. Anthropic рекомендует роль помощника, а не основного автора, и самостоятельную проверку и оценку созданных ИИ текстов.
Anthropic советует указывать аудиторию, нужную читателю информацию или проблему, обязательные сведения и нежелательные выражения. Конкретные цели, структура и примеры скорее дадут полезный черновик, чем просьба о профессиональной статье.
Длинные документы и многошаговый диалог
В сравнении Artificial Analysis общий индекс Fable 5.1 выше Kimi K3, но в AA-LCR v1.1 для длинного контекста результат 85% против 89% у Kimi K3. Настройки: Fable 5.1 Max с Default Fallback и Kimi K3 Max. Значит, в этом конкретном тесте длинных документов лидирует Kimi K3; называть Fable 5.1 сильнейшей здесь нельзя.
После сжатия контекста в длинном процессе могут теряться ограничения, принятые решения и точные детали, как отмечает руководство Anthropic. Если приложение позволяет, сохраняйте существенную информацию в каждом разговоре.
Бенчмарки Claude Fable 5.1: код, рассуждения и скорость
Ниже отдельно представлены оценки Anthropic при запуске и независимые оценки Artificial Analysis. Настройки различаются; ни одна не является измерением API Hop.
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
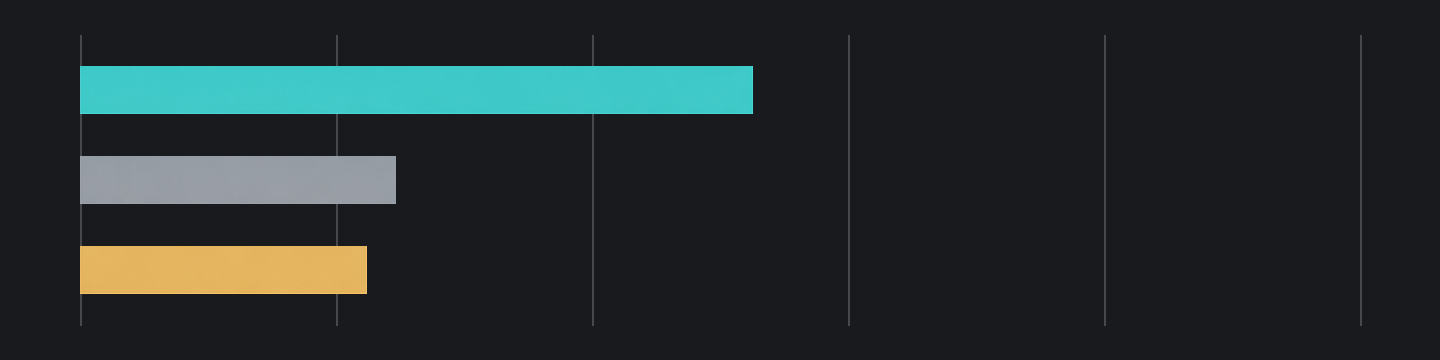
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
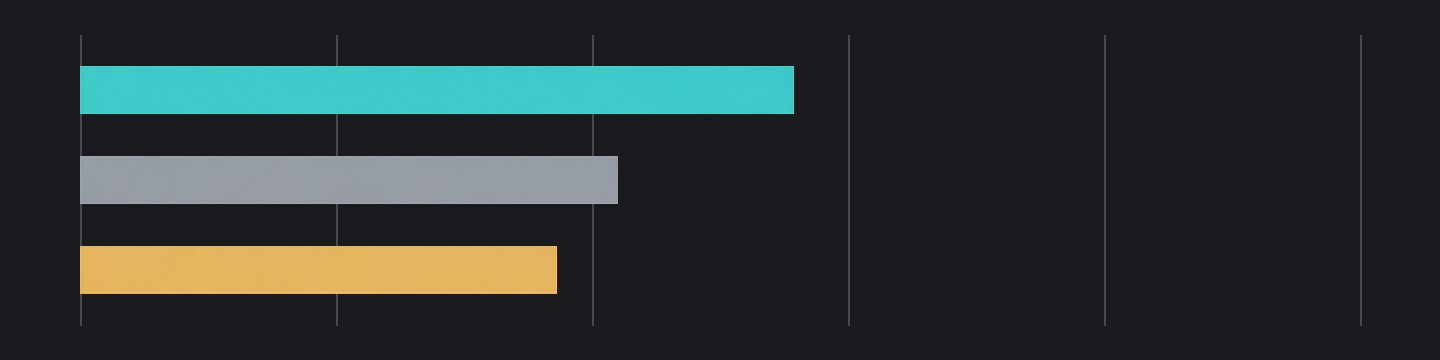
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
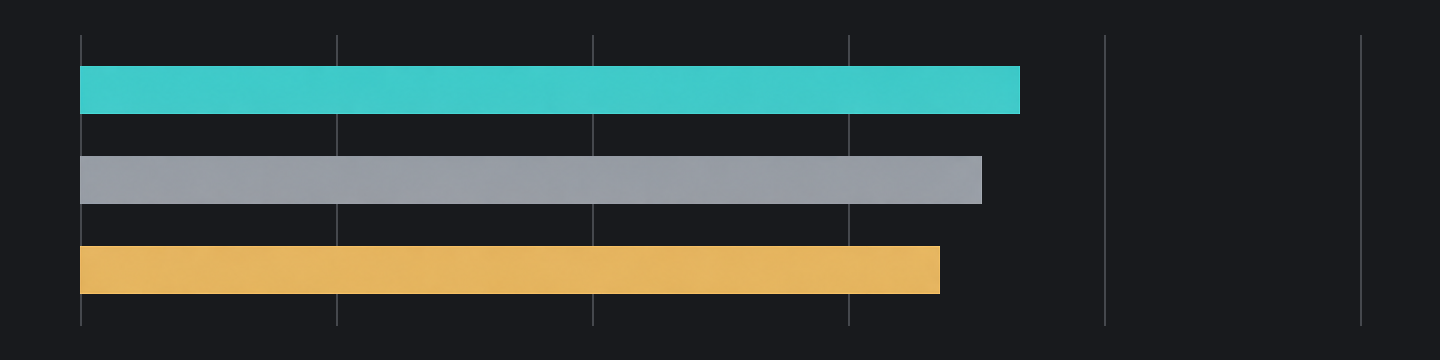
Fable 5.1: 60.9%Fable 5: 57.8%
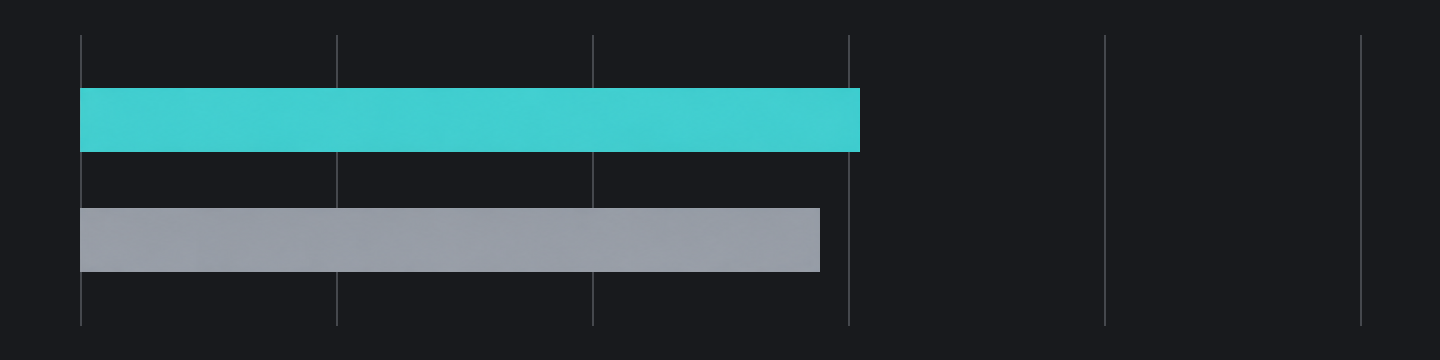
Fable 5.1: 65.0%Fable 5: 63.8%
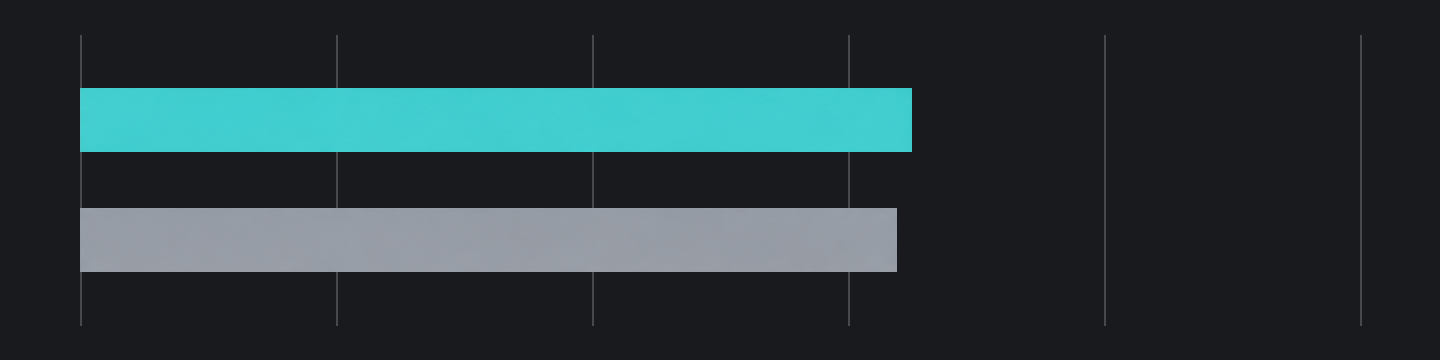
Код: наибольший скачок в работе с терминалом
Самое явное улучшение Fable 5.1 — терминальные задачи, где нужно управлять средой, обрабатывать результаты и продолжать работу, а не равномерный рост во всех задачах кода. Anthropic сообщает прирост к Fable 5 на 27.9 процентного пункта в Terminal-Bench-Science 0.1, 13.8 в Terminal-Bench 4.0 и 2.9 в CursorBench 3.2.0. Это указывает на усиление выполнения сложных задач, а не одинаковый скачок качества генерации кода.
Ценность — в связи анализа с действием. Anthropic описывает разработку между кодовыми базами, самостоятельное написание тестов и визуальную проверку целей реализации. Мы видим в этом способность лучше понимать, менять, проверять и улучшать решение, а не останавливаться на правдоподобном предложении.
Рассуждения: меньший прирост, зависящий от настроек
Рассуждения улучшились, но в некоторых тестах меньше, чем терминальные задачи. В Humanity's Last Exam без инструментов результат растёт с 57.8% у Fable 5 до 60.9%, с инструментами — с 63.8% до 65.0%: прирост 3.1 и 1.2 процентного пункта.
Мы не считаем усилие переключателем «выше — всегда умнее». Anthropic определяет его как основной регулятор возможностей, задержки и стоимости и отмечает, что одинаковые метки у разных моделей не означают одинаковый объём размышлений.
Сообщество приводит полезный контрпример. Пользователь Hacker News seaurchinzee трактует системную карту так: максимальное усилие не лучшее на FrontierCode Extended, а высокие настройки могут увеличивать незапрошенные изменения. Это конкретная оценка кода, не HLE, но больше рассуждений не всегда означает точнее следовать задаче. Наряду с правильностью важен объём; руководство Anthropic отдельно рассматривает лишние изменения и расширение задачи.
Независимый индекс и скорость: разные вопросы
Мы считаем, что общие возможности и скорость Fable 5.1 нужно оценивать отдельно. На 4 октября 2026 года Artificial Analysis фиксирует для Max, Default Fallback индекс интеллекта 53, около 66.2 выходных токенов в секунду и около 259.12 секунды до первого токена.
В одинаковой задаче рисования SVG high занял около 29.6 секунды, max — около 13 минут 54 секунд. Мы считаем результат максимального усилия лучше, но ожидание и расход вывода заметно выросли. Вывод: дополнительные рассуждения могут улучшать некоторые сложные результаты.
Claude Fable 5.1 против Fable 5, GPT-5.6 Sol и Kimi K3
Самое прямое доказательство в пользу Fable 5.1 — преимущество в терминальных задачах. Ниже приведена оценка Anthropic при запуске.
Fable 5.1: 53Kimi K3: 44
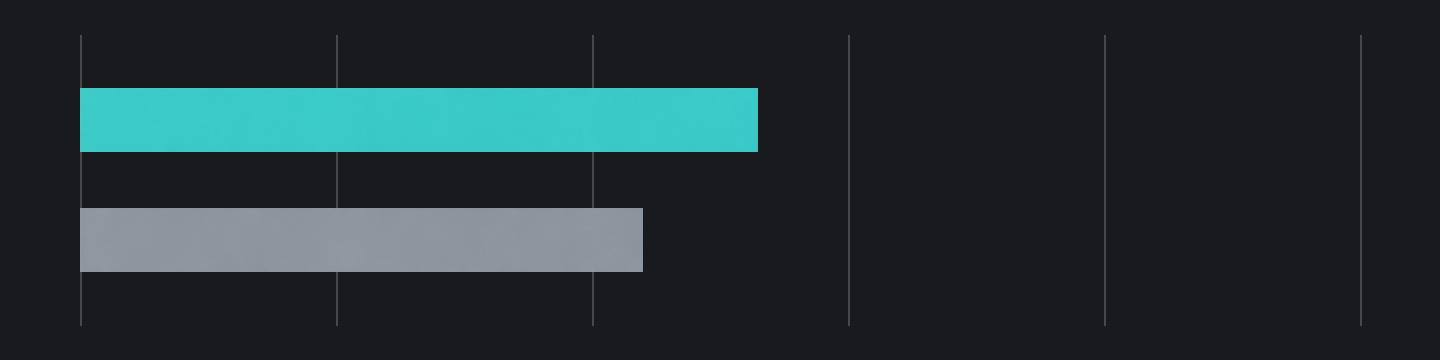
Fable 5.1: 52%Kimi K3: 13%
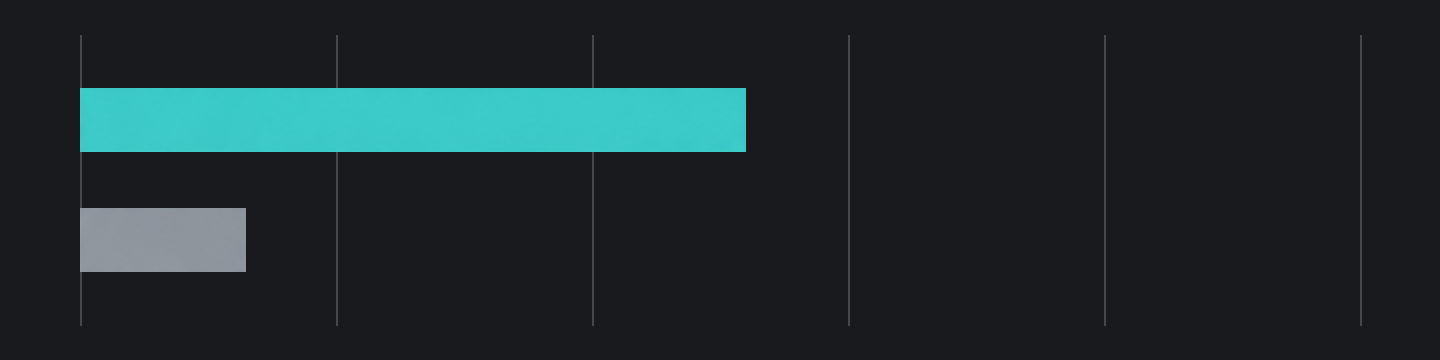
Fable 5.1: 85%Kimi K3: 89%
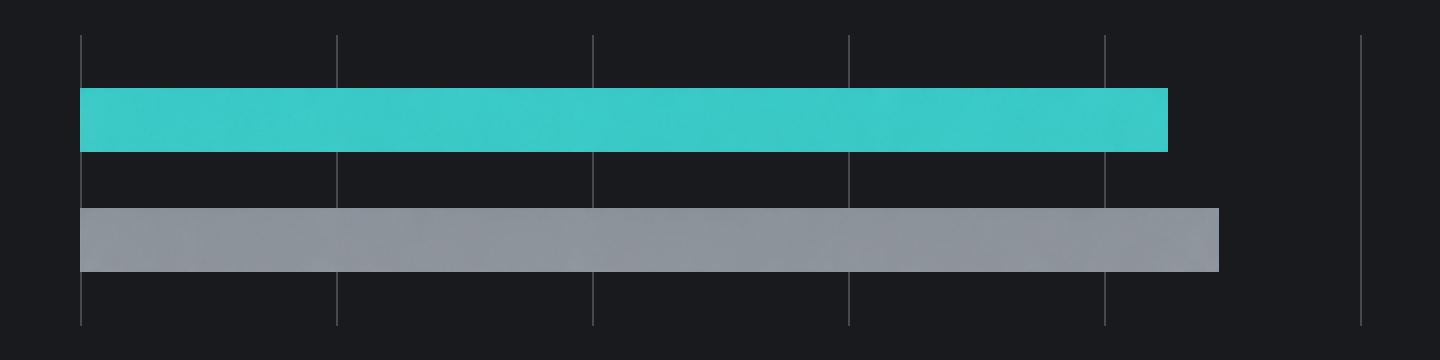
| Бенчмарк | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Против Fable 5 и GPT-5.6 Sol: самое явное преимущество в терминальном кодировании
Баллы показывают большее преимущество Fable 5.1 над GPT-5.6 Sol в двух терминальных бенчмарках, чем в CursorBench. Клиент сообщил, что Fable 5.1 сравнялась с Fable 5 или немного превзошла её при меньшей цене задачи, поэтому её начали использовать для ревью кода.
Против Kimi K3: длинные документы меняют порядок
Мы считаем Fable 5.1 сильнее по общей оценке в этом сравнении. Artificial Analysis указывает индекс 53 для Fable 5.1 и 44 для Kimi K3, а Terminal-Bench 4.0 — 52% и 13%. В AA-LCR v1.1 для длинного контекста порядок обратный: Fable 5.1 — 85%, Kimi K3 — 89%.
Некоторые предпочитают объяснения Kimi K3 и переходят на неё для ревью кода или понимания проблемы. Наш текущий вывод: Fable 5.1 лидирует по совокупным возможностям, Kimi K3 — в этом конкретном тесте длинных документов.
Зачем использовать Claude Fable 5.1 через API Hop?
Оплата по использованию и оптимизация расходов на модель
Стоимость рассчитывается по текущим тарифам API Hop и фактическому использованию. Пополняйте баланс по необходимости.
Единые AI-модели и API данных с доступом к разным моделям в одном месте
Один ключ API подключает несколько AI-моделей и сервисов данных, снижая затраты на интеграцию и позволяя переключаться одним нажатием. Бизнес-приложениям нужны и AI, и данные.
Журналы вызовов и управление доступом приложений для прозрачности каждого запроса
Каждый вызов API записывается в вашей панели. Создавайте отдельные ключи API для разных приложений.
Оценивайте результаты по требованиям задачи
Используйте документированный ID модели и поддерживаемые параметры через API Hop. Оценивайте результаты по своим критериям приёмки, а перед промышленным использованием проверяйте расход и метаданные ответа. Название модели или пример не гарантируют каждый результат.
Как использовать Claude Fable 5.1 на API Hop
Создав ключ API в консоли, следуйте документации, чтобы начать работу с Claude Fable 5.1.
Подготовьте аккаунт и протестируйте онлайн
Войдите, проверьте баланс и создайте ключ API.
Попробуйте в тестовой среде
Изучите возможности модели в тестовой среде, чтобы найти лучший способ её использования.
Интегрируйте Claude Fable 5.1 в свой бизнес
Следуйте нашей документации для разработчиков, чтобы интегрировать Claude Fable 5.1 в свой бизнес.
Будущие обновления модели
Перед переходом на новую модель убедитесь, что каталог для вашего ключа API возвращает её точный ID. Если поддерживаются тот же эндпоинт и поля запроса, обновите ID, затем проверьте форматы ответа, потоковую передачу, лимиты вывода и оплату до переноса рабочего трафика. Для асинхронных задач изображений и видео также проверьте отправку, опрос статуса и получение результата.
Частые вопросы об API Claude Fable 5.1
Claude Fable 5.1 — та же API-модель, что и Fable 5?
Нет. Claude Fable 5.1 (API-имя: claude-fable-5-1) — обновлённая версия Claude Fable 5 (API-имя: claude-fable-5). При вызове API используйте правильный параметр model.
Почему thinking пуст или ответ неполный?
Нативный Fable 5.1 по умолчанию использует адаптивное мышление и может не показывать его текст. Обычным запросам параметр thinking не нужен; пустой thinking сам по себе не означает сбой. Если ответ неполный, проверьте статус завершения и бюджет вывода, оставив достаточно места для мышления и итогового текста.
Как диагностировать ошибки авторизации, баланса или доступа?
Для диагностики следуйте документации об ошибках API.
Можно ли использовать OpenAI Responses для Claude Fable 5.1?
OpenAI Responses не поддерживается. У Claude есть собственный формат Claude Messages; подробности смотрите в документации.
Можно ли принудительно вызвать инструмент или изменить нативный диалог Messages?
Нативный Fable 5.1 не поддерживает принудительные типы tool_choice any и tool. Осторожно повторяйте сохранённое мышление после изменения ранних сообщений. При продолжении работы инструментов сохраняйте нативные блоки assistant и их подписи без изменений.
Память разговора постоянная?
Нет. API не сохраняет контекст разговора для последующих запросов автоматически. Управляйте историей сами и передавайте нужный контекст в каждом запросе. Долгосрочную память должно реализовать ваше приложение.
Связанные текстовые API
Примеры API и поддерживаемые параметры Claude Fable 5.1
Быстрый старт с API Claude Fable 5.1
claude-fable-5-1Поле model обязательно; в примерах используется ID модели этой страницы. Проверьте доступ вашего ключа API через GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages требует max_tokens. Бюджет в примере можно менять; это не значение по умолчанию провайдера и не предел модели. Размышления могут исчерпать его до ответа; настройте его под задачу и проверьте стоимость вывода.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Справочник семейства и протокола
Claude Messages
Полная документация APIНативный API, совместимый с Claude Messages. Этот эндпоинт использует структуры запросов и ответов Anthropic Messages, включая вызовы инструментов и события SSE Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages