Extrae estos registros sintéticos a JSON con id, owner, deadline y evidence: [R1] Incidencia 41: Ana es responsable de corregir la exportación; sin plazo acordado. [R2] Incidencia 42: revisión para el 15 de octubre; sin responsable ni año indicado. Usa null para valores faltantes y conserva fechas parciales. Cita la fuente en evidence. No inventes año ni responsable. Comprueba cada campo contra su registro; es formato de texto, no una operación de base de datos.
API de Claude Fable 5.1 para programación e investigación
Compara precios de la API y opciones de integración de Claude Fable 5.1 para programación e investigación en varias etapas. Revisa la guía de razonamiento y prueba prompts de texto en línea.
Precios y facturación de la API de Claude Fable 5.1
Precio oficial
- Entrada
- $10.0000 /M
- Salida
- $50.0000 /M
- Entrada en caché
- $0.2500 /M
- Escritura en caché (5 min)
- $12.5000 /M
- Escritura en caché (1 h)
- $20.0000 /M
Precio de API Hop Ahorro 45%
- Entrada
- $5.5000 /M
- Salida
- $27.5000 /M
- Entrada en caché
- $0.1375 /M
- Escritura en caché (5 min)
- $6.8750 /M
- Escritura en caché (1 h)
- $11.0000 /M
Precio de referencia no verificado de forma independiente. Consulta las tarifas actuales, unidades de facturación y condiciones aplicables del proveedor antes de comparar costes.
Herramienta de chat en línea de Claude Fable 5.1
Ajustes del modelo
¿Qué hace la memoria?
Incluye los turnos completados y reutilizables de esta conversación en la siguiente solicitud, para hacer preguntas de seguimiento sin repetir el contexto.
¿Qué ocurre al desactivarla?Solo se envían el mensaje nuevo y el prompt del sistema, si lo hay. Los mensajes existentes siguen visibles; al reactivar la memoria se incluyen de nuevo los turnos anteriores válidos.
¿Es memoria a largo plazo?No. Es el contexto de esta conversación, no una memoria entre conversaciones distintas. Se excluyen las respuestas fallidas, detenidas, truncadas o no reutilizables. Más historial puede consumir más tokens de entrada y aumentar el coste.
Parámetros avanzados
0 o más caracteres(0/Sin límite fijo)
Sin límite fijo de caracteres; la solicitud completa está sujeta a los límites de tamaño y de contexto del modelo. No es un recuento de tokens. Conversación

¿En qué puedo ayudarte hoy?
Aún no hay datos de respuesta Listo
Ejemplos de prompts para Claude Fable 5.1
Estos son prompts de evaluación para Claude Fable 5.1, no salidas registradas. Solo analizan el texto proporcionado; no ejecutan código, inspeccionan sistemas de producción ni demuestran rendimiento con contextos largos. Comprueba las citas y los criterios de aceptación, y revisa los metadatos y el uso antes de utilizar el resultado en producción.
Usa solo este documento: [P1] La corrección de exportación pasó las comprobaciones de preproducción. [P2] Se propuso publicar el viernes, sin aprobación. [P3] Mei revisará los mensajes de error el martes. [P4] La documentación no tiene responsable. Devuelve una tabla de afirmación, cita exacta de apoyo, ID de párrafo e incertidumbre. ¿Está aprobado publicar en producción? ¿Quién lleva la documentación? Marca los hechos faltantes como desconocidos. Toda cita debe coincidir con el ejemplo; no deduzcas éxito en producción por preproducción. Este pequeño ejemplo no prueba la longitud máxima de contexto.
Revisa esta política ficticia de webhook de pago: cada POST fallido se reintenta tres veces, no se guarda clave de idempotencia y se descuenta el saldo antes de responder. Identifica riesgos de cobro duplicado, propón cambios mínimos y tres pruebas de aceptación. Usa solo estos hechos; no supongas acceso a código, herramientas ni sistemas de producción.
¿Qué es Claude Fable 5.1?
Programación e investigación de varios pasos
Claude Fable 5.1 es un modelo de Anthropic publicado el 1 de septiembre de 2026, centrado en análisis sostenido, tareas de varios pasos y colaboración con herramientas. Es adecuado para problemas complejos de programación e investigación profunda, no solo respuestas rápidas. Sus especificaciones nativas admiten texto e imágenes de entrada, texto de salida, un millón de tokens de contexto y hasta 128K tokens de salida. La API nativa usa esfuerzo high por defecto y permite adaptarlo a la tarea.
Pruebe el chat antes de integrar la API
La herramienta de API Hop permite probar Fable 5.1 rápidamente: inicie sesión, cree una clave API y añada un poco de crédito, sin integrar la API ni contratar suscripción. No necesita otra cuenta de Anthropic, pero eso no garantiza ausencia de restricciones; siguen vigentes los términos de la plataforma. Esta página ofrece texto, no subida de archivos, navegación web ni ejecución de código.
¿Para qué puede usar Claude Fable 5.1?
Depuración y revisión de código
Anthropic incluye desarrollo entre bases de código, revisión y rendimiento entre los usos principales de Fable 5.1. Aporte trazas, código, entorno y pasos de reproducción: puede leer errores del compilador, pilas y fuentes de bibliotecas desconocidas para seguir dependencias y proponer soluciones. Un cliente relató un fallo infrecuente sin resolver del todo durante años: Fable 5.1 desensambló una biblioteca externa, comparó volcados y encontró el defecto en esa biblioteca, resolviéndolo finalmente.
También puede revisar compatibilidad, rutas de excepción, permisos, liberación de recursos y coherencia de datos. Trátelo como un asistente experimentado que propone opciones; la responsabilidad sigue siendo de los desarrolladores.
Investigación y análisis
La investigación es otro uso central. Además de resumir, Fable 5.1 puede desarrollar cálculos, observar resultados y ajustar su enfoque. Un cliente indicó que una optimización requería más indicaciones con Fable 5, pero ya no con Fable 5.1. Con herramientas de búsqueda o datos proporcionadas por la aplicación puede analizar datos públicos y preparar propuestas y evaluaciones; esta página de texto no navega por la web.
Los datos públicos pueden contener mucho ruido. Sugerimos fuentes fiables según su conocimiento del negocio o las API de datos API Hop seleccionadas por nuestros equipos técnicos y comerciales.
Redacción y borradores de documentos
Las principales mejoras de escritura de Fable 5.1 son claridad y cumplimiento de requisitos, no solo artículos más largos. Anthropic recomienda mantenerlo como asistente y no autor principal, y seguir revisando y juzgando personalmente el contenido generado.
Anthropic recomienda especificar audiencia, información o problema que necesita el lector, contenido obligatorio y expresiones prohibidas. Objetivos, estructura y ejemplos concretos producen mejor borrador que pedir simplemente un artículo profesional.
Documentos largos y conversación de varios turnos
En Artificial Analysis, Fable 5.1 supera a Kimi K3 en el índice compuesto, pero obtiene 85% frente al 89% de Kimi K3 en AA-LCR v1.1 de contexto largo. Las configuraciones son Fable 5.1 Max con Default Fallback y Kimi K3 Max. Kimi K3 lidera esta prueba específica; no permite llamar a Fable 5.1 el mejor modelo para documentos largos.
Tras compactar el contexto en flujos largos pueden perderse restricciones, decisiones o detalles precisos, como explica Anthropic. Si su aplicación lo permite, sugerimos conservar la información esencial en cada conversación.
Benchmarks de Claude Fable 5.1: código, razonamiento y velocidad
Las evaluaciones de lanzamiento de Anthropic y las independientes de Artificial Analysis se presentan por separado. Sus configuraciones difieren y ninguna es una medición de API Hop.
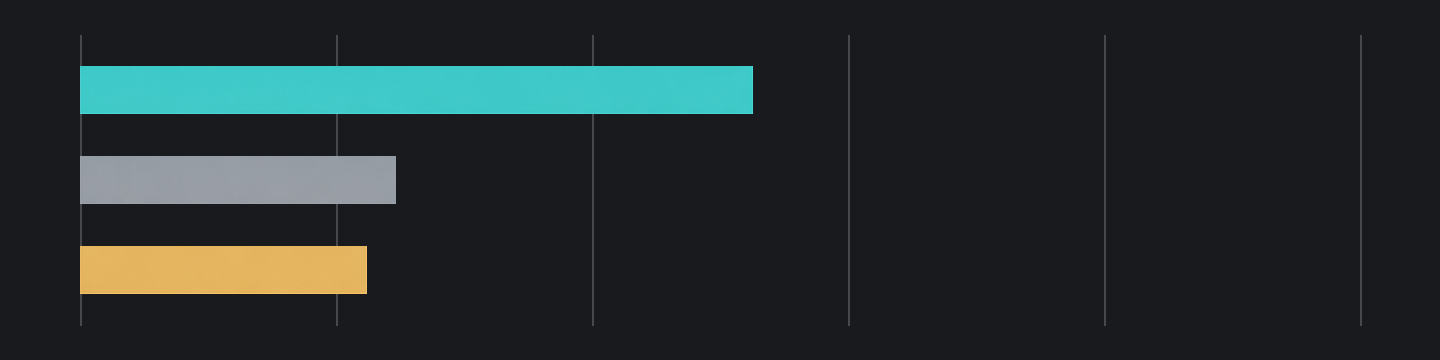
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
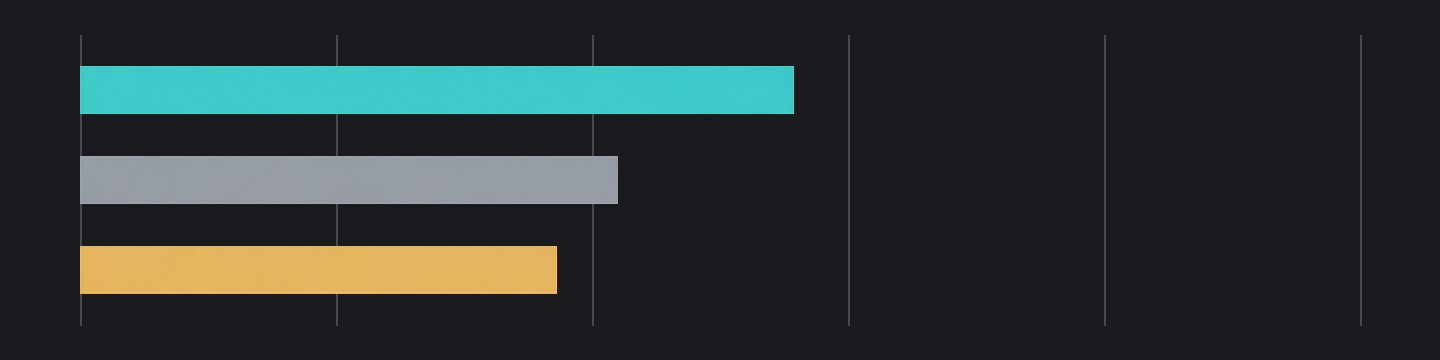
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
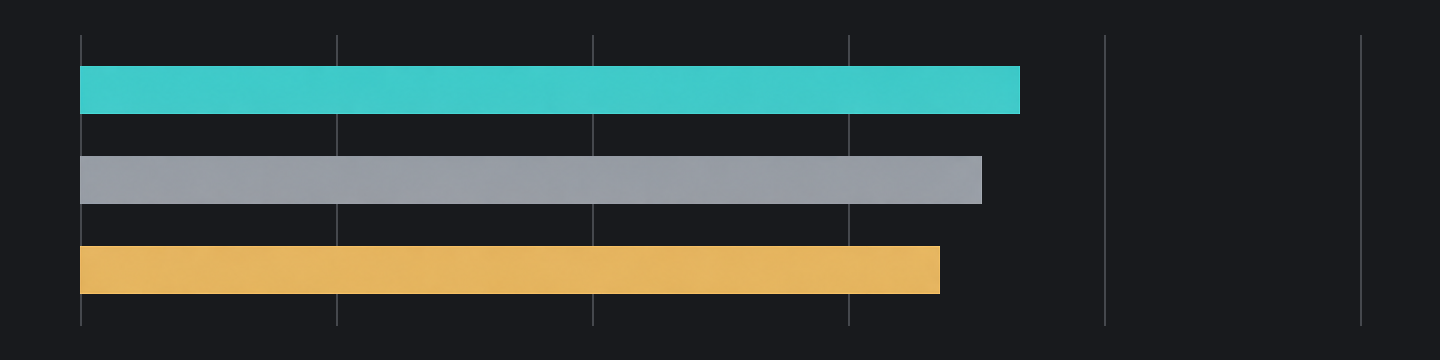
Fable 5.1: 60.9%Fable 5: 57.8%
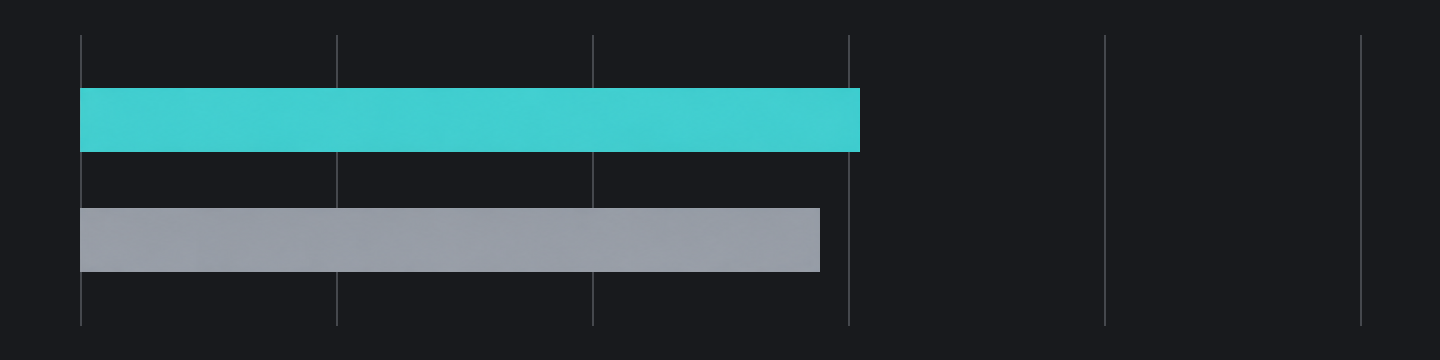
Fable 5.1: 65.0%Fable 5: 63.8%
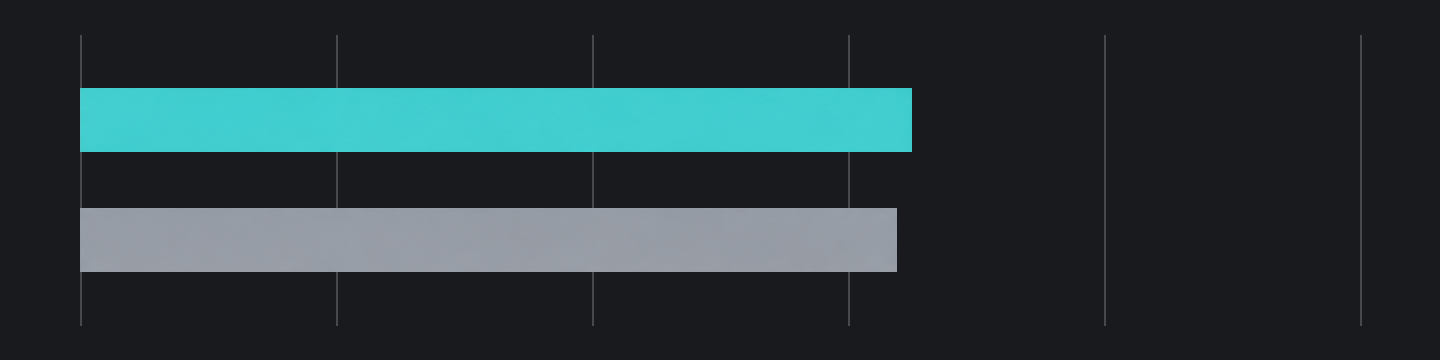
Código: el mayor salto está en el terminal
La mejora más clara de Fable 5.1 está en tareas de terminal que exigen operar un entorno, procesar resultados y continuar, no en un avance medio uniforme. Anthropic informa mejoras sobre Fable 5 de 27.9 puntos porcentuales en Terminal-Bench-Science 0.1, 13.8 en Terminal-Bench 4.0 y 2.9 en CursorBench 3.2.0. Sugieren mejor ejecución compleja, no un salto uniforme en generación de código.
El valor está en conectar análisis y acción práctica. Anthropic describe desarrollo entre bases de código, escritura autónoma de pruebas y comprobación visual de objetivos. Interpretamos una mejor capacidad de entender, modificar, verificar y refinar soluciones, no detenerse en propuestas plausibles.
Razonamiento: mejoras menores según configuración
El razonamiento mejora, pero algunas pruebas muestran menos avance que el terminal. En Humanity's Last Exam, sin herramientas sube del 57.8% de Fable 5 al 60.9%, y con herramientas del 63.8% al 65.0%: aumentos de 3.1 y 1.2 puntos porcentuales.
No vemos el esfuerzo como un interruptor donde más siempre significa más inteligencia. Anthropic lo define como control principal de capacidad, latencia y coste, y advierte que etiquetas iguales entre modelos no equivalen a la misma cantidad de razonamiento.
La comunidad aporta un contraejemplo. El usuario seaurchinzee de Hacker News interpreta la ficha del sistema como indicación de que el esfuerzo máximo no rinde mejor en FrontierCode Extended y puede aumentar cambios no solicitados. Es una evaluación de código, no HLE, pero muestra que más razonamiento no siempre implica mayor adherencia. El alcance importa junto con la corrección; Anthropic trata aparte cambios adicionales y ampliación de alcance.
Índice independiente y velocidad: dos cuestiones distintas
Creemos que capacidad global y velocidad de Fable 5.1 deben evaluarse por separado. Al comprobarlo el 4 de octubre de 2026, Artificial Analysis registra para Max, Default Fallback un índice de inteligencia de 53, unos 66.2 tokens de salida por segundo y unos 259.12 segundos al primer token.
En la misma tarea SVG, high tardó unos 29.6 segundos y max unos 13 minutos y 54 segundos. Consideramos mejor el resultado de esfuerzo máximo, pero aumentaron mucho espera y uso de salida. Concluimos que el razonamiento adicional puede mejorar algunas salidas complejas.
Claude Fable 5.1 frente a Fable 5, GPT-5.6 Sol y Kimi K3
La evidencia más directa a favor de Fable 5.1 sigue siendo su ventaja en terminal. La tabla siguiente procede de una evaluación de lanzamiento de Anthropic.
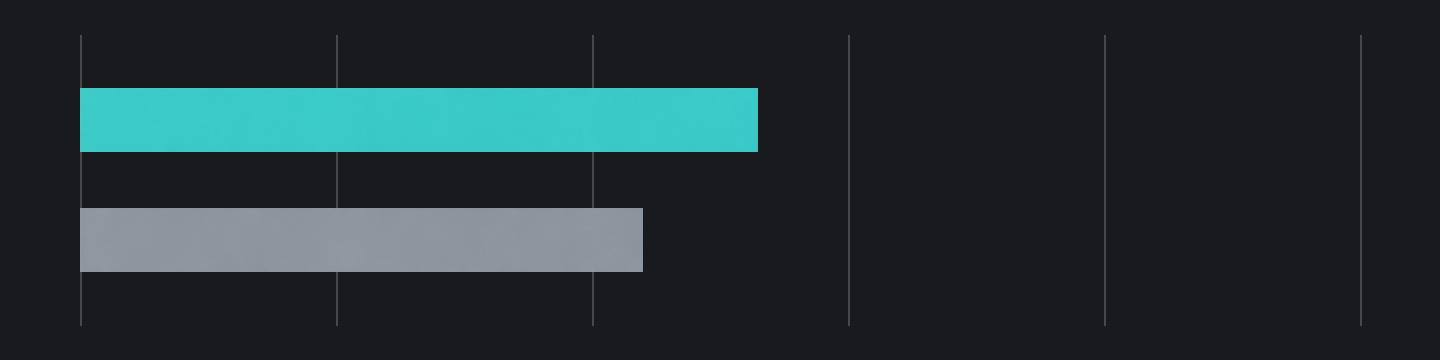
Fable 5.1: 53Kimi K3: 44
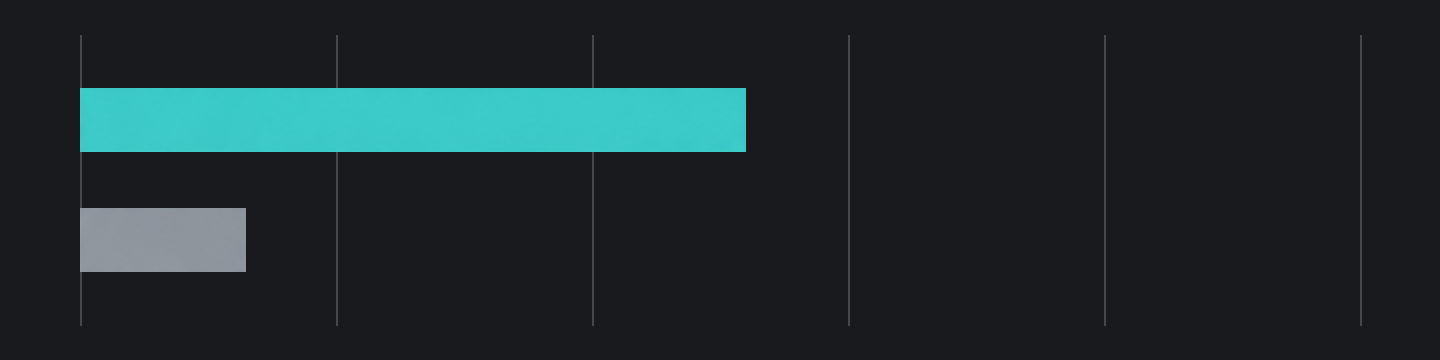
Fable 5.1: 52%Kimi K3: 13%
Fable 5.1: 85%Kimi K3: 89%
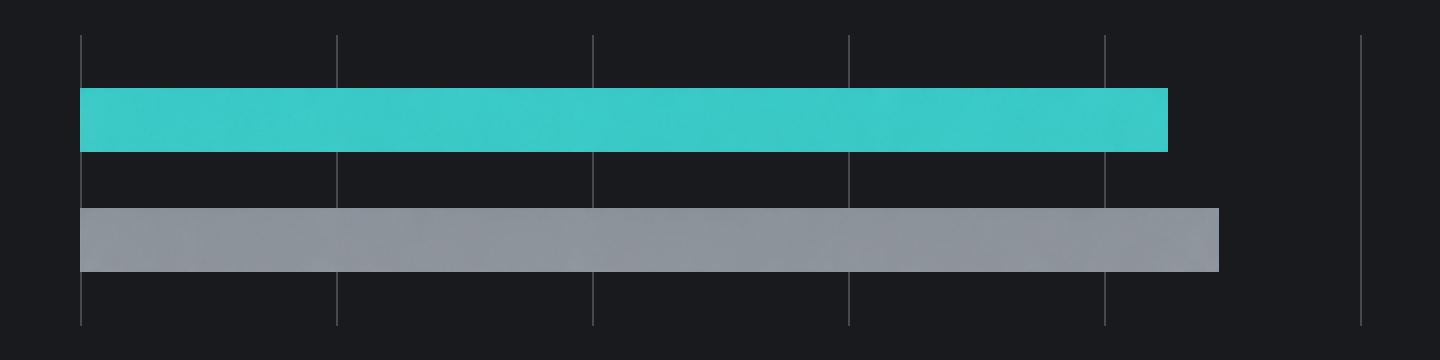
| Prueba de referencia | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Frente a Fable 5 y GPT-5.6 Sol: ventaja más clara en programación de terminal
Las puntuaciones muestran mayor ventaja de Fable 5.1 sobre GPT-5.6 Sol en los dos benchmarks de terminal que en CursorBench. Un cliente informó que Fable 5.1 igualó o superó ligeramente a Fable 5 con menor coste por tarea, por lo que empezó a usarlo en revisión de código.
Frente a Kimi K3: el razonamiento con documentos largos invierte el orden
Nuestra valoración favorece a Fable 5.1 en la evaluación compuesta. Artificial Analysis registra índice 53 para Fable 5.1 y 44 para Kimi K3, con 52% y 13% en Terminal-Bench 4.0. En AA-LCR v1.1 de contexto largo se invierte: Fable 5.1 obtiene 85% y Kimi K3 89%.
Algunos usuarios prefieren las explicaciones de Kimi K3 y lo eligen para revisar código o entender un problema. Nuestra conclusión actual: Fable 5.1 lidera en capacidad compuesta, Kimi K3 en esta prueba específica de documentos largos.
¿Por qué usar Claude Fable 5.1 mediante API Hop?
Facturación por uso y optimización del coste del modelo
Los cargos siguen las tarifas actuales de API Hop y el uso real. Recarga cuando lo necesites.
Modelos de IA y API de datos unificados, con acceso a varios modelos en un solo lugar
Una clave API conecta varios modelos de IA y servicios de datos, reduce los costes de integración y permite cambiar con un clic. Las aplicaciones empresariales necesitan tanto IA como datos.
Registros de llamadas y controles de acceso, con claridad en cada llamada
Cada llamada API se registra en tu panel. Crea claves API distintas para diferentes aplicaciones.
Evalúa las salidas según tu tarea
Usa el ID del modelo documentado y los parámetros admitidos mediante API Hop. Evalúa las salidas según tus criterios de aceptación y revisa los registros de uso y metadatos antes de producción. Un nombre de modelo o un ejemplo no garantiza cada resultado.
Cómo usar Claude Fable 5.1 en API Hop
Tras crear una clave API en la consola, sigue la documentación para empezar con Claude Fable 5.1.
Prepara tu cuenta y prueba en línea
Inicia sesión, confirma tu saldo y crea una clave API.
Pruébalo en el área de pruebas
Explora las capacidades del modelo en el área de pruebas para encontrar la mejor forma de usarlo.
Integra Claude Fable 5.1 en tu negocio
Sigue nuestra documentación para desarrolladores para integrar Claude Fable 5.1 en tu negocio.
Futuras actualizaciones del modelo
Para cambiar a un modelo nuevo, confirma primero que su ID exacto aparece en el catálogo de tu clave API. Si admite el mismo endpoint y campos, actualiza el ID y prueba los formatos de respuesta, streaming, límites de salida y facturación antes de enviar tráfico de producción. Para tareas asíncronas de imagen o vídeo, verifica también el envío, el sondeo de estado y la obtención del resultado.
Preguntas frecuentes sobre la API de Claude Fable 5.1
¿Es Claude Fable 5.1 el mismo modelo API que Fable 5?
No. Claude Fable 5.1 (nombre API: claude-fable-5-1) es una versión mejorada de Claude Fable 5 (nombre API: claude-fable-5). Usa el parámetro model correcto al llamar a la API.
¿Por qué thinking está vacío o la respuesta incompleta?
Fable 5.1 nativo usa razonamiento adaptativo por defecto y puede omitir su texto. Las solicitudes normales no necesitan thinking; que esté vacío no indica por sí solo un fallo. Si la respuesta está incompleta, revisa el estado de finalización y el presupuesto de salida, dejando espacio para razonamiento y texto final.
¿Cómo diagnostico errores de autenticación, saldo o acceso?
Sigue la documentación de errores de API para diagnosticar el problema.
¿Puedo usar OpenAI Responses para Claude Fable 5.1?
OpenAI Responses no es compatible. Claude tiene su propio formato Claude Messages; consulta la documentación para más detalles.
¿Puedo forzar una llamada a herramienta o editar una conversación nativa de Messages?
Fable 5.1 nativo no admite los tipos forzados de tool_choice any o tool. Ten cuidado al reproducir el razonamiento conservado tras editar mensajes anteriores. Mantén intactos los bloques nativos de contenido assistant y sus firmas durante la continuación de herramientas.
¿La memoria de conversación es permanente?
No. La API no conserva automáticamente el contexto para solicitudes posteriores. Gestiona el historial e incluye el contexto necesario en cada solicitud. Tu aplicación debe implementar la memoria a largo plazo.
API de texto relacionadas
Ejemplos de API y parámetros admitidos de Claude Fable 5.1
Inicio rápido de la API de Claude Fable 5.1
claude-fable-5-1model es obligatorio; estos ejemplos usan el ID del modelo de esta página. Comprueba el acceso de tu clave API con GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages requiere max_tokens. El presupuesto del ejemplo se puede editar; no es el valor predeterminado del proveedor ni un límite del modelo. El razonamiento puede agotarlo antes de responder; ajústalo a tu tarea y revisa los costes de salida.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Referencia de la familia y el protocolo
Claude Messages
Documentación completa de la APIAPI nativa compatible con Claude Messages. Este endpoint usa los formatos de solicitud y respuesta de Anthropic Messages, incluidas las llamadas a herramientas y los eventos SSE de Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages