次の合成記録を id、owner、deadline、evidence の JSON に抽出してください:[R1] 課題 41:Ana がエクスポート修正を担当、期限は未合意。[R2] 課題 42:確認期限は 10 月 15 日、担当者未定、年は不明。欠損値には null を使い、不完全な日付をそのまま保ち、evidence に原文を引用してください。年や担当者を作らず、各フィールドを記録と照合してください。これはテキスト整形であり、データベース操作ではありません。
コーディングと調査向け Claude Fable 5.1 API
多段階のコーディングと調査に向け、Claude Fable 5.1 API の料金と導入方法を比較できます。推論ガイドを確認し、テキストプロンプトをオンラインで試せます。
Claude Fable 5.1 API の料金と請求
公式価格
- 入力
- $10.0000 /M
- 出力
- $50.0000 /M
- キャッシュ入力
- $0.2500 /M
- キャッシュ書き込み(5 分)
- $12.5000 /M
- キャッシュ書き込み(1 時間)
- $20.0000 /M
API Hop 料金 削減 45%
- 入力
- $5.5000 /M
- 出力
- $27.5000 /M
- キャッシュ入力
- $0.1375 /M
- キャッシュ書き込み(5 分)
- $6.8750 /M
- キャッシュ書き込み(1 時間)
- $11.0000 /M
参考価格は独立した検証を行っていません。費用を比較する前に、提供元の最新料金、課金単位、適用条件を確認してください。
Claude Fable 5.1 オンラインチャットツール
モデル設定
メモリの役割は?
この会話の完了済みで再利用可能なやり取りを次のリクエストに含めるため、背景を繰り返さずに追加の質問ができます。
オフにするとどうなりますか?新しいメッセージと設定済みのシステムプロンプトのみを送信します。既存のメッセージは表示されたままで、再度オンにすると利用可能な過去のやり取りが再び含まれます。
長期メモリですか?いいえ。現在の会話の文脈であり、別の会話には引き継がれません。失敗、停止、切り詰め、再利用不可の応答は含まれません。履歴が増えると入力トークン数と料金が増える場合があります。
詳細パラメーター
0 文字以上(0/固定上限なし)
固定の文字数上限はありません。リクエスト全体にはリクエストサイズとモデルのコンテキスト制限が適用されます。これはトークン数ではありません。 会話

今日はどのようなお手伝いができますか?
応答データはまだありません 準備完了
Claude Fable 5.1 のプロンプト例
これらは Claude Fable 5.1 の評価用プロンプトであり、実測したモデル出力ではありません。提供されたテキストだけを分析し、コードの実行、本番システムの検査、長文コンテキスト性能の証明は行いません。引用した根拠と受け入れ条件を確認し、本番で使用する前にレスポンスのメタデータと使用量を確認してください。
次の文書例だけを使用してください:[P1] エクスポート修正はステージング検査を通過した。[P2] 金曜の公開が提案されたが承認されていない。[P3] Mei は火曜にエラーメッセージを確認する。[P4] 文書の担当者は未定。主張、裏付ける正確な引用、段落 ID、不確実性を表にしてください。本番公開は承認済みですか。文書の担当者は誰ですか。不足情報は不明とし、引用は例と完全に一致させてください。ステージングの成功から本番の成功を推測しないでください。この小さな例は最大コンテキスト長を試すものではありません。
架空の決済 Webhook 方針を検討してください:失敗した POST は毎回 3 回再試行し、冪等性キーは保存せず、応答送信前に残高を引き落とします。二重請求のリスクを挙げ、最小限の変更と 3 つの受け入れテストを提案してください。この事実のみを使い、コード、ツール、本番システムへのアクセスがあるとは仮定しないでください。
Claude Fable 5.1 とは?
複数段階のコーディングと調査
Claude Fable 5.1 は Anthropic が 2026年9月1日に公開した、継続的な分析、複数段階の作業、ツールとの連携を重視するモデルです。素早い回答だけでなく、深い思考が必要な複雑な開発問題や詳しい研究に適します。ネイティブ仕様はテキスト・画像入力、テキスト出力、100 万トークンのコンテキスト、最大 128K 出力トークンに対応します。ネイティブ API の既定強度は high で、タスクに応じて調整できます。
API 統合前にテキストチャットを試す
API Hop のオンラインツールなら、ログインして API キーを作り少額を入金するだけで、API 統合や定額契約なしに Fable 5.1 を評価できます。別の Anthropic アカウントは不要ですが、アカウント制限がない保証ではなく、適用される利用規約には従います。このページはテキスト対話に対応し、ファイル送信、Web 閲覧、コード実行には対応しません。
Claude Fable 5.1 で何ができるか
デバッグとコードレビュー
Anthropic は Fable 5.1 の主要用途として、コードベースをまたぐ開発、レビュー、性能改善を挙げています。エラートレース、関連コード、環境、再現手順を渡すと、コンパイラエラー、スタック、未知のライブラリのソースを読み、依存関係を追って解決策を提案できます。ある顧客は、何年も完全解決できなかったまれなクラッシュについて、Fable 5.1 が外部ライブラリを逆アセンブルし、ダンプを比較してライブラリの欠陥を特定し、解決したと報告しました。
インターフェース互換性、例外経路、権限確認、リソース解放、データ整合性も確認できます。選択肢を提案する経験豊富な補助役として扱い、判断の責任は開発者が持ちます。
調査と分析
調査と分析も主要用途です。Fable 5.1 は要約に加えて、問いに沿った計算を進め、結果を観察し、方法を調整できます。ある顧客は Fable 5 で追加指示が必要だった最適化が、Fable 5.1 では不要になったと報告しています。アプリが検索やデータツールを提供すれば、公開データの分析や目的に応じた提案・評価ができますが、このテキストページ自体は Web を閲覧しません。
公開データには多くのノイズが含まれます。事業への理解を基に信頼できる情報源を整えるか、当社の技術・事業チームが選んだ API Hop データ API の利用を勧めます。
文章執筆と文書の草案
Fable 5.1 の文章改善は単なる長文化ではなく、明確な表現と執筆要件への適合です。Anthropic はモデルを主著者ではなく補助役に置き、生成内容を自分で確認・判断し続けるよう勧めています。
Anthropic は読者、読者が求める情報や解決したい問題、必須の情報、避ける表現を指定するよう勧めています。具体的な目的、構成、例があれば、単に専門的な記事を頼むより役立つ草案になりやすくなります。
長文書と複数ターンの対話
Artificial Analysis の比較では Fable 5.1 の総合指数は Kimi K3 より高いものの、長文脈推論 AA-LCR v1.1 は 85%、Kimi K3 は 89% です。設定は Fable 5.1 が Max、Default Fallback、Kimi K3 が Max です。この特定の長文書テストでは Kimi K3 が上回り、Fable 5.1 を最強の長文書モデルとする根拠にはなりません。
Anthropic のプロンプト指針にもあるように、長い作業でコンテキストを圧縮すると、重要な制約、確定した判断、正確な詳細が失われる場合があります。アプリで実装できるなら、各会話に必須情報を保持することを勧めます。
Claude Fable 5.1 の評価:コーディング、推論、速度
以下では Anthropic の公開時評価と Artificial Analysis の独立評価を分けます。設定は異なり、いずれも API Hop の測定ではありません。
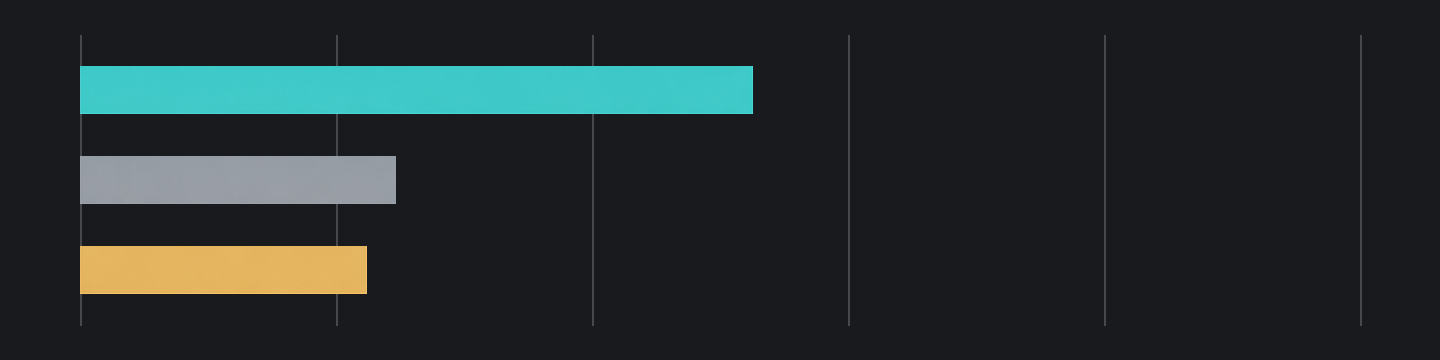
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
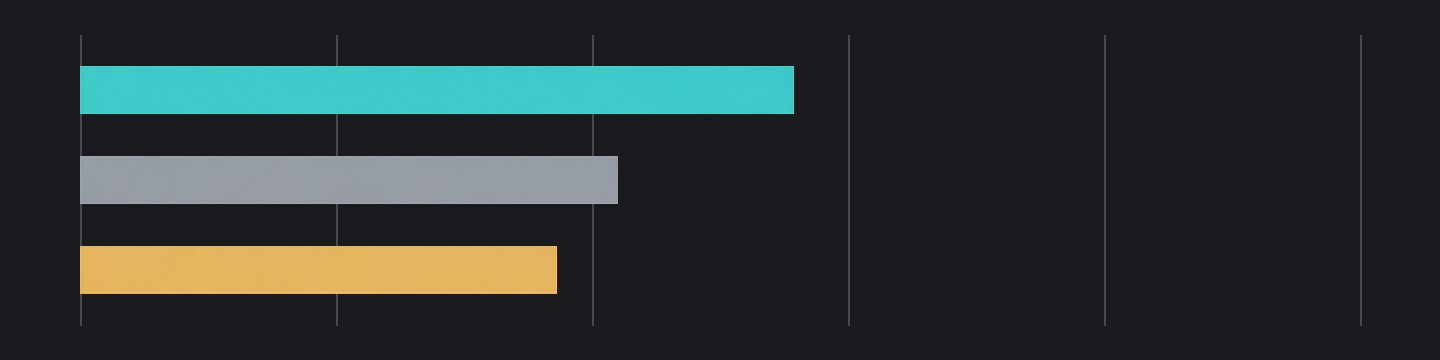
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
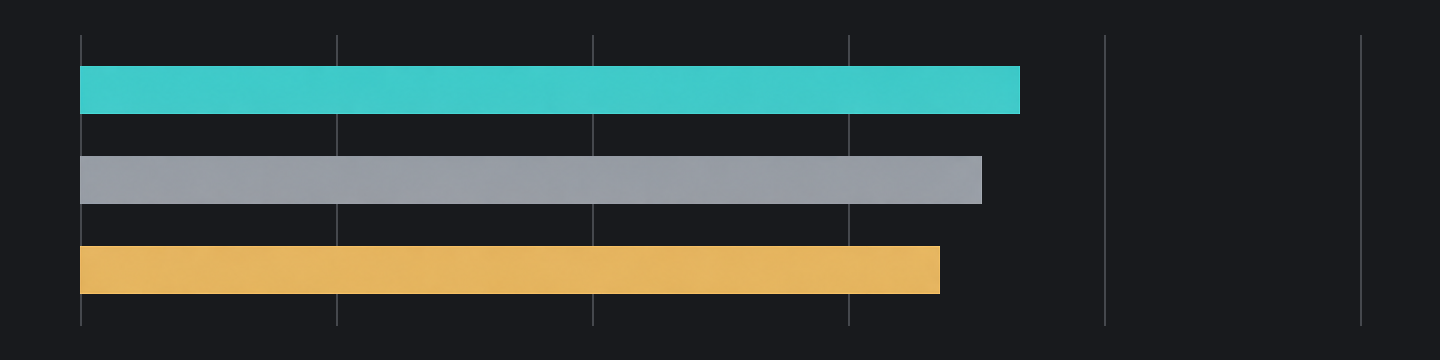
Fable 5.1: 60.9%Fable 5: 57.8%
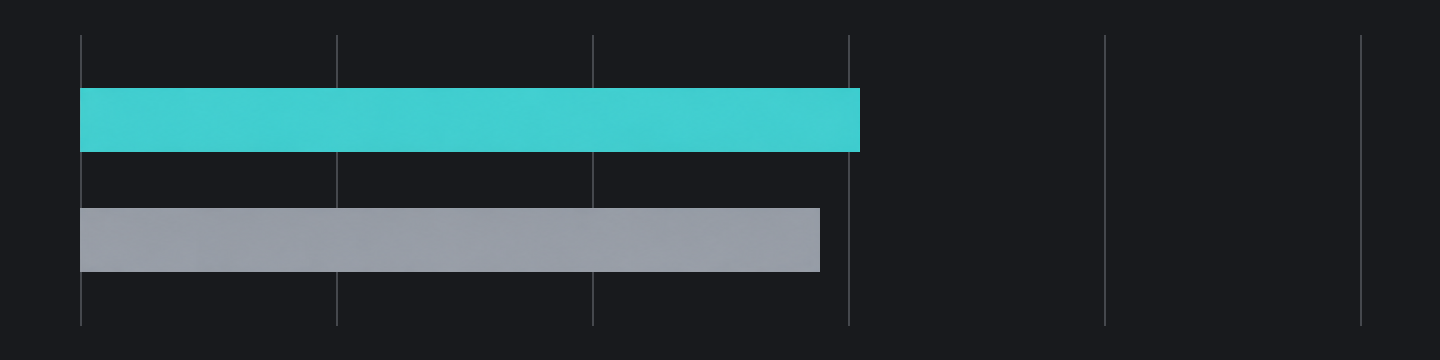
Fable 5.1: 65.0%Fable 5: 63.8%
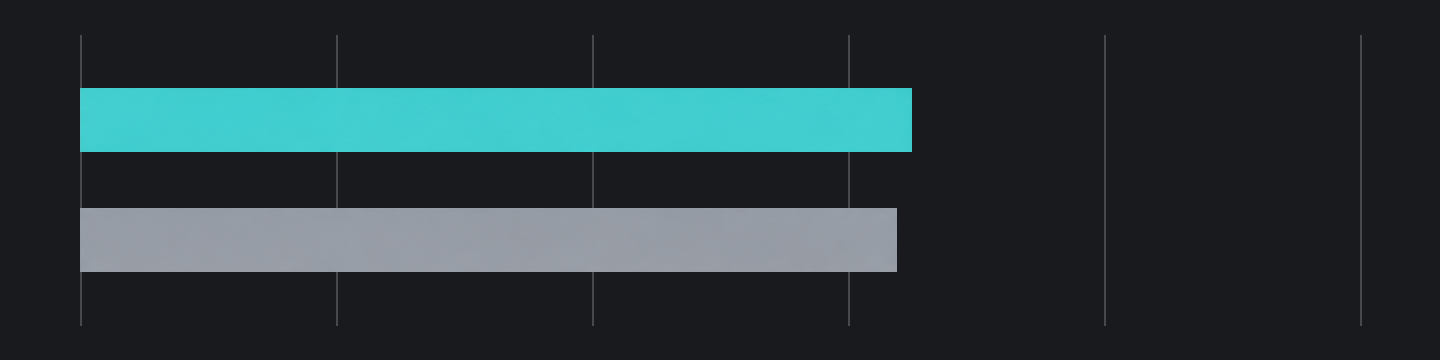
コーディング:端末作業で最も大きく向上
Fable 5.1 の最も明確な改善は、環境を操作し、実行結果を処理して作業を続ける端末タスクにあり、全コーディング課題の一律改善ではありません。Anthropic による Fable 5 からの上昇は Terminal-Bench-Science 0.1 で 27.9 ポイント、Terminal-Bench 4.0 で 13.8、CursorBench 3.2.0 で 2.9 です。コード生成品質全体の飛躍というより、複雑なタスクを実行する力の向上を示します。
価値は分析と実作業をつなぐことにあります。Anthropic はコードベースをまたぐ開発、自律的なテスト作成、視覚結果による実装目標の確認を挙げています。私たちは、もっともらしい案で止まらず、理解、修正、検証、改善まで進める力だと解釈しています。
推論:設定に左右される比較的小さな改善
推論も改善しましたが、端末課題ほど伸びない公開テストもあります。Humanity's Last Exam ではツールなしで Fable 5 の 57.8% から 60.9%、ツールありで 63.8% から 65.0% に上がり、増分は 3.1 と 1.2 ポイントです。
推論強度は、高いほど必ず賢くなる単純なスイッチではありません。Anthropic は能力、遅延、コストの主要な調整手段とし、モデル間で同じラベルでも同じ思考量にはならないと説明しています。
コミュニティには参考になる反例があります。Hacker News の seaurchinzee はシステムカードを、最高強度が FrontierCode Extended で最良ではなく、強度を上げると未要求の変更が増える場合があると解釈しています。これは HLE ではなく特定のコーディング評価ですが、思考量と指示遵守が一致しない点を示します。正しさと同様に範囲も重要で、Anthropic の指針も追加変更や範囲拡大を別途扱っています。
独立指数と出力速度:別々に評価すべき項目
Fable 5.1 の総合能力と応答速度は、一つの点数にせず別々に評価すべきだと考えます。2026年10月4日の確認では、Artificial Analysis の Max、Default Fallback 設定は知能指数 53、出力約 66.2 トークン/秒、最初のトークンまで約 259.12 秒です。
同じ SVG 描画課題で high は約 29.6 秒、max は約 13 分 54 秒でした。最高強度の結果が良いと評価しますが、待ち時間と出力使用量も大幅に増えました。追加の推論が一部の複雑な出力を改善し得るというのが私たちの結論です。
Claude Fable 5.1 と Fable 5、GPT-5.6 Sol、Kimi K3 の比較
Fable 5.1 を支持する最も直接的な根拠は端末課題での優位です。以下の表は Anthropic の公開時評価です。
Fable 5.1: 53Kimi K3: 44
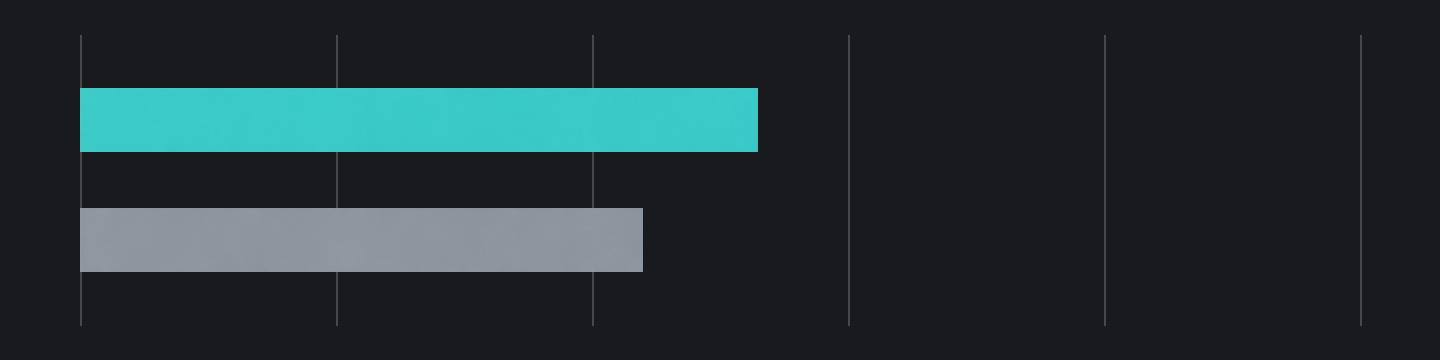
Fable 5.1: 52%Kimi K3: 13%
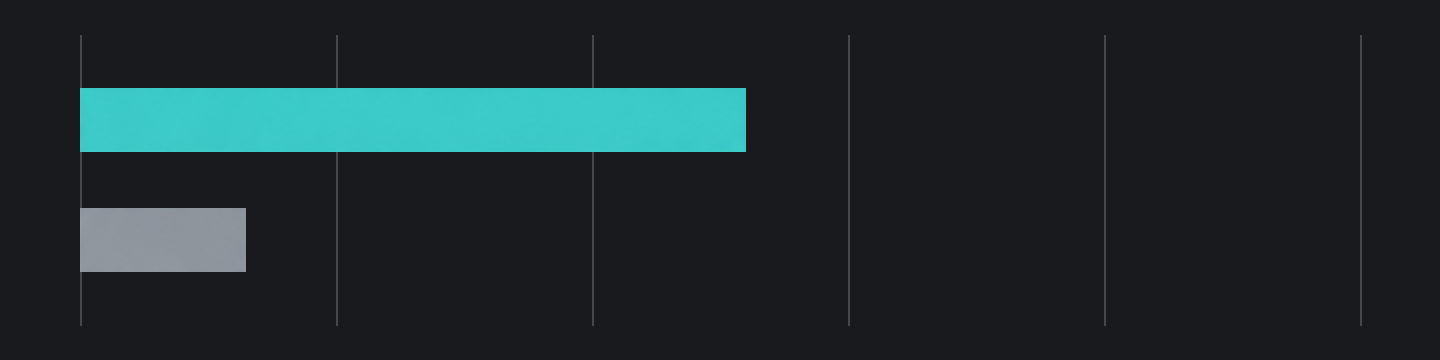
Fable 5.1: 85%Kimi K3: 89%
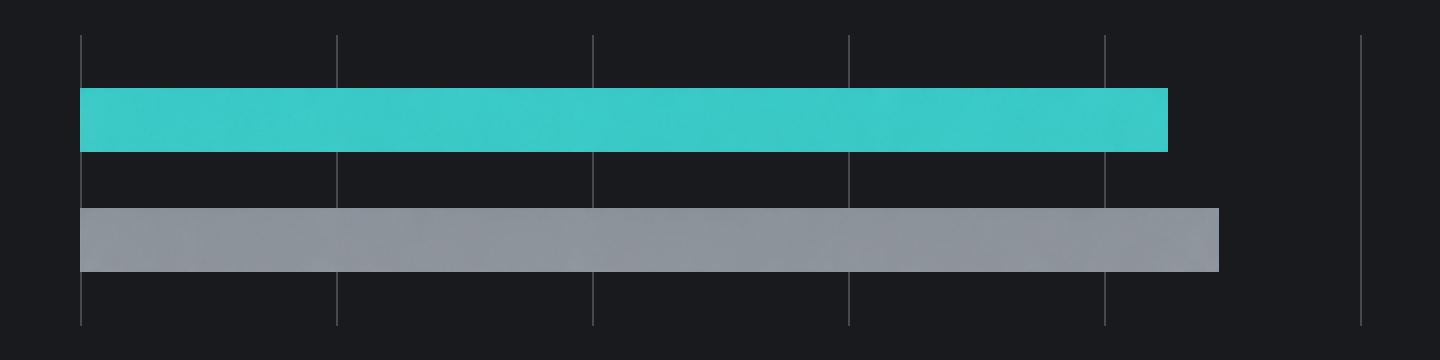
| ベンチマーク | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Fable 5、GPT-5.6 Sol との比較:端末コーディングで明確な優位
スコアは Fable 5.1 の GPT-5.6 Sol に対する優位が CursorBench より二つの端末ベンチマークで大きいことを示します。ある顧客は Fable 5.1 が自社テストで Fable 5 と同等か少し上回り、タスク単価も下がったため、コードレビューに使い始めたと報告しています。
Kimi K3 との比較:長文書推論では順位が逆転
この比較では Fable 5.1 が総合評価で上回ると判断します。Artificial Analysis の指数は Fable 5.1 が 53、Kimi K3 が 44、Terminal-Bench 4.0 はそれぞれ 52% と 13% です。AA-LCR v1.1 の長文脈推論では逆転し、Fable 5.1 が 85%、Kimi K3 が 89% です。
Kimi K3 の説明を好み、コードレビューや問題理解で切り替える利用者もいます。現時点の結論は、総合能力では Fable 5.1、この特定の長文書テストでは Kimi K3 が優位というものです。
API Hop 経由で Claude Fable 5.1 を使う理由は?
従量課金とモデルコストの最適化
現在の API Hop 料金と実際の使用量に基づいて課金されます。必要に応じてチャージできます。
AI モデルとデータ API を統合し、複数モデルに一か所からアクセス
1 つの API キーで複数の AI モデルとデータサービスに接続でき、導入コストを減らしてワンクリックで切り替えられます。ビジネスアプリケーションには AI とデータの両方が必要です。
呼び出しログとアプリのアクセス制御で、各リクエストを明確に
すべての API 呼び出しはダッシュボードに記録されます。アプリケーションごとに別の API キーを作成できます。
タスクに照らして出力を評価
API Hop では文書化されたモデル ID と対応パラメータを使用してください。自分の受け入れ条件で出力を評価し、本番利用前に使用記録とレスポンスのメタデータを確認してください。モデル名や例は、個々の結果を保証しません。
API Hop で Claude Fable 5.1 を使う方法
コンソールで API キーを作成したら、ドキュメントに従って Claude Fable 5.1 の利用を始めてください。
アカウントを準備してオンラインでテスト
ログインして残高を確認し、API キーを作成してください。
プレイグラウンドで試す
プレイグラウンドでモデルの能力を試し、最適な使い方を見つけてください。
Claude Fable 5.1 を業務に組み込む
開発者ドキュメントに従って Claude Fable 5.1 を業務に組み込んでください。
今後のモデル更新
新しいモデルへ切り替える前に、API キーのモデルカタログが正確な ID を返すことを確認します。同じエンドポイントとリクエストフィールドに対応している場合、モデル ID を変更し、本番トラフィックを流す前にレスポンス形式、ストリーミング、出力上限、課金をテストしてください。非同期の画像・動画タスクでは、ジョブ送信、状態ポーリング、結果取得も検証します。
Claude Fable 5.1 API のよくある質問
Claude Fable 5.1 は Fable 5 と同じ API モデルですか?
いいえ。Claude Fable 5.1(API モデル名:claude-fable-5-1)は Claude Fable 5(API モデル名:claude-fable-5)の更新版です。API 呼び出し時は正しい model パラメータを使ってください。
thinking が空、または回答が不完全なのはなぜですか?
ネイティブの Fable 5.1 は既定で適応的思考を使い、思考テキストを省略できます。通常のリクエストに thinking は不要で、thinking が空であるだけでは失敗ではありません。 回答が不完全な場合、完了状態と出力予算を確認し、思考と最終回答の両方に十分な余裕を確保してください。
Claude Fable 5.1 に OpenAI Responses を使えますか?
OpenAI Responses には対応していません。Claude には独自の Claude Messages 形式があります。詳細はドキュメントを参照してください。
ツール呼び出しを強制したり、ネイティブの Messages 会話を編集したりできますか?
ネイティブの Fable 5.1 は tool_choice の強制タイプ any と tool に対応していません。 以前のメッセージを編集した後で保存済み思考を再送する場合は注意してください。ツールの継続時はネイティブの assistant コンテンツブロックと署名をそのまま維持してください。
会話メモリは永続的ですか?
いいえ。API は後続リクエストのために会話コンテキストを自動保持しません。履歴を自分で管理し、必要なコンテキストを各リクエストに含めてください。長期記憶はアプリケーションで実装する必要があります。
関連テキスト API
Claude Fable 5.1 API の例と対応パラメータ
Claude Fable 5.1 API クイックスタート
claude-fable-5-1model は必須です。例ではこのページのモデル ID を使用しています。GET /v1/models で API キーのモデルアクセス権を確認してください。
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages には max_tokens が必須です。例の予算は変更可能で、上流の既定値やモデルの上限ではありません。思考だけで回答前に使い切る場合があるため、タスクに合わせて調整し、出力料金を確認してください。
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
モデルファミリーとプロトコルのリファレンス
Claude Messages
API ドキュメント全文ネイティブな Claude Messages 互換 API です。ツール呼び出しと Anthropic SSE イベントを含め、Anthropic Messages のリクエスト・レスポンス構造を使用します。
POST
https://api.apihop.ai/anthropic/v1/messages