Bu sentetik kayıtları id, owner, deadline ve evidence alanlarıyla JSON’a çıkarın: [R1] Sorun 41: dışa aktarma düzeltmesi Ana’ya ait; son tarih kararlaştırılmadı. [R2] Sorun 42: inceleme son tarihi 15 Ekim; sorumlu atanmadı; yıl belirtilmedi. Eksik değerler için null kullanın, kısmi tarihleri koruyun. evidence içinde kaynağı alıntılayın. Yıl veya sorumlu uydurmayın. Her alanı kaydıyla kontrol edin; bu metin biçimlendirme görevidir, veritabanı işlemi değildir.
Kodlama ve araştırma için Claude Fable 5.1 API
Çok adımlı kodlama ve araştırma için Claude Fable 5.1 API fiyatlarını ve entegrasyon seçeneklerini karşılaştırın. Akıl yürütme rehberini inceleyin ve metin istemlerini çevrimiçi test edin.
Claude Fable 5.1 API fiyatları ve faturalandırma
Resmi fiyat
- Girdi
- $10.0000 /M
- Çıktı
- $50.0000 /M
- Önbellek girdisi
- $0.2500 /M
- Önbelleğe yazma (5 dk)
- $12.5000 /M
- Önbelleğe yazma (1 saat)
- $20.0000 /M
API Hop fiyatı Tasarruf 45%
- Girdi
- $5.5000 /M
- Çıktı
- $27.5000 /M
- Önbellek girdisi
- $0.1375 /M
- Önbelleğe yazma (5 dk)
- $6.8750 /M
- Önbelleğe yazma (1 saat)
- $11.0000 /M
Referans fiyat bağımsız olarak doğrulanmamıştır. Maliyetleri karşılaştırmadan önce sağlayıcının güncel tarifelerini, faturalandırma birimlerini ve geçerli koşullarını kontrol edin.
Claude Fable 5.1 çevrimiçi sohbet aracı
Model ayarları
Bellek ne işe yarar?
Bu konuşmadaki tamamlanmış, yeniden kullanılabilir mesajları sonraki isteğe ekler. Böylece bağlamı tekrarlamadan takip soruları sorabilirsiniz.
Kapatıldığında ne olur?Yalnızca yeni mesajınız ve varsa sistem istemi gönderilir. Önceki mesajlar görünür kalır; belleği yeniden açmak uygun önceki mesajları tekrar ekler.
Bu uzun süreli bellek mi?Hayır. Bu, ayrı konuşmalar arasında taşınan bellek değil, mevcut konuşmanın bağlamıdır. Başarısız, durdurulmuş, kesilmiş veya yeniden kullanılamayan yanıtlar dahil edilmez. Daha fazla geçmiş, daha fazla girdi tokenı kullanarak maliyeti artırabilir.
Gelişmiş parametreler
0 veya daha fazla karakter(0/Sabit sınır yok)
Sabit karakter sınırı yoktur; tüm istek, istek boyutu ve model bağlamı sınırlarına tabidir. Bu bir token sayısı değildir. Sohbet

Bugün size nasıl yardımcı olabilirim?
Henüz yanıt verisi yok Hazır
Claude Fable 5.1 istem örnekleri
Bunlar Claude Fable 5.1 için değerlendirme istemleridir, kaydedilmiş model çıktıları değildir. Yalnızca sağlanan metni analiz eder; kod çalıştırmaz, üretim sistemlerini incelemez veya uzun bağlam performansını kanıtlamaz. Alıntılanan kanıtları ve kabul ölçütlerini kontrol edin, ardından üretimde kullanmadan önce yanıt meta verilerini ve kullanımı inceleyin.
Yalnızca bu belge örneğini kullanın: [P1] Dışa aktarma düzeltmesi hazırlık ortamı kontrollerini geçti. [P2] Cuma yayını önerildi, onaylanmadı. [P3] Mei salı günü hata mesajlarını inceleyecek. [P4] Belgelendirme sorumlusu atanmadı. İddia, tam destekleyici alıntı, paragraf kimliği ve belirsizlik tablosu döndürün. Üretim yayını onaylandı mı? Belgelerden kim sorumlu? Eksik bilgileri bilinmiyor işaretleyin. Alıntılar verilen örnekle aynı olmalı; hazırlık başarısından üretim başarısı çıkarmayın. Bu küçük örnek maksimum bağlam uzunluğunu test etmez.
Bu kurgusal ödeme-webhook politikasını inceleyin: başarısız her POST üç kez yeniden denenir, idempotency anahtarı saklanmaz ve yanıt gönderilmeden önce bakiye düşülür. Çift ücretlendirme risklerini belirleyin, en az değişiklik ve üç kabul testi önerin. Yalnızca bu bilgileri kullanın; koda, araçlara veya üretim sistemlerine erişiminiz olduğunu varsaymayın.
Claude Fable 5.1 nedir?
Çok adımlı kodlama ve araştırma
Claude Fable 5.1, Anthropic’in 1 Eylül 2026’da yayımladığı, sürekli analiz, çok adımlı görevler ve araçlarla işbirliğine odaklanan modeldir. Yalnızca hızlı yanıtlar yerine daha derin düşünce gerektiren karmaşık kodlama sorunları ve kapsamlı araştırmalar için uygundur. Yerel özellikleri metin ve görüntü girdisi, metin çıktısı, bir milyon token bağlam ve 128K’ya kadar çıktı tokenını destekler. Yerel API varsayılan olarak high efor kullanır; akıl yürütme eforu göreve uyarlanabilir.
API entegrasyonundan önce metin sohbetini deneyin
API Hop’in çevrimiçi aracıyla Fable 5.1’i hızla deneyebilirsiniz: giriş yapın, API anahtarı oluşturun ve API entegrasyonu ya da abonelik olmadan değerlendirmek için az miktarda bakiye ekleyin. Ayrı Anthropic hesabı gerekmez; fakat bu hesap kısıtlarına karşı garanti değildir ve platform koşulları geçerlidir. Bu sayfa metin sohbetini destekler; dosya yükleme, web gezintisi veya kod çalıştırmayı değil.
Claude Fable 5.1’i ne için kullanabilirsiniz?
Hata ayıklama ve kod inceleme
Anthropic, kod tabanları arası geliştirme, kod inceleme ve performans çalışmasını Fable 5.1’in temel kullanım alanları arasında sayıyor. Hata izleri, ilgili kod, ortam bilgileri ve yeniden üretme adımları sağlandığında derleyici hatalarını, yığınları ve yabancı kütüphane kaynaklarını okuyup bağımlılıkları izleyerek çözüm önerebilir. Bir müşteri, ekibinin yıllarca tam çözemediği nadir bir çökmeyi anlattı: Fable 5.1 dış kütüphaneyi tersine derledi, çökme dökümlerini karşılaştırdı, nedeni o kütüphanedeki kusura kadar izledi ve sonunda çözdü.
Arayüz uyumluluğunu, istisna yollarını, izin kontrollerini, kaynak temizliğini ve veri tutarlılığını da denetletebilirsiniz. Seçenek sunan deneyimli bir yardımcı olarak kullanın; karar sorumluluğu geliştiricilerde kalır.
Araştırma ve analiz
Araştırma ve analiz başka bir temel kullanım alanıdır. Fable 5.1 özetlemenin ötesinde soru etrafında hesaplamalar yapabilir, sonuçları gözleyip yaklaşımını değiştirebilir. Bir müşteri Fable 5 ile ek yönlendirme gerektiren optimizasyonun Fable 5.1 ile buna ihtiyaç duymadığını bildirdi. Uygulamanın sunduğu arama veya veri araçlarıyla kamu verilerini analiz edebilir, öneriler ve ihtiyaçlara göre değerlendirmeler hazırlayabilir; bu metin sayfası kendi başına web’de gezinmez.
Kamu verileri çok fazla gürültü içerebilir. İş anlayışınıza göre güvenilir kaynaklar oluşturmanızı veya mühendislik ve iş ekiplerimizin seçtiği API Hop veri API’lerini kullanmanızı öneririz.
Yazma ve belge taslağı hazırlama
Fable 5.1’in yazmadaki temel gelişimi daha uzun makalelerden ziyade daha açık ifade ve yazım gereksinimlerine uyumdur. Anthropic rehberi modeli ana yazar değil yardımcı olarak tutmayı ve üretilen içeriği kendiniz inceleyip değerlendirmeyi önerir.
Anthropic hedef kitleyi, okuyucunun çözülmesini istediği bilgi veya sorunu, zorunlu bilgileri ve kaçınılacak ifadeleri belirtmeyi önerir. Somut hedef, yapı ve örnekler yalnızca profesyonel makale istemekten daha yararlı taslak üretir.
Uzun belgeler ve çok turlu tartışma
Artificial Analysis karşılaştırmasında Fable 5.1’in bileşik endeksi Kimi K3’ten yüksek, ancak AA-LCR v1.1 uzun bağlam testinde Kimi K3’ün %89’una karşı %85 alıyor. Ayarlar Fable 5.1 için Max, Default Fallback; Kimi K3 için Max. Bu özel uzun belge testinde Kimi K3 önde; sonuç Fable 5.1’i en güçlü uzun belge modeli ilan etmeyi desteklemez.
Anthropic’in istem rehberinde belirtildiği gibi uzun akışta bağlam sıkıştırıldıktan sonra önemli kısıtlar, alınan kararlar veya kesin ayrıntılar kaybolabilir. Uygulamanızda mümkünse temel bilgileri her konuşmada korumanızı öneririz.
Claude Fable 5.1 kıyaslamaları: kodlama, akıl yürütme ve hız
Anthropic’in lansman değerlendirmeleri ve Artificial Analysis’ın bağımsız testleri aşağıda ayrı sunulur. Ayarları farklıdır; hiçbiri API Hop ölçümü değildir.
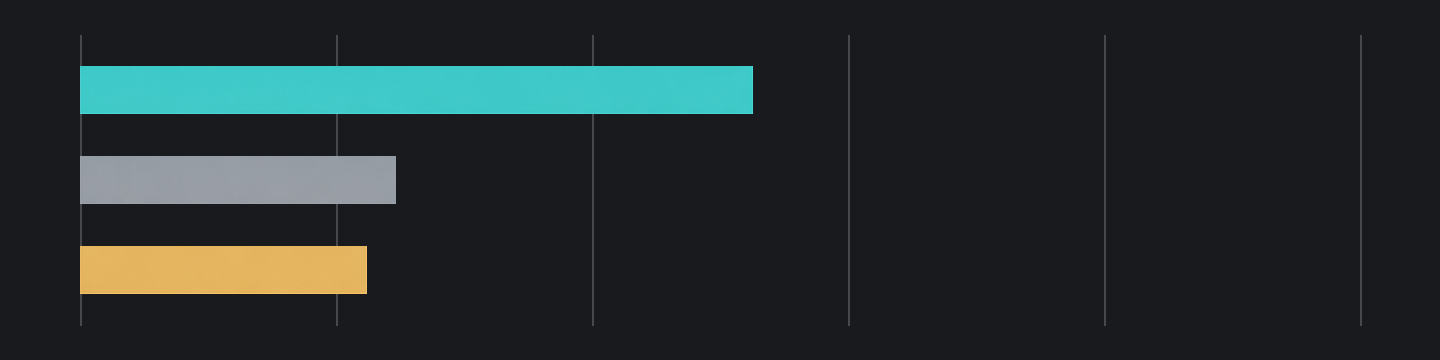
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
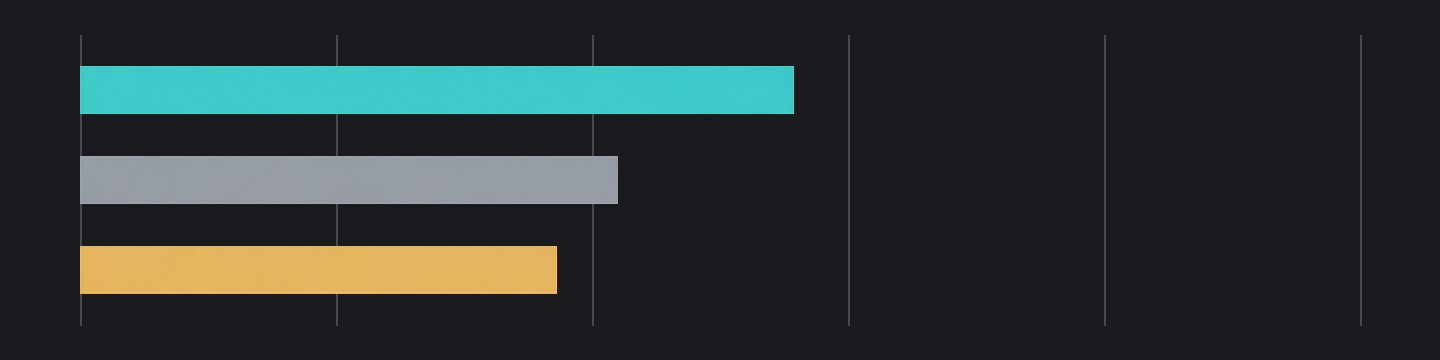
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
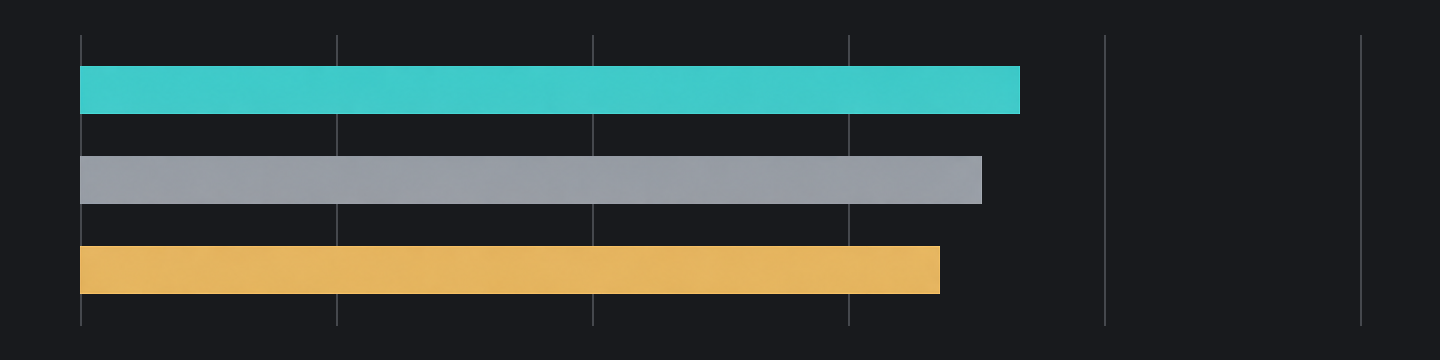
Fable 5.1: 60.9%Fable 5: 57.8%
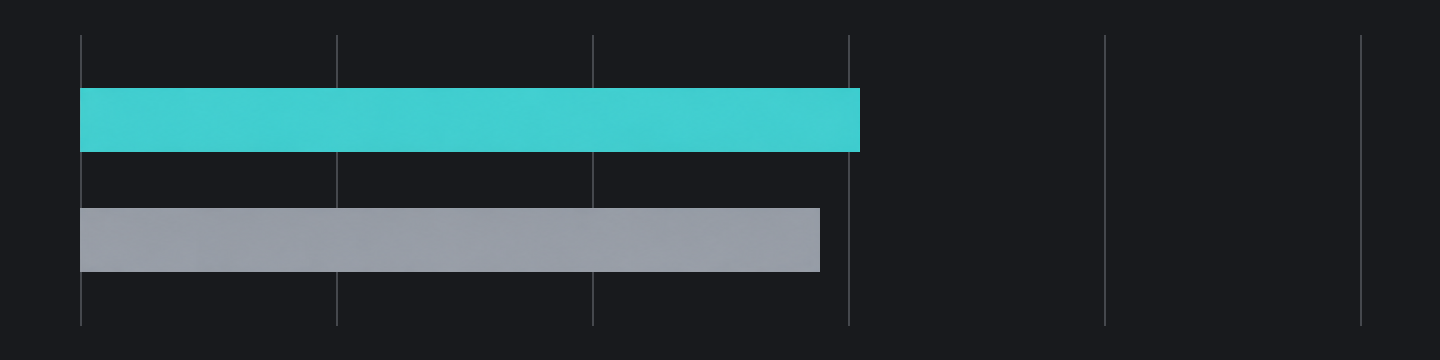
Fable 5.1: 65.0%Fable 5: 63.8%
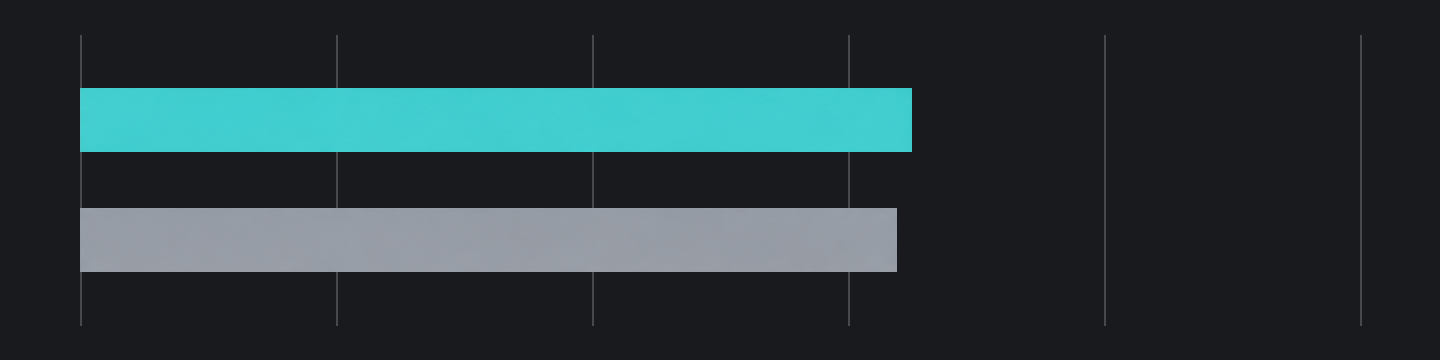
Kodlama: en büyük sıçrama terminal işlerinde
Fable 5.1’in en belirgin kodlama gelişimi her görevde ortalama artış değil, ortamı işletme, yürütme sonuçlarını işleme ve işe devam etme gerektiren terminal görevlerindedir. Anthropic, Fable 5’e göre Terminal-Bench-Science 0.1’de 27.9, Terminal-Bench 4.0’da 13.8 ve CursorBench 3.2.0’da 2.9 yüzde puan artış bildiriyor. Bu farklar kod üretiminde eşit sıçrama yerine karmaşık görev yürütmede güçlenmeye işaret ediyor.
Değer, analizi pratik eyleme bağlamaktadır. Anthropic kod tabanları arası geliştirmeyi, bağımsız test yazmayı ve uygulamanın hedeflere ulaşıp ulaşmadığını görsel sonuçlarla denetlemeyi anlatıyor. Yorumumuz, makul öneride durmak yerine çözümü anlama, değiştirme, doğrulama ve iyileştirmeye daha uygun olduğudur.
Akıl yürütme: daha küçük, ayara bağlı kazanımlar
Akıl yürütme gelişti, ancak bazı testlerde artış terminal görevlerinden küçük. Humanity's Last Exam’de araçsız puan Fable 5’in %57.8’inden %60.9’a, araçlı puan %63.8’den %65.0’a çıkıyor: 3.1 ve 1.2 yüzde puan artış.
Eforu yükseldikçe daima daha akıllı yapan basit bir anahtar olarak görmüyoruz. Anthropic bunu yetenek, gecikme ve maliyetin temel kontrolü olarak tanımlar; modellerde aynı efor etiketinin aynı düşünme miktarı demek olmadığını belirtir.
Topluluk tartışması yararlı karşı örnek sunuyor. Hacker News kullanıcısı seaurchinzee, sistem kartını en yüksek eforun FrontierCode Extended’da en iyi sonucu vermediği ve yüksek ayarların istenmeyen değişiklikleri artırabildiği şeklinde yorumluyor. Bu HLE değil belirli bir kodlama değerlendirmesidir; ancak fazla düşünmenin göreve daha iyi uyum demek olmadığını gösterir. Doğruluk yanında kapsam da önemlidir; Anthropic rehberi ek değişiklikleri ve kapsam genişlemesini ayrıca ele alır.
Bağımsız endeks ve çıktı hızı: iki ayrı soru
Fable 5.1’in genel yeteneği ve yanıt hızını tek puana indirmek yerine ayrı değerlendirmek gerektiğini düşünüyoruz. 4 Ekim 2026 kontrolünde Artificial Analysis, Max, Default Fallback ayarı için 53 zekâ endeksi, saniyede yaklaşık 66.2 çıktı tokenı ve ilk tokena yaklaşık 259.12 saniye kaydediyor.
Aynı SVG çizim görevinde high yaklaşık 29.6 saniye, max yaklaşık 13 dakika 54 saniye sürdü. En yüksek eforun sonucunu daha iyi buluyoruz, ancak bekleme ve çıktı kullanımı da önemli ölçüde arttı. Sonucumuz, ek düşünmenin bazı karmaşık çıktıları iyileştirebildiğidir.
Claude Fable 5.1’in Fable 5, GPT-5.6 Sol ve Kimi K3 ile karşılaştırması
Fable 5.1’i destekleyen en doğrudan kanıt terminal görevlerindeki üstünlüğüdür. Aşağıdaki tablo Anthropic’in lansman değerlendirmesidir.
Fable 5.1: 53Kimi K3: 44
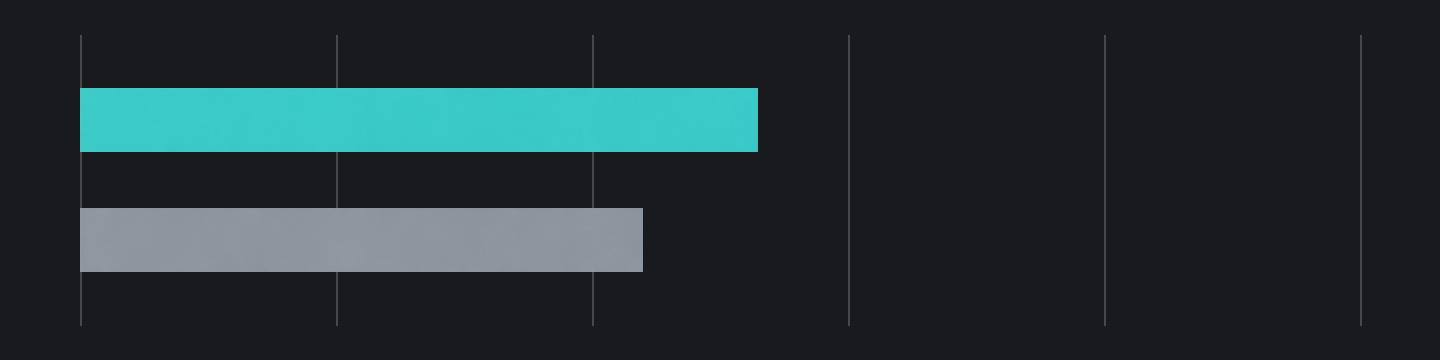
Fable 5.1: 52%Kimi K3: 13%
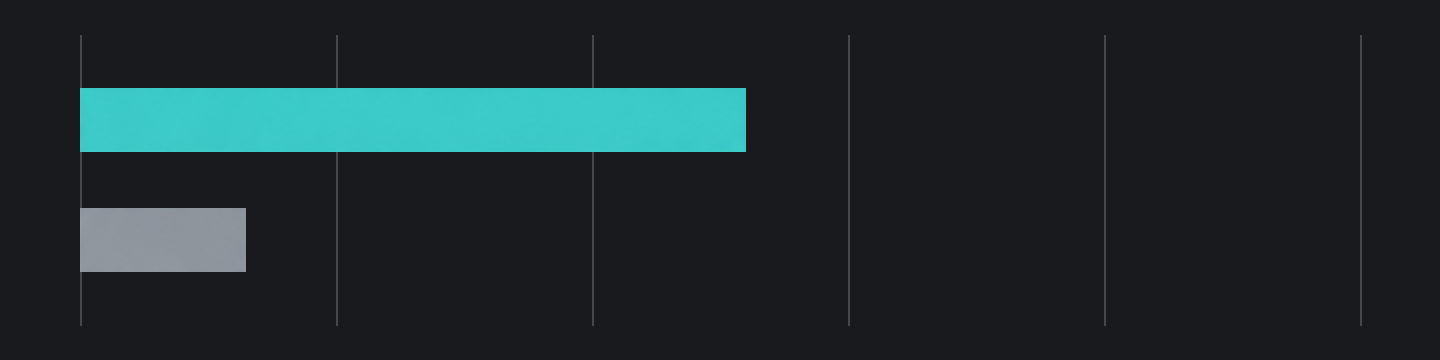
Fable 5.1: 85%Kimi K3: 89%
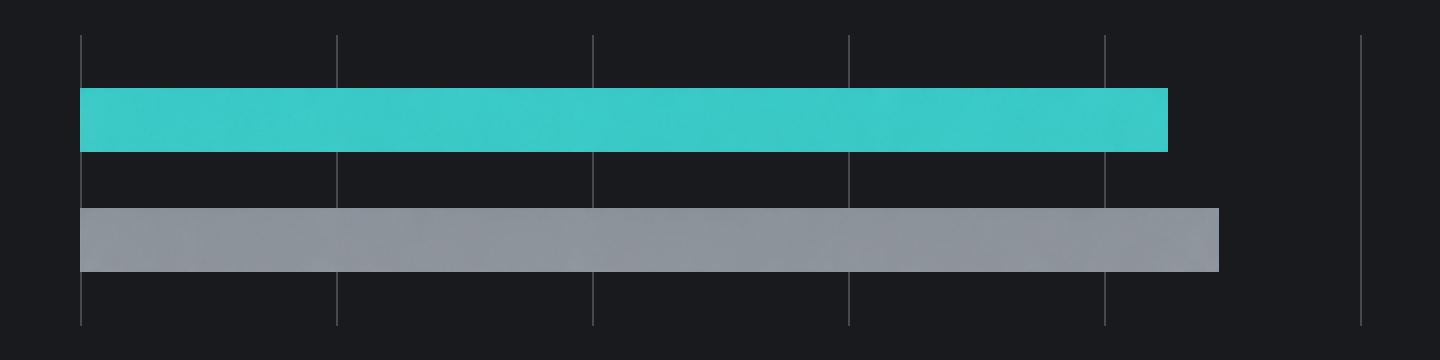
| Kıyaslama | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Fable 5 ve GPT-5.6 Sol’a karşı: en belirgin üstünlük terminal kodlamasında
Bu puanlar Fable 5.1’in GPT-5.6 Sol’a üstünlüğünün iki terminal kıyaslamasında CursorBench’ten daha büyük olduğunu gösteriyor. Bir müşteri Fable 5.1’in testlerinde Fable 5’e eşit veya biraz üstün sonuç verip görev başı maliyeti düşürdüğünü, bunun üzerine kod incelemede kullanmaya başladığını bildirdi.
Kimi K3’e karşı: uzun belge akıl yürütmesinde sıralama tersine dönüyor
Değerlendirmemize göre Fable 5.1 bu karşılaştırmanın bileşik ölçümünde daha güçlüdür. Artificial Analysis, Fable 5.1 için 53, Kimi K3 için 44 endeks; Terminal-Bench 4.0’da sırasıyla %52 ve %13 kaydediyor. AA-LCR v1.1 uzun bağlamda sıralama tersine döner: Fable 5.1 %85, Kimi K3 %89.
Bazı kullanıcılar Kimi K3 açıklamalarını tercih edip kod inceleme veya sorunu anlamak için ona geçebilir. Mevcut sonucumuz: bileşik yetenekte Fable 5.1, bu özel uzun belge testinde Kimi K3 öndedir.
Claude Fable 5.1 neden API Hop üzerinden kullanılmalı?
Kullanıma dayalı faturalandırma ve model maliyeti optimizasyonu
Ücretler güncel API Hop fiyatlarına ve gerçek kullanıma göre belirlenir. Gerektikçe bakiye yükleyin.
Birden fazla modele tek yerden erişim sunan birleşik AI modelleri ve veri API’leri
Tek bir API anahtarı birden fazla AI modeline ve veri hizmetine bağlanarak entegrasyon maliyetlerini azaltır ve tek tıkla geçiş sağlar. İş uygulamaları hem AI hem de veriye ihtiyaç duyar.
Her çağrı için şeffaflık sağlayan çağrı kayıtları ve uygulama erişim kontrolleri
Her API çağrısı kontrol panelinize kaydedilir. Farklı uygulamalar için ayrı API anahtarları oluşturun.
Çıktıları görevinize göre değerlendirin
API Hop üzerinden belgelenmiş model kimliğini ve desteklenen parametreleri kullanın. Çıktıları kendi kabul ölçütlerinizle değerlendirin; üretim kullanımı öncesinde kullanım kayıtlarını ve yanıt meta verilerini inceleyin. Model adı veya örnek, her sonucu garanti etmez.
Claude Fable 5.1 API Hop üzerinde nasıl kullanılır
Konsolda bir API anahtarı oluşturduktan sonra Claude Fable 5.1 kullanmaya başlamak için belgeleri izleyin.
Hesabınızı hazırlayın ve çevrimiçi test edin
Oturum açın, bakiyenizi doğrulayın ve bir API anahtarı oluşturun.
Deneme alanında deneyin
En uygun kullanım şeklini bulmak için modelin yeteneklerini deneme alanında keşfedin.
Claude Fable 5.1 modelini işinize entegre edin
Claude Fable 5.1 modelini işinize entegre etmek için geliştirici belgelerimizi izleyin.
Gelecekteki model yükseltmeleri
Daha yeni bir modele geçmeden önce tam kimliğinin API anahtarınızın model kataloğunda döndüğünü doğrulayın. Aynı uç noktayı ve istek alanlarını destekliyorsa model kimliğini güncelleyin; üretim trafiğini yönlendirmeden önce yanıt biçimlerini, akışı, çıktı sınırlarını ve faturalandırmayı test edin. Eşzamansız görüntü veya video görevlerinde görev gönderimini, durum sorgulamasını ve sonuç alımını da doğrulayın.
Claude Fable 5.1 API sık sorulan sorular
Claude Fable 5.1, Fable 5 ile aynı API modeli mi?
Hayır. Claude Fable 5.1 (API model adı: claude-fable-5-1), Claude Fable 5’in (API model adı: claude-fable-5) yükseltilmiş sürümüdür. API çağrısında doğru model parametresini kullanın.
thinking neden boş veya yanıt eksik?
Yerel Fable 5.1 varsayılan olarak uyarlanabilir düşünme kullanır ve düşünme metnini atlayabilir. Normal isteklerde thinking parametresi gerekmez; thinking alanının boş olması tek başına hata değildir. Eksik yanıtta tamamlanma durumunu ve çıktı bütçesini kontrol edin; düşünme ve son metin için yeterli alan bırakın.
Kimlik doğrulama, bakiye veya erişim hatalarını nasıl gideririm?
Sorunu teşhis etmek için API hata belgelerini izleyin.
Claude Fable 5.1 için OpenAI Responses kullanabilir miyim?
OpenAI Responses desteklenmez. Claude’un kendi Claude Messages biçimi vardır; ayrıntılar için belgelere bakın.
Araç çağrısını zorlayabilir veya yerel Messages konuşmasını düzenleyebilir miyim?
Yerel Fable 5.1, zorunlu tool_choice türleri any veya tool değerlerini desteklemez. Önceki mesajları düzenledikten sonra korunmuş düşünmeyi yeniden gönderirken dikkatli olun. Araç devamlarında yerel assistant içerik bloklarını ve imzalarını aynen koruyun.
Konuşma belleği kalıcı mı?
Hayır. API sonraki istekler için konuşma bağlamını otomatik saklamaz. Geçmişi kendiniz yönetin ve her isteğe gerekli bağlamı ekleyin. Uzun süreli belleği uygulamanız sağlamalıdır.
İlgili metin API’leri
Claude Fable 5.1 API örnekleri ve desteklenen parametreler
Claude Fable 5.1 API hızlı başlangıç
claude-fable-5-1model zorunludur; bu örnekler mevcut sayfadaki model kimliğini kullanır. API anahtarınızın model erişimini GET /v1/models ile kontrol edin.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages için max_tokens zorunludur. Örnekteki bütçe düzenlenebilir; üst sağlayıcının varsayılanı veya model sınırı değildir. Düşünme, yanıt metni oluşmadan bütçeyi tüketebilir; görevinize göre ayarlayın ve çıktı maliyetlerini kontrol edin.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Aile ve protokol başvurusu
Claude Messages
Tam API belgeleriYerel Claude Messages uyumlu API. Bu uç nokta, araç çağrıları ve Anthropic SSE olayları dahil Anthropic Messages istek ve yanıt yapılarını kullanır.
POST
https://api.apihop.ai/anthropic/v1/messages