Estrai i record sintetici in JSON con id, owner, deadline, evidence: [R1] Problema 41: Ana gestisce la correzione dell’export; nessuna scadenza concordata. [R2] Problema 42: revisione entro il 15 ottobre; responsabile non assegnato; anno non specificato. Usa null per valori mancanti e mantieni le date parziali. Cita la fonte in evidence. Non inventare anno o responsabile. Verifica ogni campo rispetto al record; è formattazione di testo, non un’operazione sul database.
API Claude Fable 5.1 per programmazione e ricerca
Confronta prezzi API e opzioni di integrazione di Claude Fable 5.1 per programmazione e ricerca a più fasi. Consulta la guida al ragionamento e prova prompt testuali online.
Prezzi e fatturazione dell’API Claude Fable 5.1
Prezzo ufficiale
- Input
- $10.0000 /M
- Output
- $50.0000 /M
- Input in cache
- $0.2500 /M
- Scrittura in cache (5 min)
- $12.5000 /M
- Scrittura in cache (1 h)
- $20.0000 /M
Prezzo API Hop Risparmio 45%
- Input
- $5.5000 /M
- Output
- $27.5000 /M
- Input in cache
- $0.1375 /M
- Scrittura in cache (5 min)
- $6.8750 /M
- Scrittura in cache (1 h)
- $11.0000 /M
Prezzo di riferimento non verificato in modo indipendente. Prima di confrontare i costi, controlla tariffe attuali, unità di fatturazione e condizioni applicabili del fornitore.
Strumento di chat online Claude Fable 5.1
Impostazioni del modello
A cosa serve la memoria?
Include gli scambi completati e riutilizzabili di questa conversazione nella richiesta successiva, per fare domande di approfondimento senza ripetere il contesto.
Cosa succede se è disattivata?Vengono inviati solo il nuovo messaggio e un eventuale prompt di sistema. I messaggi precedenti restano visibili; riattivando la memoria si includono di nuovo gli scambi precedenti idonei.
È una memoria a lungo termine?No. È il contesto della conversazione, non una memoria condivisa tra conversazioni separate. Le risposte fallite, interrotte, troncate o non riutilizzabili sono escluse. Più cronologia può consumare più token di input e aumentare i costi.
Parametri avanzati
0 o più caratteri(0/Nessun limite fisso)
Nessun limite fisso di caratteri; la richiesta completa è soggetta ai limiti di dimensione e di contesto del modello. Questo non è un conteggio dei token. Conversazione

Come posso aiutarti oggi?
Nessun dato di risposta Pronto
Esempi di prompt per Claude Fable 5.1
Questi sono prompt di valutazione per Claude Fable 5.1, non output registrati. Analizzano solo il testo fornito; non eseguono codice, non ispezionano sistemi di produzione e non dimostrano prestazioni su contesti lunghi. Verifica le evidenze citate e i criteri di accettazione, poi controlla metadati e utilizzo prima dell’uso in produzione.
Usa solo questo esempio: [P1] La correzione dell’export ha superato i controlli di staging. [P2] È stata proposta, non approvata, una pubblicazione venerdì. [P3] Mei esaminerà gli errori martedì. [P4] Nessun responsabile è assegnato alla documentazione. Restituisci una tabella con affermazione, citazione esatta, ID paragrafo e incertezza. Il rilascio in produzione è approvato? Chi gestisce la documentazione? Segna i fatti mancanti come sconosciuti. Ogni citazione deve coincidere col campione; non dedurre successo in produzione dallo staging. Questo piccolo esempio non testa il contesto massimo.
Esamina questa politica fittizia di webhook di pagamento: ogni POST fallito viene ripetuto tre volte, non viene salvata alcuna chiave di idempotenza e il saldo viene addebitato prima della risposta. Individua rischi di doppio addebito, proponi modifiche minime e tre test di accettazione. Usa solo questi fatti; non presumere accesso a codice, strumenti o sistemi di produzione.
Che cos’è Claude Fable 5.1?
Programmazione e ricerca in più passaggi
Claude Fable 5.1 è un modello Anthropic pubblicato il 1 settembre 2026, focalizzato su analisi prolungata, compiti in più passaggi e collaborazione con strumenti. Più che risposte rapide, serve problemi complessi di programmazione e ricerca approfondita. Le specifiche native supportano input di testo e immagini, output testuale, un milione di token di contesto e fino a 128K token di output. L’API nativa usa high come sforzo predefinito, regolabile secondo il compito.
Prova la chat prima di integrare l’API
Lo strumento online API Hop permette di provare rapidamente Fable 5.1: accedi, crea una chiave API e aggiungi poco credito, senza integrazione o abbonamento. Non serve un account Anthropic separato, ma ciò non garantisce assenza di restrizioni; valgono comunque i termini della piattaforma. La pagina supporta conversazioni testuali, non upload, navigazione web o esecuzione di codice.
Per cosa puoi usare Claude Fable 5.1?
Debug e revisione del codice
Anthropic include sviluppo tra codebase, revisione e prestazioni tra gli usi principali di Fable 5.1. Fornisci tracce d’errore, codice, dettagli dell’ambiente e passi di riproduzione: può leggere errori del compilatore, stack e sorgenti di librerie sconosciute, seguire dipendenze e proporre soluzioni. Un cliente ha descritto un raro crash irrisolto da anni: Fable 5.1 ha disassemblato una libreria esterna, confrontato dump e individuato un difetto nella libreria, risolvendolo infine.
Puoi chiedere controlli su compatibilità, eccezioni, permessi, rilascio delle risorse e coerenza dei dati. Trattalo come assistente esperto che propone opzioni, lasciando agli sviluppatori la responsabilità delle decisioni.
Ricerca e analisi
Ricerca e analisi sono un altro uso principale. Oltre a riassumere, Fable 5.1 può svolgere calcoli su una domanda, osservare risultati e adattare l’approccio. Un cliente ha riferito che un’ottimizzazione richiedeva ulteriori istruzioni con Fable 5, ma non con Fable 5.1. Con strumenti di ricerca o dati forniti dall’app può analizzare dati pubblici, redigere proposte e valutazioni; questa pagina testuale non naviga sul web.
I dati pubblici possono contenere molto rumore. Suggeriamo fonti affidabili basate sulla conoscenza del business, oppure le API dati API Hop selezionate dai nostri team tecnici e commerciali.
Scrittura e bozze di documenti
I principali miglioramenti di Fable 5.1 nella scrittura sono chiarezza e rispetto dei requisiti, non solo articoli più lunghi. Anthropic raccomanda di mantenerlo come assistente, non autore principale, continuando a rivedere e giudicare personalmente i contenuti IA.
Anthropic consiglia di specificare pubblico, informazioni o problemi del lettore, contenuti obbligatori ed espressioni da evitare. Obiettivi concreti, struttura ed esempi producono più facilmente una bozza utile rispetto a chiedere solo un articolo professionale.
Documenti lunghi e discussioni su più turni
Nel confronto Artificial Analysis, Fable 5.1 supera Kimi K3 nell’indice complessivo ma ottiene 85% contro 89% di Kimi K3 in AA-LCR v1.1 sul contesto lungo. Le configurazioni sono Fable 5.1 Max con Default Fallback e Kimi K3 Max. Kimi K3 guida quindi questo specifico test; non è prova che Fable 5.1 sia il migliore sui documenti lunghi.
Dopo la compressione del contesto in flussi lunghi possono perdersi vincoli, decisioni o dettagli precisi, come spiega la guida Anthropic. Se l’applicazione lo permette, suggeriamo di mantenere le informazioni essenziali in ogni conversazione.
Benchmark Claude Fable 5.1: codice, ragionamento e velocità
Le valutazioni di lancio Anthropic e quelle indipendenti Artificial Analysis sono presentate separatamente. Le impostazioni differiscono e nessuna è una misurazione API Hop.
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
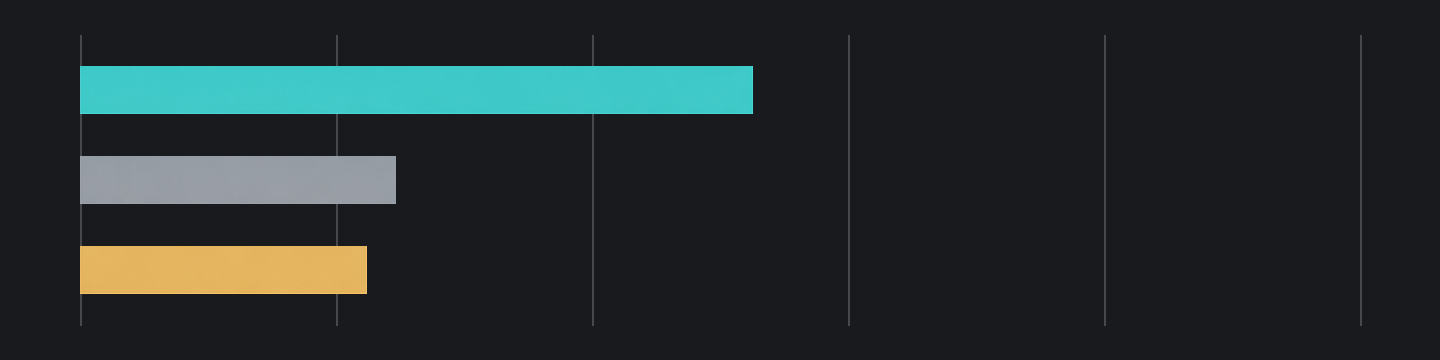
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
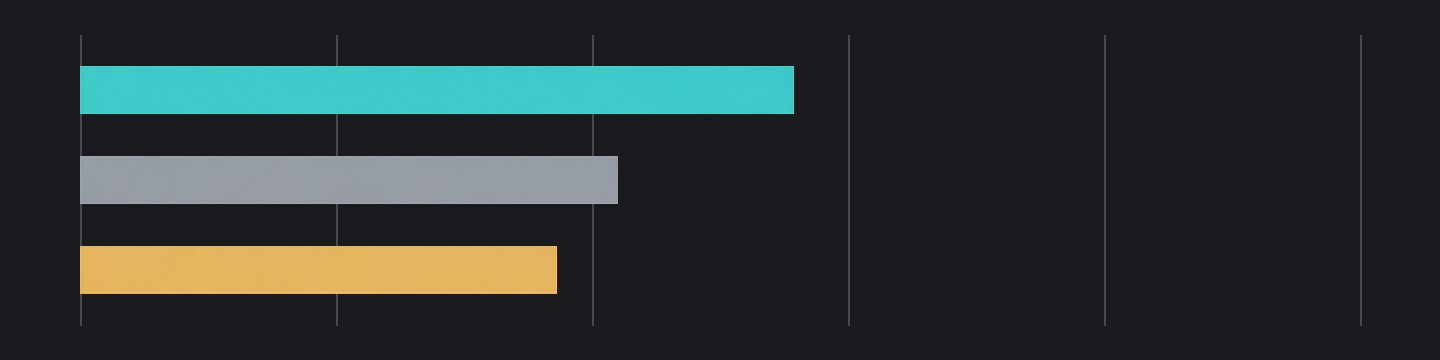
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
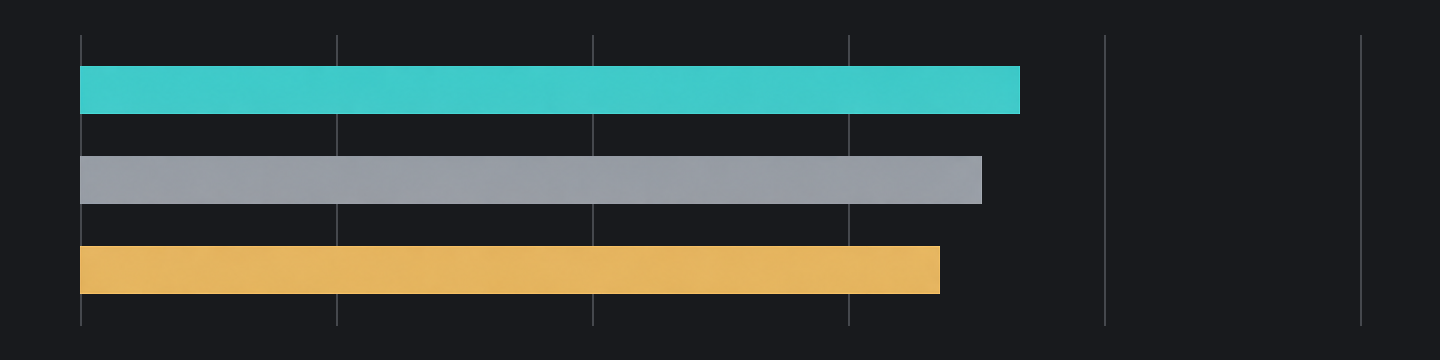
Fable 5.1: 60.9%Fable 5: 57.8%
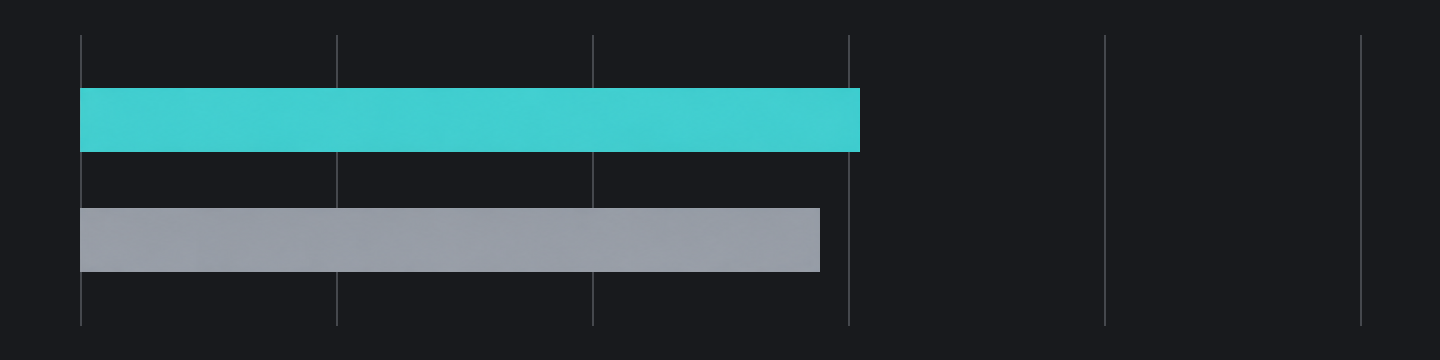
Fable 5.1: 65.0%Fable 5: 63.8%
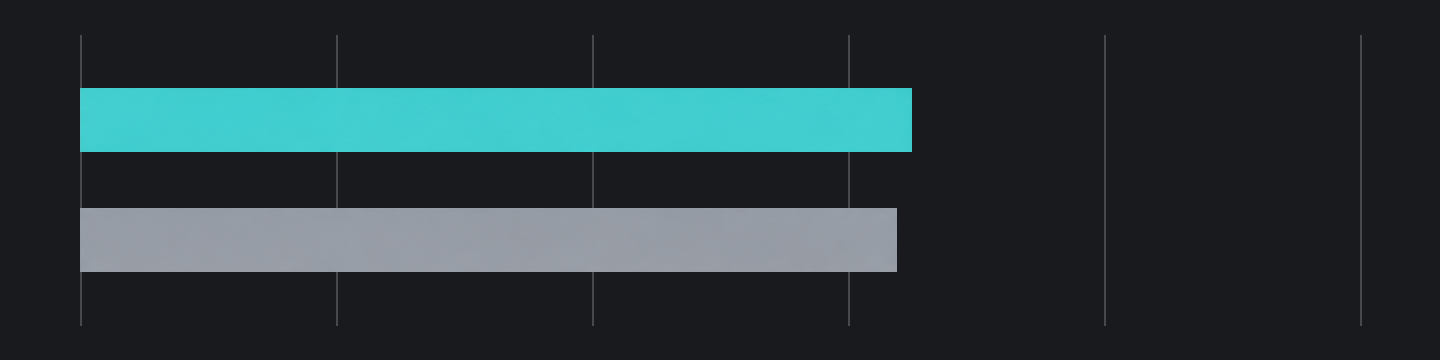
Codice: il salto maggiore è nel lavoro da terminale
Il miglioramento più netto di Fable 5.1 riguarda terminali che richiedono operare nell’ambiente, elaborare risultati e proseguire, non un aumento uniforme in tutti i compiti. Anthropic riporta rispetto a Fable 5 guadagni di 27.9 punti percentuali in Terminal-Bench-Science 0.1, 13.8 in Terminal-Bench 4.0 e 2.9 in CursorBench 3.2.0. Ciò indica esecuzione più forte di compiti complessi, non un salto uniforme nella qualità del codice.
Il valore è collegare analisi e azione. Anthropic descrive sviluppo tra codebase, test scritti autonomamente e verifica visiva degli obiettivi. Interpretiamo ciò come maggiore capacità di capire, modificare, verificare e affinare una soluzione anziché fermarsi a una proposta plausibile.
Ragionamento: guadagni minori legati alle impostazioni
Il ragionamento migliora, ma alcuni test mostrano guadagni minori rispetto al terminale. Su Humanity's Last Exam, senza strumenti si passa dal 57.8% di Fable 5 al 60.9%, con strumenti dal 63.8% al 65.0%: aumenti di 3.1 e 1.2 punti percentuali.
Non vediamo lo sforzo come un interruttore in cui più alto significa sempre più intelligente. Anthropic lo definisce un controllo principale su capacità, latenza e costi e precisa che etichette uguali tra modelli non equivalgono alla stessa quantità di pensiero.
La comunità offre un controesempio utile. L’utente Hacker News seaurchinzee interpreta la scheda di sistema come prova che lo sforzo massimo non sia il migliore su FrontierCode Extended e possa aumentare modifiche non richieste. Riguarda uno specifico test di codice, non HLE, ma evidenzia che più ragionamento non implica maggiore aderenza. L’ambito conta insieme alla correttezza; la guida Anthropic tratta separatamente modifiche extra e ampliamento del compito.
Indice indipendente e velocità: due domande distinte
Riteniamo che capacità complessiva e velocità di Fable 5.1 vadano valutate separatamente. Al controllo del 4 ottobre 2026, Artificial Analysis riporta per Max, Default Fallback un indice di intelligenza di 53, circa 66.2 token di output al secondo e circa 259.12 secondi al primo token.
Nello stesso disegno SVG, high ha impiegato circa 29.6 secondi e max circa 13 minuti e 54 secondi. Riteniamo migliore il risultato con sforzo massimo, ma attesa e consumo di output sono aumentati molto. Più ragionamento può migliorare alcuni output complessi.
Claude Fable 5.1 a confronto con Fable 5, GPT-5.6 Sol e Kimi K3
La prova più diretta a favore di Fable 5.1 resta il vantaggio nei compiti da terminale. La tabella seguente è una valutazione di lancio Anthropic.
Fable 5.1: 53Kimi K3: 44
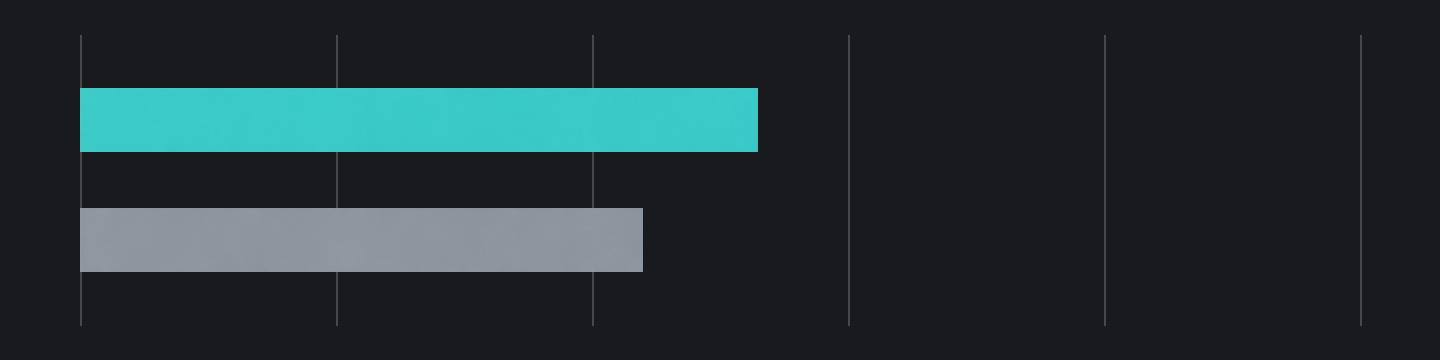
Fable 5.1: 52%Kimi K3: 13%
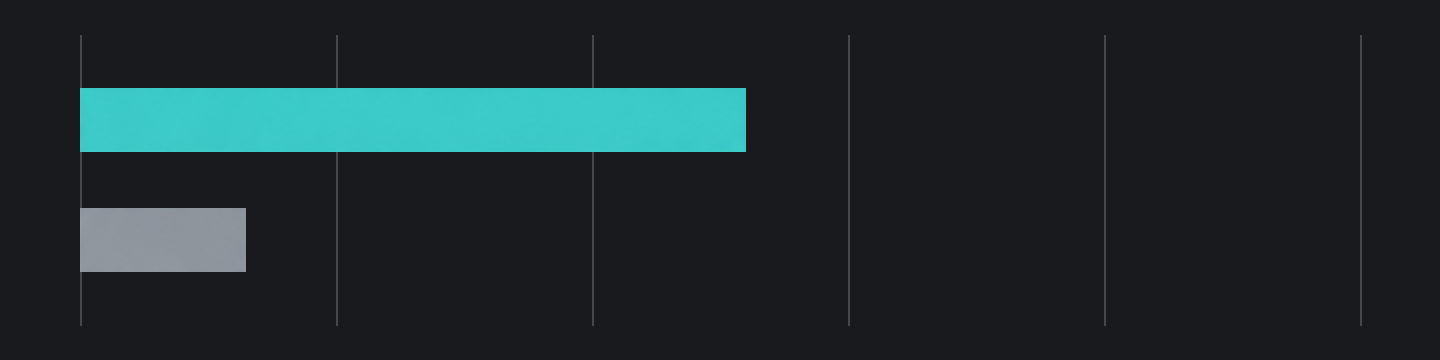
Fable 5.1: 85%Kimi K3: 89%
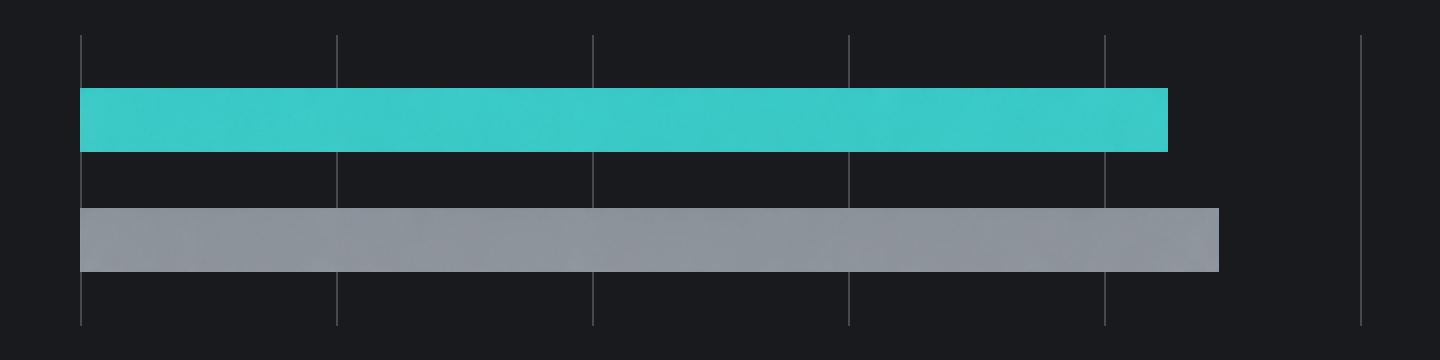
| Test di riferimento | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Rispetto a Fable 5 e GPT-5.6 Sol: vantaggio più chiaro nel codice da terminale
I punteggi mostrano un vantaggio di Fable 5.1 su GPT-5.6 Sol maggiore nei due benchmark terminali che in CursorBench. Un cliente ha riportato risultati pari o leggermente superiori a Fable 5 con costo per compito ridotto, iniziando quindi a usare Fable 5.1 per la revisione del codice.
Rispetto a Kimi K3: i documenti lunghi invertono la classifica
Valutiamo Fable 5.1 più forte nell’indice complessivo di questo confronto. Artificial Analysis riporta 53 per Fable 5.1 e 44 per Kimi K3, con Terminal-Bench 4.0 al 52% e 13%. In AA-LCR v1.1 sul contesto lungo l’ordine si inverte: Fable 5.1 85%, Kimi K3 89%.
Alcuni utenti possono preferire le spiegazioni di Kimi K3 e usarlo per revisioni o comprensione di problemi. La nostra conclusione attuale: Fable 5.1 guida nelle capacità complessive, Kimi K3 in questo specifico test di documenti lunghi.
Perché usare Claude Fable 5.1 tramite API Hop?
Fatturazione a consumo e ottimizzazione dei costi del modello
Gli addebiti seguono le tariffe attuali API Hop e l’uso effettivo. Ricarica quando serve.
Modelli AI e API di dati unificati, con accesso a più modelli in un unico posto
Una chiave API collega più modelli AI e servizi di dati, riduce i costi di integrazione e permette di cambiare con un clic. Le applicazioni aziendali richiedono sia AI sia dati.
Registri delle chiamate e controlli di accesso, con chiarezza su ogni richiesta
Ogni chiamata API è registrata nella dashboard. Crea chiavi API separate per applicazioni diverse.
Valuta gli output rispetto al tuo compito
Usa l’ID modello documentato e i parametri supportati tramite API Hop. Valuta gli output con i tuoi criteri di accettazione, quindi controlla i registri d’uso e i metadati prima della produzione. Un nome di modello o un esempio non garantisce ogni risultato.
Come usare Claude Fable 5.1 su API Hop
Dopo aver creato una chiave API nella console, segui la documentazione per iniziare con Claude Fable 5.1.
Prepara l’account e prova online
Accedi, verifica il saldo e crea una chiave API.
Prova nell’area di test
Esplora le capacità del modello nell’area di prova per trovare il modo migliore di usarlo.
Integra Claude Fable 5.1 nella tua attività
Segui la nostra documentazione per sviluppatori per integrare Claude Fable 5.1 nella tua attività.
Aggiornamenti futuri del modello
Per passare a un modello più recente, verifica prima che il suo ID esatto sia restituito dal catalogo della tua chiave API. Se supporta lo stesso endpoint e gli stessi campi, aggiorna l’ID e testa formati di risposta, streaming, limiti di output e fatturazione prima del traffico di produzione. Per attività asincrone di immagini o video, verifica anche invio, polling dello stato e recupero dei risultati.
Domande frequenti sull’API Claude Fable 5.1
Claude Fable 5.1 è lo stesso modello API di Fable 5?
No. Claude Fable 5.1 (nome API: claude-fable-5-1) è una versione aggiornata di Claude Fable 5 (nome API: claude-fable-5). Usa il parametro model corretto nelle chiamate API.
Perché thinking è vuoto o la risposta incompleta?
Fable 5.1 nativo usa il ragionamento adattivo per impostazione predefinita e può ometterne il testo. Le richieste normali non richiedono thinking; un thinking vuoto da solo non è un errore. Se la risposta è incompleta, controlla lo stato di completamento e il budget di output, lasciando spazio sufficiente per ragionamento e testo finale.
Come risolvere errori di autenticazione, saldo o accesso?
Consulta la documentazione degli errori API per diagnosticare il problema.
Posso usare OpenAI Responses per Claude Fable 5.1?
OpenAI Responses non è supportato. Claude ha il proprio formato Claude Messages; consulta la documentazione per i dettagli.
Posso forzare una chiamata a uno strumento o modificare una conversazione Messages nativa?
Fable 5.1 nativo non supporta i tipi tool_choice forzati any o tool. Fai attenzione a riutilizzare il ragionamento conservato dopo aver modificato i messaggi precedenti. Mantieni intatti i blocchi di contenuto assistant nativi e le firme durante le continuazioni degli strumenti.
La memoria della conversazione è permanente?
No. L’API non conserva automaticamente il contesto per le richieste successive. Gestisci tu la cronologia e includi il contesto necessario in ogni richiesta. La memoria a lungo termine deve essere implementata dall’applicazione.
API di testo correlate
Esempi API e parametri supportati di Claude Fable 5.1
Avvio rapido dell’API Claude Fable 5.1
claude-fable-5-1model è obbligatorio; gli esempi usano l’ID modello della pagina corrente. Verifica l’accesso della tua chiave API con GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages richiede max_tokens. Il budget nell’esempio è modificabile, non è il valore predefinito del fornitore né un limite del modello. Il ragionamento può esaurirlo prima della risposta; adattalo al compito e verifica i costi di output.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Riferimento della famiglia e del protocollo
Claude Messages
Documentazione API completaAPI nativa compatibile con Claude Messages. Questo endpoint usa le strutture di richiesta e risposta Anthropic Messages, comprese chiamate agli strumenti ed eventi SSE Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages