将这些合成记录提取为含 id、owner、deadline、evidence 字段的 JSON:[R1] 问题 41:Ana 负责导出修复;尚未约定期限。[R2] 问题 42:审核期限为 10 月 15 日;未指定负责人,未说明年份。缺失值使用 null,保留原文的不完整日期。evidence 引用原文,不要猜测年份或负责人。逐字段核对来源;这只是文本整理,不是数据库操作。
Claude Fable 5.1 API:编程与研究分析
查看 Claude Fable 5.1 的 API 价格、多步骤编程与研究分析指南,了解推理配置、接口差异,并在线验证文本提示词。
Claude Fable 5.1 API 价格与计费
官方价格
- 输入
- $10.0000 /M
- 输出
- $50.0000 /M
- 缓存输入
- $0.2500 /M
- 缓存写入(5 分钟)
- $12.5000 /M
- 缓存写入(1 小时)
- $20.0000 /M
API Hop 当前价格 降低 45%
- 输入
- $5.5000 /M
- 输出
- $27.5000 /M
- 缓存输入
- $0.1375 /M
- 缓存写入(5 分钟)
- $6.8750 /M
- 缓存写入(1 小时)
- $11.0000 /M
参考价格,尚未独立核验。比较成本前,请核对供应商当前价格、计费单位及适用条件。
Claude Fable 5.1 在线对话工具
模型设置
记忆能做什么?
开启后,下次请求会附带当前对话中已完成且可复用的轮次,方便连续追问,无需重复背景。
关闭后会怎样?只发送新消息和已设置的系统提示词。已有消息仍会显示;重新开启后,符合条件的历史轮次会再次加入请求。
这是长期记忆吗?不是。这是当前对话的上下文,不会跨独立对话记忆。失败、停止、截断或无法复用的回复不会加入。历史越多,输入 Token 用量和费用可能越高。
高级参数
0 个字符起(0/无固定上限)
无固定字符上限;完整请求仍受请求大小和模型上下文限制。此处不是 Token 计数。 对话

今天有什么可以帮你?
暂无响应数据 就绪
Claude Fable 5.1 提示词示例
这些是 Claude Fable 5.1 的评估提示词,不是模型实测输出。仅分析提供的文本,不执行代码、不检查生产系统,也不证明长上下文表现。请核对引文与验收标准,并在用于生产前检查响应元数据和用量。
仅使用这份文档样本:[P1] 导出修复通过了预发布检查。[P2] 有人提议周五发布,但未获批准。[P3] Mei 将在周二审核错误提示。[P4] 文档工作尚未分配负责人。以表格返回结论、准确引文、段落编号和不确定性。生产发布是否已批准?谁负责文档?缺失事实标为未知。每段引文必须与样本一致,不要由预发布成功推断生产成功。这个小样本不测试最大上下文长度。
审查这份虚构的支付 Webhook 策略:每个失败的 POST 都重试三次,不保存幂等键,发送响应前先扣减余额。指出重复扣款风险,提出最小修改和三项验收测试。仅使用这些事实,不要假设能访问代码、工具或生产系统。
什么是 Claude Fable 5.1?
需要多步骤处理的编程与研究任务
Claude Fable 5.1 是 Anthropic 于 2026 年 9 月 1 日发布的模型,重点面向需要持续分析、多步骤处理和工具协作的任务。与只追求快速回答的使用方式相比,它更适合复杂代码问题、深入研究等需要深度思考的工作。官方规格为文本和图片输入、文本输出,提供 100 万 Token 上下文窗口和最高 128K Token 输出上限。Fable 5.1 的原生 API 默认 effort 为 high,通过推理强度控制来适应任务。
接入 API 前,先在线试用文本对话
API Hop 的在线工具能让你快速体验 Fable 5.1 的真实能力。你只需要登录并创建 Key,在少量充值后就可以立刻体验模型,在评估阶段尽可能减少各种成本,不用对接 API,不用买套餐,也无需单独开通 Anthropic 账号。
Claude Fable 5.1 适合哪些任务?
代码调试与审查
Anthropic 将跨代码库开发、代码审查和性能工作列为 Fable 5.1 的核心场景之一。在实际解决问题时,提供错误堆栈、相关代码、运行环境和复现步骤,Fable 5.1 会阅读编译报错、堆栈和陌生第三方库的源码,顺着代码依赖关系排查,给出解决方案。有客户反馈过一个极低概率的崩溃:团队多年都没有彻底解决,Fable 5.1 则通过反汇编外部库、对照崩溃转储,将问题追踪到库中的缺陷,最终解决了这个问题。
你也可以要求模型检查接口兼容性、异常分支、权限检查、资源释放和数据一致性。让它作为你经验丰富的副手,提出各种方案,但是决策还是需要开发者自己来做。
研究与分析
研究分析也是 Fable 5.1 的核心场景之一。Fable 5.1 不只在于总结资料,还在于能够围绕一个问题推进计算、观察结果并继续调整方案。有客户反馈,同一个问题,Fable 5 在优化过程中需要额外提示,而 Fable 5.1 在这次任务中不再需要同样的引导。在应用提供搜索或数据工具的情况下,Fable 5.1 可以围绕你的需求分析公开数据,撰写方案,给出评估结果;本页的文本对话本身不提供联网搜索。
当然,公开数据可能会有更多噪音。我们建议你在了解业务的情况下,构建自己的可信数据源,或者使用 API Hop 提供的数据 API。API Hop 的数据 API 经过我们开发和业务人员的精心挑选。
写作与文档起草
Fable 5.1 在写作上的主要进步,是表达更容易理解、对写作要求的遵循更好,而不只是能够生成更长的文章。针对 Fable 5.1 的写作能力,Anthropic 官方指南建议始终将 Fable 5.1 放在助手的位置,而非主要内容输出者,并且你始终需要对 AI 的内容进行审核和判断。
Anthropic 建议在提示词中写明内容受众是谁、读者想要得到什么信息或者解决什么问题、内容中必须包含哪些信息,以及哪些表述不能出现。与“写一篇专业文章”相比,提供具体目标、结构和示例更有利于得到可用初稿。
长文档与多轮讨论
在 Artificial Analysis 的对比中,Fable 5.1 的综合指数高于 Kimi K3,但在 AA-LCR v1.1 长上下文推理项目中,前者为 85%,后者为 89%;对应配置分别是 Fable 5.1 的 Max、Default Fallback 和 Kimi K3 的 Max。这意味着 Kimi K3 在这项长文推理测试中领先,不能据此将 Fable 5.1 称为“长文能力最强的模型”。
然而,长流程经过上下文压缩后,重要约束、已经作出的决定或精确细节可能丢失,Anthropic 的提示指南对此有专门说明。如果你有工程能力,我们建议你把核心内容保留在每次对话中。
Claude Fable 5.1 基准测试:编程、推理与速度
以下分别呈现 Anthropic 发布评测与 Artificial Analysis 独立评测;两者设置不同,且均非 API Hop 实测。
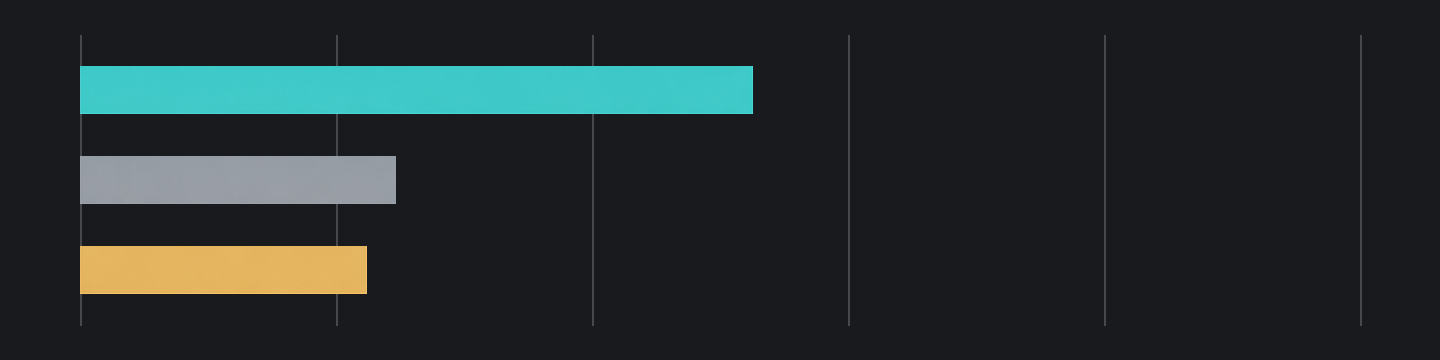
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
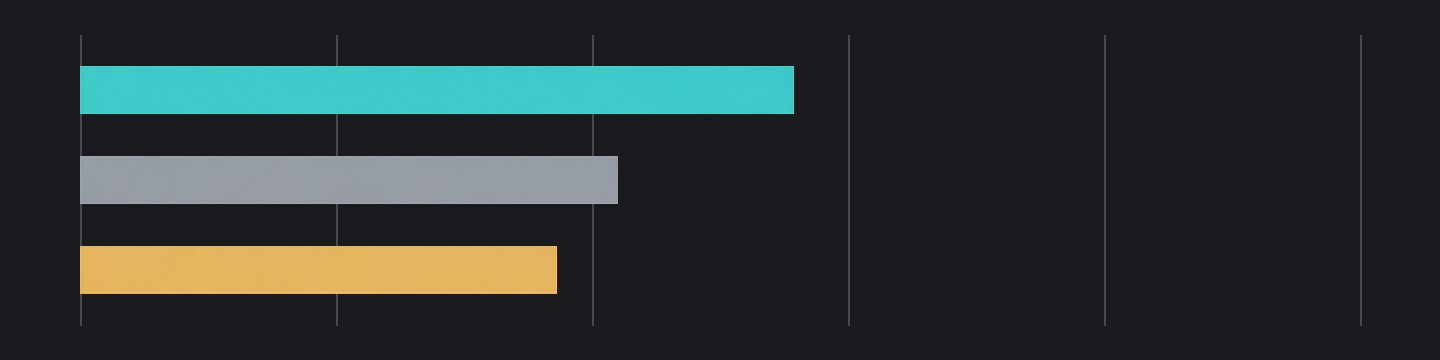
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
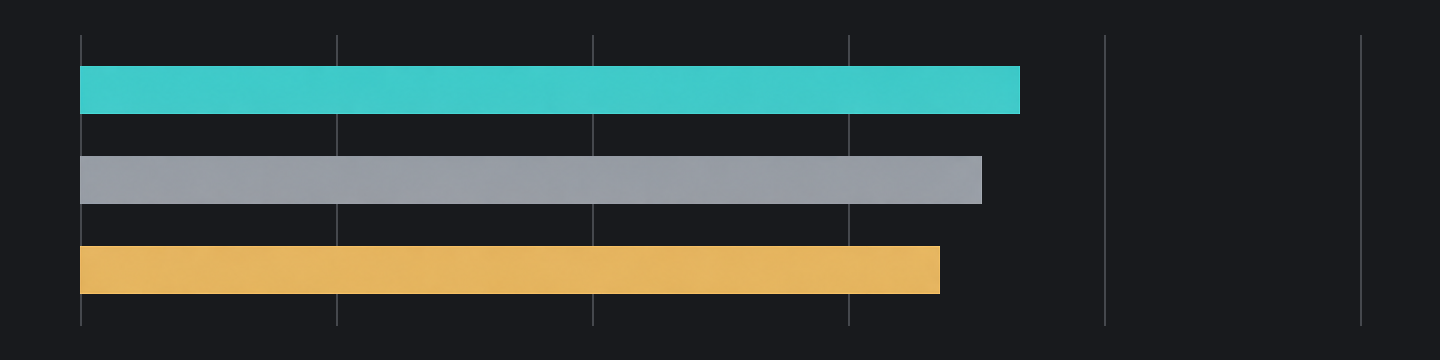
Fable 5.1: 60.9%Fable 5: 57.8%
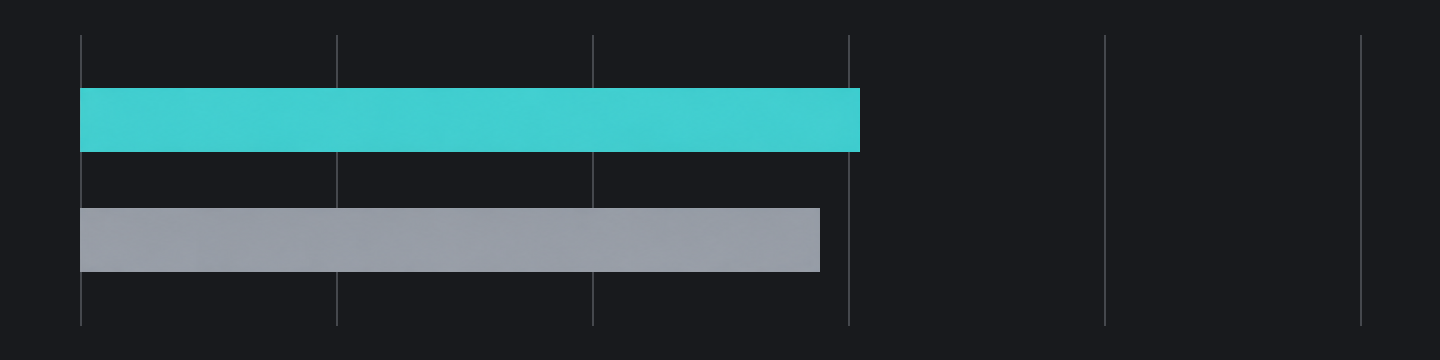
Fable 5.1: 65.0%Fable 5: 63.8%
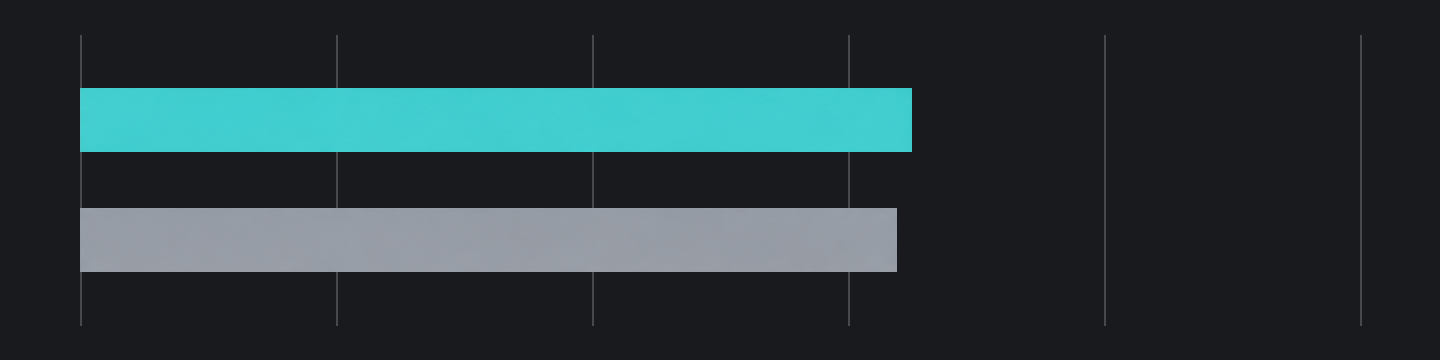
编程:最大增幅集中在终端任务
Fable 5.1 最明确的编程进步,集中在需要操作环境、处理执行结果并持续推进的终端任务,而不是所有代码任务的平均提升。在 Anthropic 公布的成绩中,它相对 Fable 5 在 Terminal-Bench-Science 0.1 上提高了 27.9 个百分点,在 Terminal-Bench 4.0 上提高了 13.8 个百分点,而 CursorBench 3.2.0 的增幅为 2.9 个百分点。这几项结果的差异,让我更倾向于把它理解为复杂任务执行能力的增强,而不只是代码生成质量的普遍跃升。
这类进步的价值,在于模型能够把分析与实际操作连接起来。Anthropic 对其编程能力的说明包括跨代码库开发、自行编写测试,以及借助视觉结果检查实现是否符合目标。我们的理解是,它更有机会沿着“理解问题、修改、验证、继续修正”的过程完成工作,而不是停留在提出一个看似合理的解决方案。
推理:增幅较小且随设置变化
推理能力有所增强,但在已公布的部分推理测试中,提升没有终端任务那么大。Humanity’s Last Exam 的无工具成绩从 Fable 5 的 57.8% 提高到 60.9%,有工具成绩则从 63.8% 提高到 65.0%,分别增加 3.1 和 1.2 个百分点。
我们也不认为 effort 只是一个“越高越聪明”的开关。Anthropic 的官方指南将它定义为能力、延迟和成本之间的主要调节项,并明确指出,不同模型上相同的 effort 名称,并不对应相同的思考量。
社区讨论提供了一个值得保留的反例。Hacker News 用户 seaurchinzee 根据系统卡指出,Fable 5.1 在 FrontierCode Extended 上并非最高 effort 表现最好,较高设置还可能增加未经请求的修改。这是对特定编程评测的解读,不是 HLE 的结果,但它提醒我:更多推理不一定等于更符合任务要求,正确性之外还要考虑是否保持了原定范围。官方提示指南也单独列出了额外修改和任务范围扩张的问题。
独立指数与生成速度:两个不同问题
我们认为 Fable 5.1 的综合能力和响应速度需要分开评价,不能用一个分数概括使用体验。截至 2026 年 10 月 4 日核验,Artificial Analysis 为其 Max、Default Fallback 配置记录的 Intelligence Index 为 53。输出速率约为 66.2 Token/秒,首 Token 等待时间约为 259.12 秒。
同一个 SVG 绘图任务,high 用时约 29.6 秒,max 用时约 13 分 54 秒;我们认为最高强度的结果更好,但等待和输出用量也明显增加。结论是,Fable 5.1 能够通过更多推理改善部分复杂产物。
Claude Fable 5.1 与 Fable 5、GPT-5.6 Sol、Kimi K3 对比
支持 Fable 5.1 的最直接证据,仍然是终端任务的成绩差距。以下是 Anthropic 的一份发布评测。
Fable 5.1: 53Kimi K3: 44
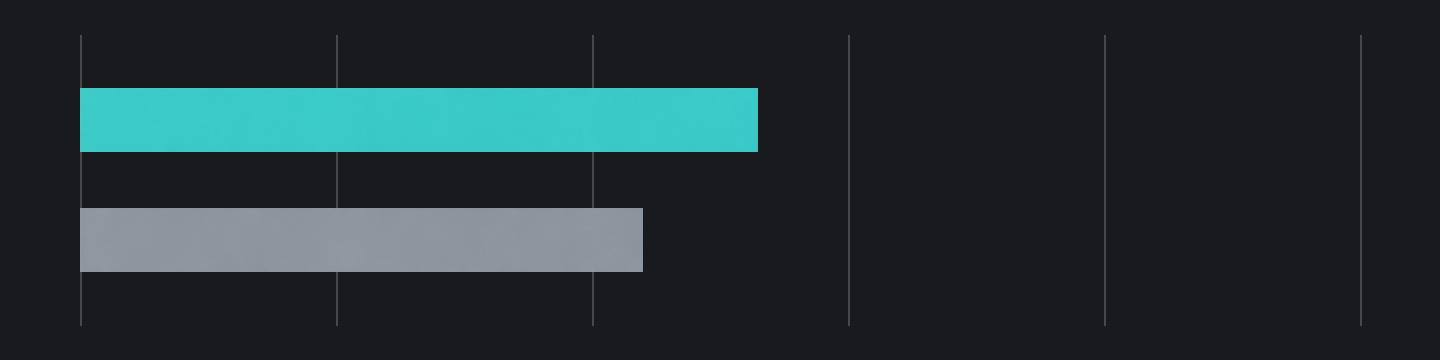
Fable 5.1: 52%Kimi K3: 13%
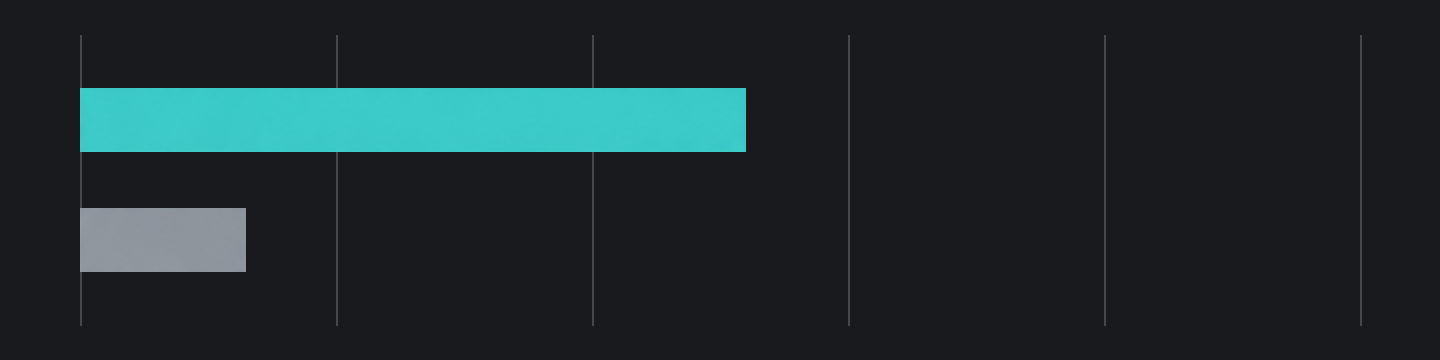
Fable 5.1: 85%Kimi K3: 89%
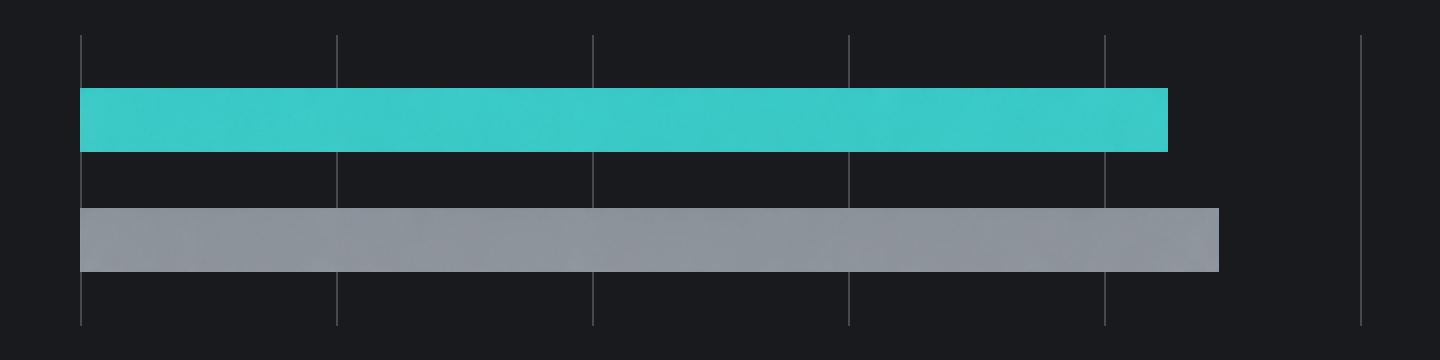
| 评测项目 | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
对比 Fable 5 与 GPT-5.6 Sol:终端编程优势最明确
从这些成绩看,Fable 5.1 相对 GPT-5.6 Sol 的优势,在两个终端项目上比 CursorBench 更突出。有客户反馈,Fable 5.1 在其测试中达到或略高于 Fable 5 的表现,同时降低了单项任务成本,因而开始将其用于代码审查。
对比 Kimi K3:长文推理改变排序
我们对 Fable 5.1 和 Kimi K3 的判断是:前者在这组综合评测中更强。Artificial Analysis 的对比页面显示,Fable 5.1 的综合指数为 53,Kimi K3 为 44;在 Terminal-Bench 4.0 上,两者分别为 52% 和 13%。到了 AA-LCR v1.1 长上下文推理项目,排序发生了变化:Fable 5.1 为 85%,Kimi K3 为 89%。
可能有些人会更喜欢 Kimi K3 的解释,会在代码审查和理解问题时切换过去使用。目前我们的结论是:Fable 5.1 具有综合能力优势,Kimi K3 则在这项长文测试中领先。
为什么通过 API Hop 使用 Claude Fable 5.1?
按需计费与模型成本优化
按当前 API Hop 单价和实际用量计费,按需充值。
统一 AI模型 与数据 API,一站式多模型接入
一个密钥多个AI模型和数据模型,节省对接成本,一键切换,业务需要的场景必然是AI+数据
调用记录与应用权限控制,每一次调用明明白白
每一笔调用记录都可以在后台查到,可以设置多个密钥对应不同的应用
按任务验收模型输出
通过 API Hop 使用文档列出的模型 ID 与支持参数。按自己的验收标准评估输出,投入生产前核对用量记录与响应元数据;模型名称或演示样例不保证每次结果。
如何在 API Hop 中使用 Claude Fable 5.1
在后台创建完密钥后,就可以根据文档来接入 Claude Fable 5.1。
准备账户并进行在线测试
登录并确认余额,创建一个 API 密钥。
在 Playground 中体验
可以在 Playground 中体验模型的能力,确定最佳的模型使用方案。
将 Claude Fable 5.1 集成到你的业务中
根据我们提供的开发文档,将 Claude Fable 5.1 集成到业务中。
后续的模型升级
升级前先确认 API Key 的模型列表已返回新型号的准确 ID。仅在新旧模型支持相同接口和请求字段时更换 model,并验证返回格式、流式行为、输出上限与费用后再切换生产流量。涉及异步图片或视频任务时,还应验证任务提交、状态查询与结果获取流程。
Claude Fable 5.1 API 常见问题
Claude Fable 5.1 与 Fable 5 是同一个 API 模型吗?
不是。Claude Fable 5.1(接口使用模型名称:claude-fable-5-1)是 Claude Fable 5(接口使用模型名称:claude-fable-5)的升级版模型,调用时请勿传错 model 参数。
为什么 thinking 为空,或者回答不完整?
原生 Fable 5.1 默认启用自适应思考,可以省略思考文本;普通调用无需填写 thinking 参数,空 thinking 不代表失败。 如果回答不完整,请检查结束状态及输出额度,为思考和最终正文留出足够空间。
可以通过 OpenAI Responses 调用 Claude Fable 5.1 吗?
不支持 OpenAI Responses。Claude 有自己的 Claude Messages 格式,详情参考文档。
可以强制调用工具或编辑原生 Messages 会话吗?
原生 Fable 5.1 不支持 tool_choice 的 any 或 tool 强制模式。 修改早期会话内容后重放保留的思考块也需谨慎。工具续轮应完整保留原生 assistant 内容块及其中的签名。
对话记忆是长期记忆吗?
不是。API 不会自动为后续请求保留对话上下文;你需要自行管理会话历史,并在请求中传入所需内容。长期记忆需要由应用实现。
相关文本 API
Claude Fable 5.1 API 示例与支持参数
Claude Fable 5.1 API 快速调用
claude-fable-5-1model 为必填字段,示例使用当前页面的模型 ID。请先通过 GET /v1/models 核对 API Key 的模型访问权限。
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages 必须填写 max_tokens。示例额度可调整,不是上游默认值或模型上限。思考可能在生成正文前耗尽该额度;请按任务调整并检查输出费用。
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
家族与协议参考
Claude Messages
完整 API 文档Claude 原生 Messages 兼容接口。该接口使用 Anthropic Messages 请求和响应格式,适合 Claude Code、工具调用、流式输出和需要 Anthropic 原生事件格式的应用。
POST
https://api.apihop.ai/anthropic/v1/messages