Extrayez ces enregistrements synthétiques en JSON avec id, owner, deadline et evidence : [R1] Ticket 41 : Ana gère la correction d’export ; aucune échéance convenue. [R2] Ticket 42 : revue pour le 15 octobre ; responsable non désigné ; année absente. Utilisez null pour les valeurs manquantes, gardez les dates partielles et citez la source dans evidence. N’inventez ni année ni responsable. Vérifiez chaque champ avec son enregistrement ; c’est du formatage de texte, pas une opération de base de données.
API Claude Fable 5.1 pour le code et la recherche
Comparez les tarifs API et options d’intégration de Claude Fable 5.1 pour le code et la recherche en plusieurs étapes. Consultez les conseils de raisonnement et testez des prompts textuels en ligne.
Tarifs et facturation de l’API Claude Fable 5.1
Prix officiel
- Entrée
- $10.0000 /M
- Sortie
- $50.0000 /M
- Entrée en cache
- $0.2500 /M
- Écriture en cache (5 min)
- $12.5000 /M
- Écriture en cache (1 h)
- $20.0000 /M
Tarif API Hop Économie 45%
- Entrée
- $5.5000 /M
- Sortie
- $27.5000 /M
- Entrée en cache
- $0.1375 /M
- Écriture en cache (5 min)
- $6.8750 /M
- Écriture en cache (1 h)
- $11.0000 /M
Prix de référence non vérifié indépendamment. Consultez les tarifs actuels, unités de facturation et conditions applicables de l’éditeur avant de comparer les coûts.
Outil de chat en ligne Claude Fable 5.1
Paramètres du modèle
À quoi sert la mémoire ?
Elle inclut les échanges terminés et réutilisables de cette conversation dans la prochaine requête, pour poser des questions de suivi sans répéter le contexte.
Que se passe-t-il si elle est désactivée ?Seuls votre nouveau message et une éventuelle instruction système sont envoyés. Les anciens messages restent visibles ; réactiver la mémoire réintègre les échanges précédents admissibles.
Est-ce une mémoire à long terme ?Non. Il s’agit du contexte de cette conversation, pas d’une mémoire entre conversations distinctes. Les réponses échouées, arrêtées, tronquées ou non réutilisables sont exclues. Un historique plus long peut consommer davantage de tokens d’entrée et augmenter le coût.
Paramètres avancés
0 caractère ou plus(0/Pas de limite fixe)
Pas de limite fixe de caractères ; la requête complète reste soumise aux limites de taille et de contexte du modèle. Ce n’est pas un nombre de tokens. Conversation

Comment puis-je vous aider aujourd’hui ?
Aucune donnée de réponse pour le moment Prêt
Exemples de prompts pour Claude Fable 5.1
Ce sont des prompts d’évaluation pour Claude Fable 5.1, pas des sorties enregistrées. Ils analysent uniquement le texte fourni ; ils n’exécutent pas de code, n’inspectent pas les systèmes de production et ne prouvent pas les performances en contexte long. Vérifiez les preuves citées et les critères d’acceptation, puis les métadonnées et l’utilisation avant la mise en production.
Utilisez uniquement cet extrait : [P1] La correction d’export a passé les vérifications de préproduction. [P2] Une publication vendredi a été proposée, pas approuvée. [P3] Mei examinera les erreurs mardi. [P4] Aucun responsable pour la documentation. Renvoyez un tableau : affirmation, citation exacte, ID de paragraphe, incertitude. La mise en production est-elle approuvée ? Qui gère la documentation ? Notez les faits manquants comme inconnus. Toute citation doit correspondre à l’extrait ; ne déduisez pas un succès en production de la préproduction. Ce petit exemple ne teste pas la longueur maximale du contexte.
Examinez cette politique fictive de webhook de paiement : chaque POST échoué est relancé trois fois, aucune clé d’idempotence n’est stockée et le solde est débité avant l’envoi de la réponse. Identifiez les risques de double débit, proposez des changements minimaux et trois tests d’acceptation. Utilisez uniquement ces faits ; ne supposez aucun accès au code, aux outils ou à la production.
Qu’est-ce que Claude Fable 5.1 ?
Programmation et recherche en plusieurs étapes
Claude Fable 5.1 est un modèle Anthropic publié le 1 septembre 2026, axé sur l’analyse prolongée, les tâches à étapes multiples et la collaboration avec des outils. Il convient aux problèmes de programmation complexes et aux recherches approfondies, plutôt qu’aux seules réponses rapides. Il accepte nativement texte et images, produit du texte, dispose d’un million de tokens de contexte et de jusqu’à 128K tokens de sortie. Son API native utilise high par défaut, avec un effort adaptable à la tâche.
Tester le chat avant d’intégrer l’API
L’outil API Hop permet d’essayer rapidement Fable 5.1 : connectez-vous, créez une clé API et ajoutez un peu de crédit, sans intégration ni abonnement. Aucun compte Anthropic distinct n’est nécessaire, mais cela ne garantit pas l’absence de restrictions ; les conditions de la plateforme s’appliquent. Cette page propose du texte, pas d’importation de fichiers, de navigation web ou d’exécution de code.
À quoi utiliser Claude Fable 5.1 ?
Débogage et revue de code
Anthropic cite développement entre bases de code, revue et performances parmi les usages clés de Fable 5.1. Fournissez traces, code, environnement et étapes de reproduction : il peut lire erreurs du compilateur, piles et sources de bibliothèques inconnues pour suivre les dépendances et proposer une solution. Un client a décrit un crash rare non résolu depuis des années : Fable 5.1 a désassemblé une bibliothèque externe, comparé les dumps et identifié puis résolu son défaut.
Vous pouvez aussi lui faire vérifier compatibilité, exceptions, permissions, libération des ressources et cohérence des données. Traitez-le comme un assistant expérimenté proposant des options ; les développeurs restent responsables des décisions.
Recherche et analyse
La recherche et l’analyse sont aussi centrales. Au-delà des résumés, Fable 5.1 peut poursuivre des calculs, observer les résultats et adapter son approche. Un client rapporte qu’une optimisation exigeait davantage de consignes avec Fable 5, mais plus avec Fable 5.1. Avec des outils de recherche ou de données fournis par l’application, il peut analyser des données publiques et rédiger propositions et évaluations ; cette page textuelle ne navigue pas sur le web.
Les données publiques peuvent être très bruitées. Nous suggérons des sources fiables fondées sur votre connaissance métier, ou les API de données API Hop sélectionnées par nos équipes techniques et métier.
Rédaction de textes et de documents
Les principales améliorations rédactionnelles de Fable 5.1 sont la clarté et le respect des consignes, pas seulement des articles plus longs. Anthropic conseille de garder le modèle comme assistant, non comme auteur principal, et de continuer à relire et juger les contenus générés.
Anthropic recommande de préciser public, informations ou problèmes du lecteur, contenu obligatoire et formulations à éviter. Objectifs concrets, structure et exemples donnent plus facilement un brouillon utile qu’une simple demande d’article professionnel.
Documents longs et échanges en plusieurs tours
Chez Artificial Analysis, Fable 5.1 dépasse Kimi K3 sur l’indice global, mais obtient 85% contre 89% pour Kimi K3 sur AA-LCR v1.1 en contexte long. Les configurations sont Fable 5.1 Max avec Default Fallback et Kimi K3 Max. Kimi K3 mène donc ce test précis ; cela ne permet pas de qualifier Fable 5.1 de meilleur modèle pour les longs documents.
Après compression du contexte dans un long flux, contraintes, décisions ou détails précis peuvent se perdre, comme l’explique Anthropic. Si votre application le permet, conservez les informations essentielles dans chaque conversation.
Benchmarks Claude Fable 5.1 : code, raisonnement et vitesse
Les évaluations de lancement Anthropic et indépendantes d’Artificial Analysis sont séparées ci-dessous. Leurs réglages diffèrent et aucune n’est une mesure API Hop.
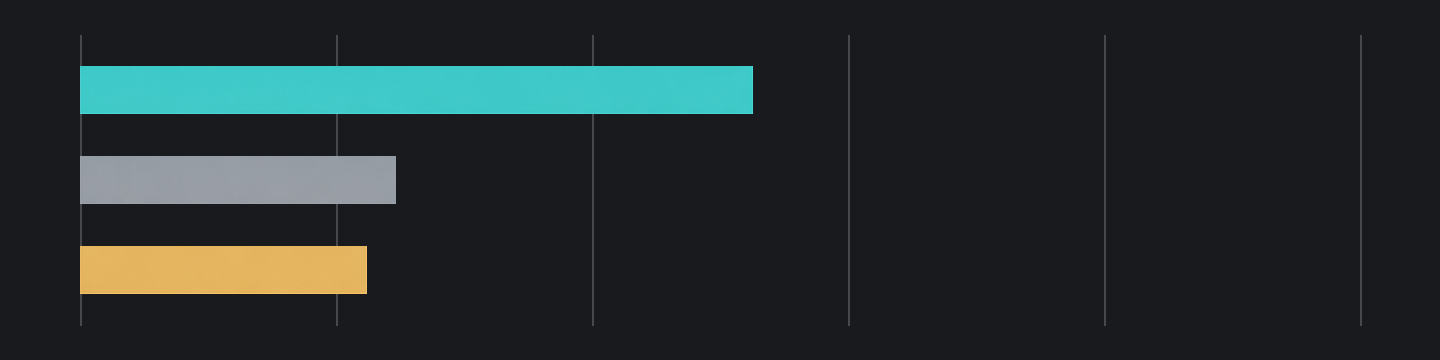
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
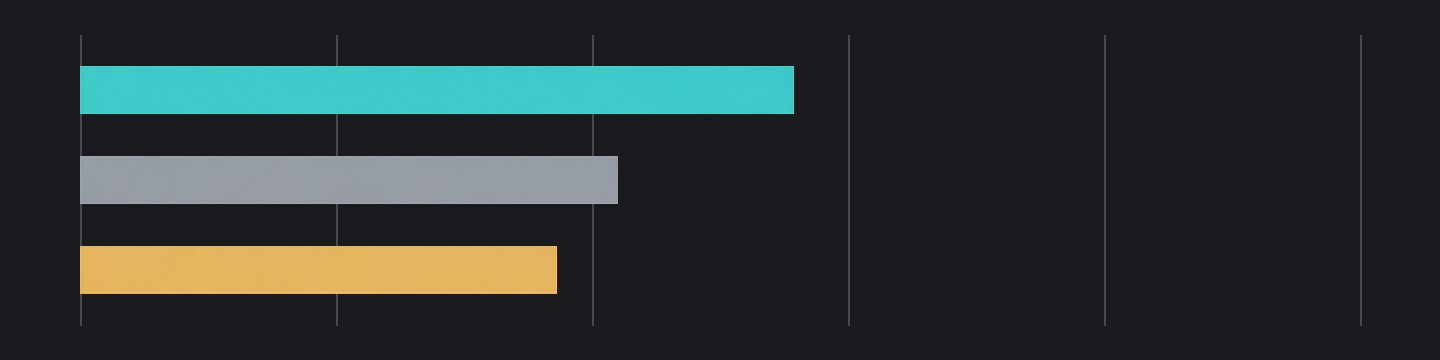
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
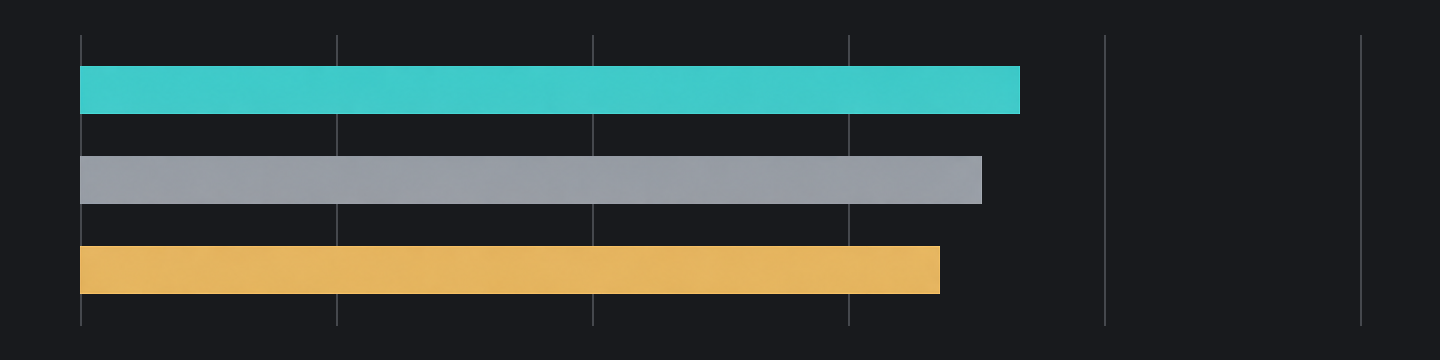
Fable 5.1: 60.9%Fable 5: 57.8%
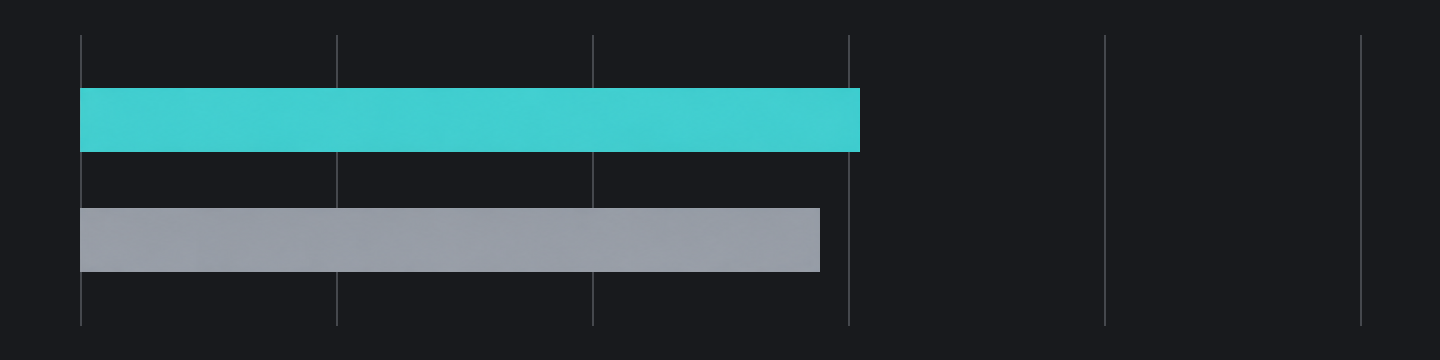
Fable 5.1: 65.0%Fable 5: 63.8%
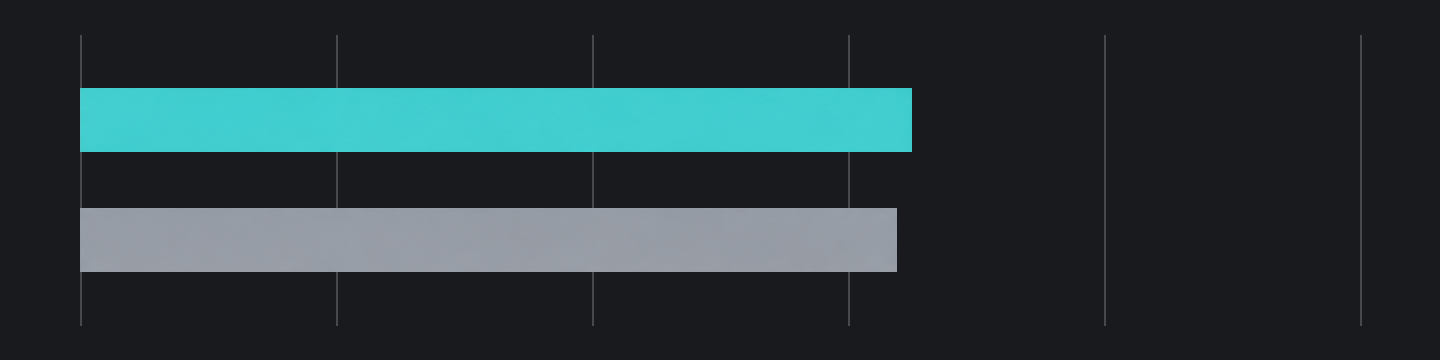
Code : le plus grand progrès concerne le terminal
Le progrès le plus net de Fable 5.1 concerne les tâches de terminal nécessitant d’agir dans un environnement, traiter les résultats et poursuivre, plutôt qu’une hausse uniforme en programmation. Anthropic annonce face à Fable 5 des gains de 27.9 points sur Terminal-Bench-Science 0.1, 13.8 sur Terminal-Bench 4.0 et 2.9 sur CursorBench 3.2.0. Cela suggère une meilleure exécution complexe, pas un bond uniforme de génération de code.
La valeur réside dans le lien entre analyse et action. Anthropic décrit développement entre bases de code, rédaction autonome de tests et vérification visuelle des objectifs. Nous y voyons une meilleure aptitude à comprendre, modifier, vérifier et affiner une solution plutôt qu’à s’arrêter à une proposition plausible.
Raisonnement : gains plus modestes selon les réglages
Le raisonnement progresse, mais certains gains restent inférieurs à ceux du terminal. Sur Humanity's Last Exam, sans outils on passe de 57.8% pour Fable 5 à 60.9%, et avec outils de 63.8% à 65.0% : gains de 3.1 et 1.2 points.
Nous ne voyons pas l’effort comme un bouton où plus élevé signifie toujours plus intelligent. Anthropic le définit comme un contrôle majeur de capacité, latence et coût, en précisant que des étiquettes identiques entre modèles ne représentent pas le même volume de réflexion.
La communauté fournit un contre-exemple. L’utilisateur Hacker News seaurchinzee interprète la fiche système comme montrant que l’effort maximal n’est pas le meilleur sur FrontierCode Extended et peut accroître les changements non demandés. Il s’agit d’un test de code, pas de HLE, mais davantage de raisonnement ne garantit pas le respect de la tâche. Le périmètre compte autant que l’exactitude ; Anthropic traite séparément les changements supplémentaires et leur extension.
Indice indépendant et débit : deux questions distinctes
Nous évaluons séparément capacité globale et vitesse de Fable 5.1. Lors de la vérification du 4 octobre 2026, Artificial Analysis indique pour Max, Default Fallback un indice d’intelligence de 53, environ 66.2 tokens de sortie par seconde et environ 259.12 secondes avant le premier token.
Sur le même dessin SVG, high a pris environ 29.6 secondes et max environ 13 minutes 54 secondes. Nous jugeons meilleur le résultat à effort maximal, mais l’attente et la sortie ont fortement augmenté. Davantage de raisonnement peut améliorer certaines sorties complexes.
Claude Fable 5.1 face à Fable 5, GPT-5.6 Sol et Kimi K3
La preuve la plus directe en faveur de Fable 5.1 reste son avance dans le terminal. Le tableau suivant est une évaluation de lancement Anthropic.
Fable 5.1: 53Kimi K3: 44
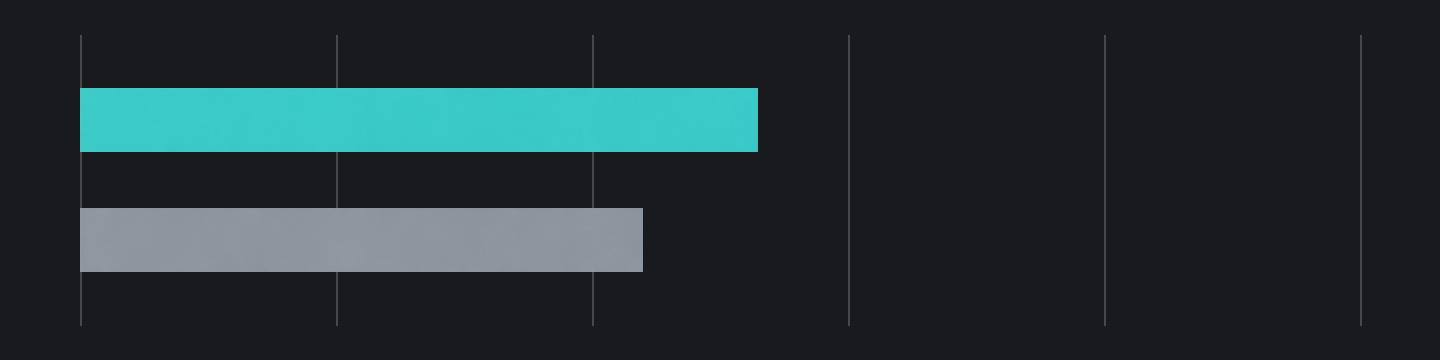
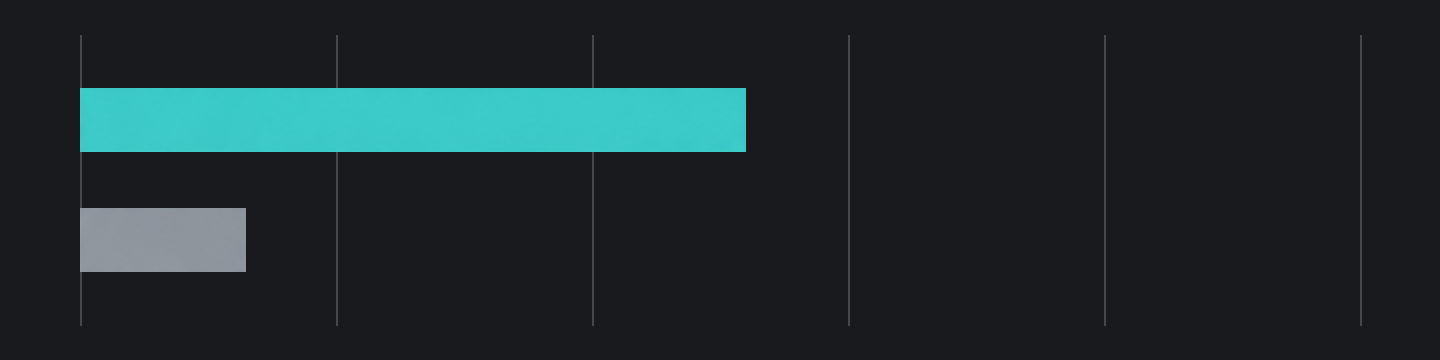
Fable 5.1: 52%Kimi K3: 13%
Fable 5.1: 85%Kimi K3: 89%
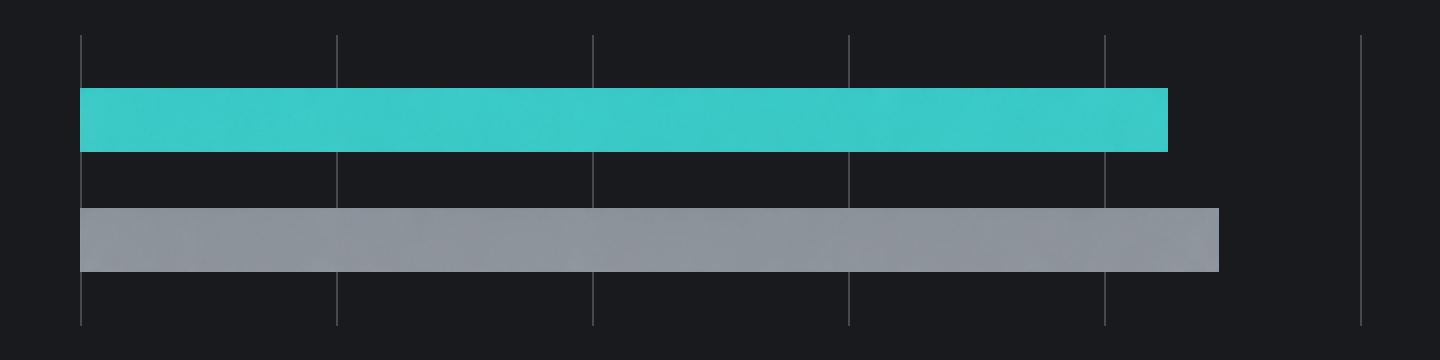
| Test de référence | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Face à Fable 5 et GPT-5.6 Sol : avance la plus nette dans le code en terminal
Les scores montrent une avance de Fable 5.1 sur GPT-5.6 Sol plus grande dans les deux benchmarks de terminal que dans CursorBench. Un client indique que Fable 5.1 égalait ou dépassait légèrement Fable 5 avec un coût par tâche réduit, l’incitant à l’utiliser en revue de code.
Face à Kimi K3 : le raisonnement sur longs documents inverse le classement
Nous jugeons Fable 5.1 plus fort sur l’évaluation globale de cette comparaison. Artificial Analysis donne un indice de 53 à Fable 5.1 et 44 à Kimi K3, avec 52% et 13% sur Terminal-Bench 4.0. Sur AA-LCR v1.1 en contexte long, l’ordre s’inverse : Fable 5.1 85%, Kimi K3 89%.
Certains préfèrent les explications de Kimi K3 et l’utilisent pour revoir le code ou comprendre un problème. Notre conclusion actuelle : Fable 5.1 mène en capacité globale, Kimi K3 sur ce test précis de longs documents.
Pourquoi utiliser Claude Fable 5.1 via API Hop ?
Facturation à l’usage et optimisation des coûts du modèle
Les frais suivent les tarifs actuels de API Hop et l’utilisation réelle. Rechargez selon vos besoins.
Modèles IA et API de données unifiés, avec accès à plusieurs modèles au même endroit
Une clé API relie plusieurs modèles IA et services de données, réduit les coûts d’intégration et permet de changer en un clic. Les applications métier ont besoin à la fois d’IA et de données.
Journaux d’appels et contrôles d’accès applicatifs, pour chaque appel en toute transparence
Chaque appel API est consigné dans votre tableau de bord. Créez des clés API distinctes pour différentes applications.
Évaluez les sorties selon votre tâche
Utilisez l’ID documenté du modèle et les paramètres pris en charge via API Hop. Évaluez les sorties selon vos critères d’acceptation, puis vérifiez les relevés d’utilisation et les métadonnées avant la production. Un nom de modèle ou un exemple ne garantit pas chaque résultat.
Comment utiliser Claude Fable 5.1 sur API Hop
Après avoir créé une clé API dans la console, suivez la documentation pour démarrer avec Claude Fable 5.1.
Préparez votre compte et testez en ligne
Connectez-vous, vérifiez votre solde et créez une clé API.
Essayez dans l’espace de test
Explorez les capacités du modèle dans l’espace de test pour trouver la meilleure façon de l’utiliser.
Intégrez Claude Fable 5.1 à votre activité
Suivez notre documentation développeur pour intégrer Claude Fable 5.1 à votre activité.
Futures mises à niveau du modèle
Pour passer à un modèle plus récent, vérifiez d’abord que son ID exact est renvoyé par le catalogue de votre clé API. S’il prend en charge le même endpoint et les mêmes champs, modifiez l’ID puis testez formats de réponse, streaming, limites de sortie et facturation avant la production. Pour les tâches asynchrones d’image ou de vidéo, vérifiez aussi l’envoi, le suivi du statut et la récupération des résultats.
Questions fréquentes sur l’API Claude Fable 5.1
Claude Fable 5.1 est-il le même modèle API que Fable 5 ?
Non. Claude Fable 5.1 (nom API : claude-fable-5-1) est une version améliorée de Claude Fable 5 (nom API : claude-fable-5). Utilisez le bon paramètre model lors de l’appel API.
Pourquoi thinking est-il vide ou la réponse incomplète ?
Fable 5.1 natif utilise la réflexion adaptative par défaut et peut omettre son texte. Les requêtes ordinaires n’ont pas besoin du paramètre thinking ; un thinking vide ne suffit pas à signaler un échec. Si la réponse est incomplète, vérifiez l’état de fin et le budget de sortie, en réservant assez de place à la réflexion et au texte final.
Comment diagnostiquer les erreurs d’authentification, de solde ou d’accès ?
Suivez la documentation des erreurs API pour diagnostiquer le problème.
Puis-je utiliser OpenAI Responses pour Claude Fable 5.1 ?
OpenAI Responses n’est pas pris en charge. Claude possède son propre format Claude Messages ; consultez la documentation.
Puis-je forcer un appel d’outil ou modifier une conversation Messages native ?
Fable 5.1 natif ne prend pas en charge les types tool_choice forcés any ou tool. Soyez prudent lorsque vous réutilisez la réflexion conservée après modification de messages antérieurs. Préservez les blocs de contenu assistant natifs et leurs signatures pendant les continuations d’outils.
La mémoire de conversation est-elle permanente ?
Non. L’API ne conserve pas automatiquement le contexte pour les requêtes suivantes. Gérez vous-même l’historique et joignez le contexte nécessaire à chaque requête. La mémoire à long terme doit être implémentée par votre application.
API de texte associées
Exemples API et paramètres pris en charge de Claude Fable 5.1
Démarrage rapide de l’API Claude Fable 5.1
claude-fable-5-1model est obligatoire ; ces exemples utilisent l’ID du modèle de cette page. Vérifiez l’accès de votre clé API avec GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages exige max_tokens. Le budget de cet exemple est modifiable ; ce n’est ni une valeur par défaut du fournisseur ni une limite du modèle. La réflexion peut l’épuiser avant toute réponse ; adaptez-le à votre tâche et vérifiez les coûts de sortie.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Référence de la famille et du protocole
Claude Messages
Documentation API complèteAPI native compatible Claude Messages. Cet endpoint utilise les formats de requête et de réponse Anthropic Messages, y compris les appels d’outils et les événements SSE Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages