Extrahieren Sie diese synthetischen Datensätze als JSON mit id, owner, deadline und evidence: [R1] Vorgang 41: Ana betreut die Exportkorrektur; keine Frist vereinbart. [R2] Vorgang 42: Prüfung fällig am 15. Oktober; niemand zugewiesen; Jahr fehlt. Verwenden Sie null für fehlende Werte und erhalten Sie unvollständige Datumsangaben. Zitieren Sie die Quelle in evidence. Erfinden Sie kein Jahr und keine Zuständigkeit. Prüfen Sie jedes Feld gegen seinen Datensatz; es ist Textformatierung, keine Datenbankoperation.
Claude Fable 5.1 API für Programmierung und Recherche
Vergleichen Sie Claude Fable 5.1 API-Preise und Integrationsmöglichkeiten für mehrstufige Programmierung und Recherche. Lesen Sie Reasoning-Hinweise und testen Sie Textprompts online.
API-Preise und Abrechnung für Claude Fable 5.1
Offizieller Preis
- Eingabe
- $10.0000 /M
- Ausgabe
- $50.0000 /M
- Cache-Eingabe
- $0.2500 /M
- Cache-Schreibzugriff (5 Min.)
- $12.5000 /M
- Cache-Schreibzugriff (1 Std.)
- $20.0000 /M
API Hop-Preis Sparen 45%
- Eingabe
- $5.5000 /M
- Ausgabe
- $27.5000 /M
- Cache-Eingabe
- $0.1375 /M
- Cache-Schreibzugriff (5 Min.)
- $6.8750 /M
- Cache-Schreibzugriff (1 Std.)
- $11.0000 /M
Referenzpreis – nicht unabhängig geprüft. Prüfen Sie vor einem Kostenvergleich die aktuellen Tarife, Abrechnungseinheiten und geltenden Bedingungen des Anbieters.
Online-Chatwerkzeug für Claude Fable 5.1
Modelleinstellungen
Was bewirkt das Gedächtnis?
Abgeschlossene, wiederverwendbare Gesprächsrunden werden in die nächste Anfrage aufgenommen. So sind Rückfragen möglich, ohne den Kontext zu wiederholen.
Was passiert bei ausgeschaltetem Gedächtnis?Nur Ihre neue Nachricht und ein gegebenenfalls vorhandener System-Prompt werden gesendet. Vorherige Nachrichten bleiben sichtbar; nach dem Einschalten werden geeignete frühere Gesprächsrunden wieder einbezogen.
Ist dies ein Langzeitgedächtnis?Nein. Es ist der Kontext dieses Gesprächs, kein Gedächtnis über getrennte Gespräche hinweg. Fehlgeschlagene, gestoppte, gekürzte oder nicht wiederverwendbare Antworten sind ausgeschlossen. Mehr Verlauf kann mehr Eingabe-Token verbrauchen und die Kosten erhöhen.
Erweiterte Parameter
0 oder mehr Zeichen(0/Keine feste Grenze)
Keine feste Zeichengrenze; für die gesamte Anfrage gelten Größen- und Modellkontextgrenzen. Dies ist keine Token-Zählung. Unterhaltung

Wie kann ich Ihnen heute helfen?
Noch keine Antwortdaten Bereit
Prompt-Beispiele für Claude Fable 5.1
Dies sind Evaluierungs-Prompts für Claude Fable 5.1, keine aufgezeichneten Modellausgaben. Sie analysieren nur den bereitgestellten Text; sie führen keinen Code aus, prüfen keine Produktionssysteme und belegen keine Langkontext-Leistung. Prüfen Sie zitierte Belege und Abnahmekriterien sowie vor dem Produktionseinsatz Antwortmetadaten und Nutzung.
Nutzen Sie nur dieses Dokumentbeispiel: [P1] Die Exportkorrektur bestand Staging-Prüfungen. [P2] Eine Freitagsveröffentlichung wurde vorgeschlagen, nicht genehmigt. [P3] Mei prüft Fehlermeldungen am Dienstag. [P4] Der Dokumentation ist niemand zugewiesen. Erstellen Sie eine Tabelle aus Aussage, exakt stützendem Zitat, Absatz-ID und Unsicherheit. Ist die Produktionsfreigabe genehmigt? Wer ist für die Dokumentation zuständig? Fehlende Fakten sind unbekannt. Jedes Zitat muss dem Beispiel entsprechen; aus Staging folgt kein Produktionserfolg. Das kleine Beispiel testet nicht die maximale Kontextlänge.
Prüfen Sie diese fiktive Zahlungs-Webhook-Regel: Jeder fehlgeschlagene POST wird dreimal wiederholt, kein Idempotenzschlüssel wird gespeichert und das Guthaben vor dem Senden der Antwort belastet. Benennen Sie Risiken doppelter Abbuchung, schlagen Sie minimale Änderungen und drei Abnahmetests vor. Nutzen Sie nur diese Fakten; setzen Sie keinen Zugriff auf Code, Werkzeuge oder Produktionssysteme voraus.
Was ist Claude Fable 5.1?
Mehrstufiges Programmieren und Recherchieren
Claude Fable 5.1 ist ein am 1. September 2026 von Anthropic veröffentlichtes Modell für anhaltende Analyse, mehrstufige Aufgaben und Zusammenarbeit mit Werkzeugen. Statt nur schnelle Antworten zu liefern, eignet es sich für komplexe Programmierprobleme und gründliche Forschung mit tieferem Nachdenken. Nativ unterstützt es Text- und Bildeingaben, Textausgaben, eine Million Kontext-Token und bis zu 128K Ausgabe-Token. Die native API verwendet standardmäßig high; der Denkaufwand lässt sich der Aufgabe anpassen.
Textchat vor der API-Integration testen
Mit API Hops Online-Tool testen Sie Fable 5.1 schnell: anmelden, API-Schlüssel erstellen und etwas Guthaben hinzufügen, ohne API-Integration oder Abonnement. Ein separates Anthropic-Konto ist nicht nötig; dies schützt jedoch nicht vor Kontobeschränkungen, und die geltenden Plattformbedingungen bleiben maßgeblich. Diese Seite bietet Textgespräche, keine Datei-Uploads, Websuche oder Codeausführung.
Wofür können Sie Claude Fable 5.1 einsetzen?
Fehlersuche und Codeprüfung
Anthropic nennt codebasisübergreifende Entwicklung, Codeprüfung und Leistungsarbeit als Kernanwendungen von Fable 5.1. Geben Sie Fehlertraces, Code, Umgebungsdetails und Reproduktionsschritte an; es kann Compilerfehler, Stacks und unbekannte Bibliotheksquellen lesen, Abhängigkeiten verfolgen und Lösungen vorschlagen. Ein Kunde schilderte einen seltenen Absturz, den sein Team jahrelang nicht vollständig gelöst hatte: Fable 5.1 disassemblierte eine externe Bibliothek, verglich Absturzabbilder, führte den Fehler auf einen Defekt dieser Bibliothek zurück und löste ihn schließlich.
Sie können auch Schnittstellenkompatibilität, Ausnahmewege, Berechtigungsprüfungen, Ressourcenfreigabe und Datenkonsistenz prüfen lassen. Behandeln Sie es als erfahrenen Assistenten, der Optionen vorschlägt; die Verantwortung für Entscheidungen bleibt bei den Entwicklern.
Recherche und Analyse
Recherche und Analyse sind weitere Kernanwendungen. Fable 5.1 kann über Zusammenfassungen hinaus Berechnungen zu einer Frage verfolgen, Ergebnisse beobachten und den Ansatz anpassen. Ein Kunde berichtete, dass eine Optimierungsaufgabe mit Fable 5 zusätzliche Hinweise benötigte, mit Fable 5.1 jedoch nicht mehr. Mit von der Anwendung bereitgestellten Such- oder Datenwerkzeugen kann es öffentliche Daten analysieren, Vorschläge entwerfen und bedarfsgerechte Bewertungen erstellen; diese Textseite selbst surft nicht im Web.
Öffentliche Daten können viel Rauschen enthalten. Wir empfehlen, anhand Ihres Geschäftsverständnisses vertrauenswürdige Quellen aufzubauen oder von unseren Entwicklungs- und Geschäftsteams ausgewählte API Hop-Daten-APIs zu verwenden.
Schreiben und Dokumententwürfe
Die wichtigsten Schreibverbesserungen von Fable 5.1 sind klarerer Ausdruck und bessere Einhaltung der Vorgaben, nicht bloß längere Artikel. Anthropics Schreibleitfaden empfiehlt die Rolle eines Assistenten statt eines Hauptautors; KI-Inhalte sollen weiterhin selbst geprüft und beurteilt werden.
Anthropic empfiehlt, Zielgruppe, zu klärende Informationen oder Probleme, zwingende Inhalte und zu vermeidende Formulierungen anzugeben. Konkrete Ziele, Struktur und Beispiele führen eher zu einem brauchbaren Entwurf als die bloße Bitte um einen professionellen Artikel.
Lange Dokumente und mehrteilige Gespräche
Im Vergleich von Artificial Analysis liegt Fable 5.1 beim Gesamtindex vor Kimi K3, erzielt bei AA-LCR v1.1 für langen Kontext aber 85% gegenüber 89% bei Kimi K3. Verglichen werden Fable 5.1 mit Max, Default Fallback und Kimi K3 mit Max. In diesem speziellen Langdokumenttest führt also Kimi K3; Fable 5.1 lässt sich damit nicht als stärkstes Langdokumentmodell bezeichnen.
Nach einer Kontextkomprimierung in langen Abläufen können wichtige Einschränkungen, getroffene Entscheidungen oder genaue Details verloren gehen, wie Anthropics Prompting-Leitfaden erläutert. Soweit Ihre Anwendung es ermöglicht, empfehlen wir, die wesentlichen Informationen in jedem Gespräch zu bewahren.
Claude Fable 5.1: Benchmarks für Programmieren, Denken und Tempo
Anthropics Einführungsbewertungen und unabhängige Tests von Artificial Analysis werden unten getrennt dargestellt. Die Einstellungen unterscheiden sich; keines sind API Hop-Messungen.
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
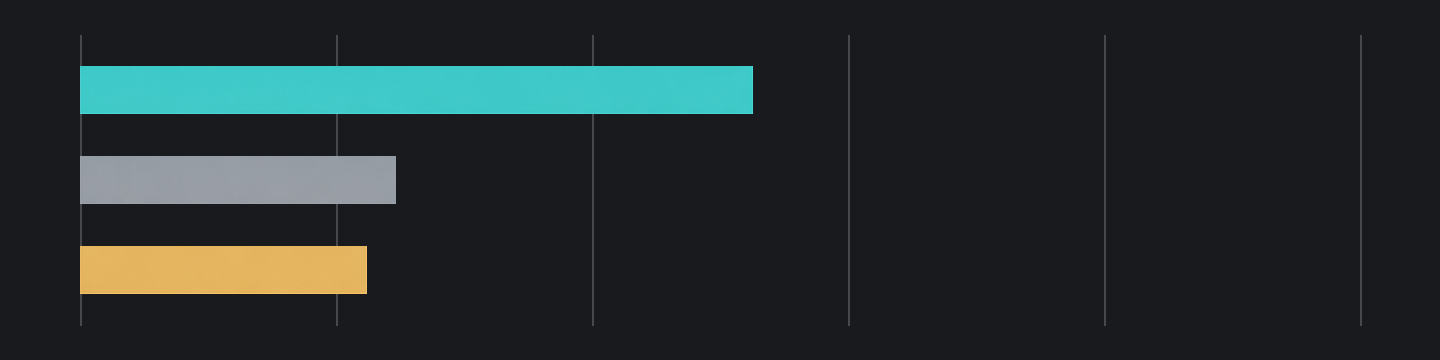
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
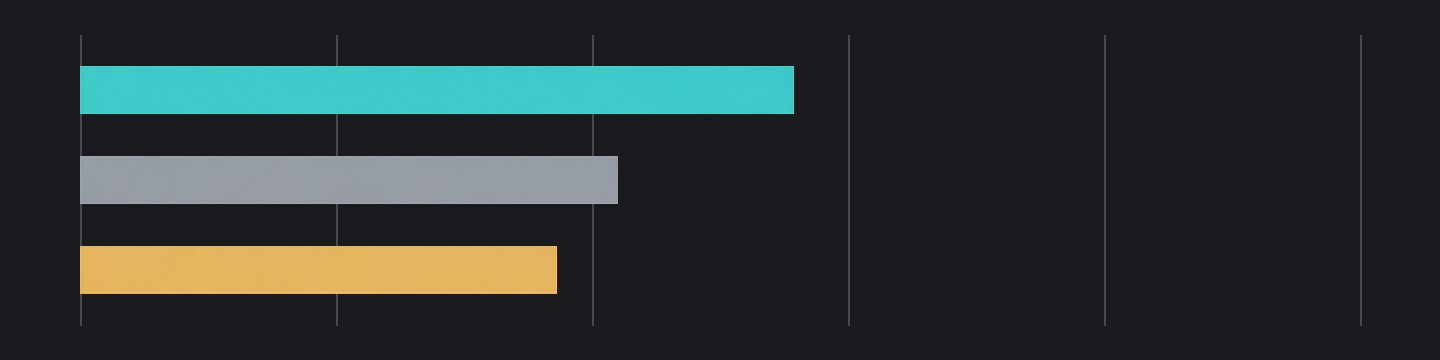
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
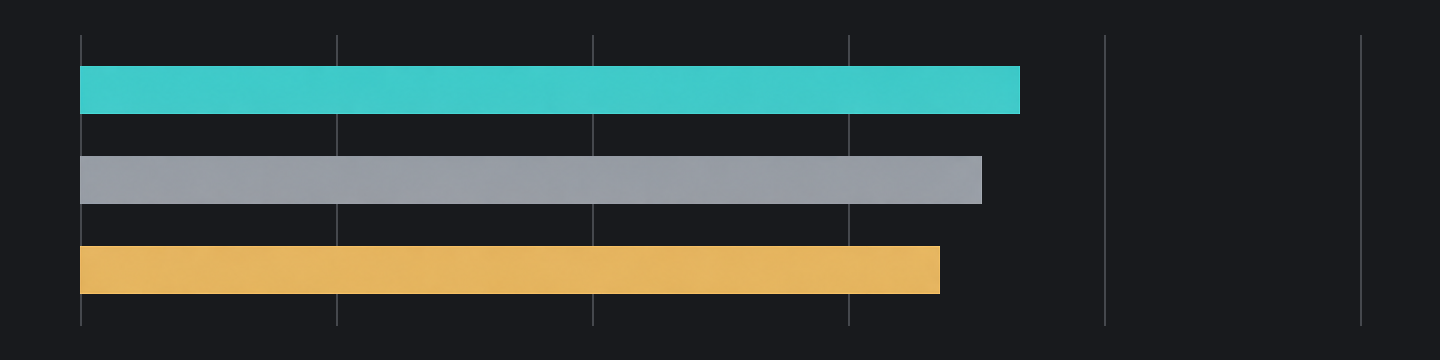
Fable 5.1: 60.9%Fable 5: 57.8%
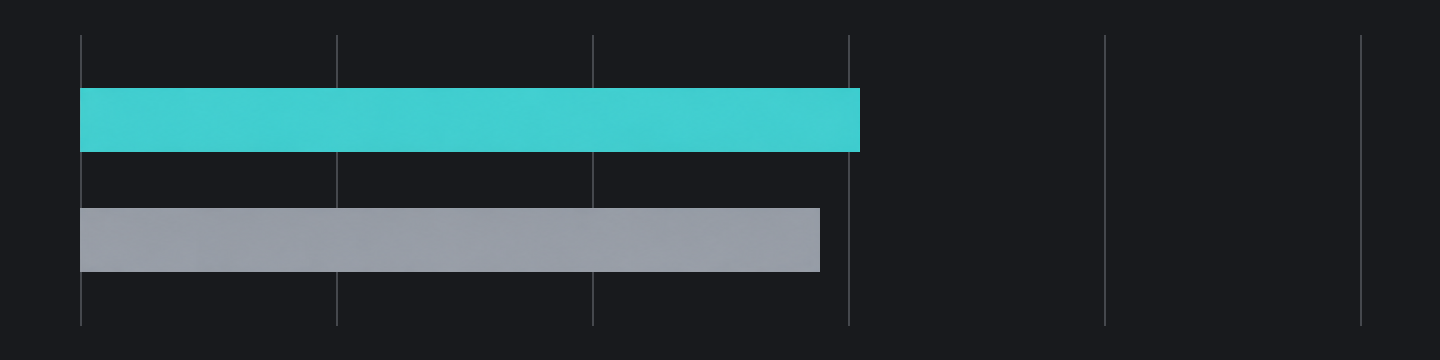
Fable 5.1: 65.0%Fable 5: 63.8%
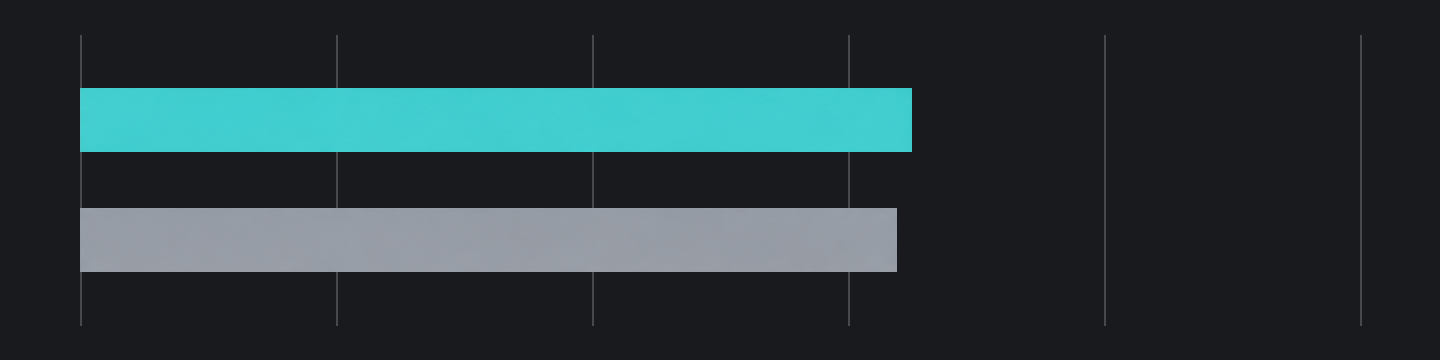
Programmieren: größter Sprung bei Terminalarbeit
Fable 5.1 verbessert sich am deutlichsten bei Terminalaufgaben, die eine Umgebung bedienen, Ausführungsergebnisse verarbeiten und die Arbeit fortsetzen müssen, nicht gleichmäßig bei allen Programmieraufgaben. Anthropic meldet gegenüber Fable 5 Zugewinne von 27.9 Prozentpunkten auf Terminal-Bench-Science 0.1, 13.8 auf Terminal-Bench 4.0 und 2.9 auf CursorBench 3.2.0. Das spricht eher für stärkere Ausführung komplexer Aufgaben als für einen einheitlichen Sprung in der Codegenerierung.
Der Wert liegt darin, Analyse und praktisches Handeln zu verbinden. Anthropic beschreibt Entwicklung über Codebasen hinweg, eigenständiges Testschreiben und visuelle Prüfung der Zielerreichung. Wir interpretieren dies als bessere Fähigkeit, Lösungen zu verstehen, zu ändern, zu prüfen und zu verfeinern, statt bei einem plausiblen Vorschlag stehenzubleiben.
Schlussfolgern: kleinere, einstellungsabhängige Gewinne
Das Schlussfolgern wurde verbessert, manche Tests zeigen aber geringere Gewinne als Terminalaufgaben. Auf Humanity's Last Exam steigt der Wert ohne Werkzeuge von Fable 5 mit 57.8% auf 60.9%, mit Werkzeugen von 63.8% auf 65.0%: Zugewinne von 3.1 beziehungsweise 1.2 Prozentpunkten.
Wir betrachten Aufwand nicht als einfachen Schalter nach dem Motto „höher ist immer klüger“. Anthropic beschreibt ihn als zentrale Steuerung für Fähigkeit, Latenz und Kosten und weist darauf hin, dass gleiche Aufwandsetiketten verschiedener Modelle nicht dieselbe Denkmenge bedeuten.
Die Community liefert ein hilfreiches Gegenbeispiel. Hacker-News-Nutzer seaurchinzee liest die Systemkarte so, dass höchster Aufwand auf FrontierCode Extended nicht am besten abschneidet und höhere Einstellungen mehr unerbetene Änderungen verursachen können. Das betrifft eine bestimmte Programmierbewertung, nicht HLE, zeigt aber, dass mehr Denken nicht immer bessere Auftragstreue bedeutet. Neben Richtigkeit zählt der Umfang; Anthropics Prompting-Leitfaden behandelt zusätzliche Änderungen und Ausweitungen gesondert.
Unabhängiger Index und Durchsatz: zwei getrennte Fragen
Wir halten Gesamtfähigkeit und Antwortgeschwindigkeit von Fable 5.1 für getrennt zu bewerten statt auf einen Wert zu reduzieren. Bei der Prüfung am 4. Oktober 2026 verzeichnet Artificial Analysis für Max, Default Fallback einen Intelligenzindex von 53, etwa 66.2 Ausgabe-Token pro Sekunde und etwa 259.12 Sekunden bis zum ersten Token.
Bei derselben SVG-Zeichenaufgabe benötigte high etwa 29.6 Sekunden, max etwa 13 Minuten 54 Sekunden. Wir bewerten das Ergebnis mit höchstem Aufwand besser, doch Wartezeit und Ausgabeverbrauch stiegen deutlich. Unser Fazit: Zusätzliches Denken kann manche komplexen Ergebnisse verbessern.
Claude Fable 5.1 im Vergleich mit Fable 5, GPT-5.6 Sol und Kimi K3
Der direkteste Beleg für Fable 5.1 bleibt sein Vorsprung bei Terminalaufgaben. Die folgende Tabelle stammt aus Anthropics Einführungsbewertung.
Fable 5.1: 53Kimi K3: 44
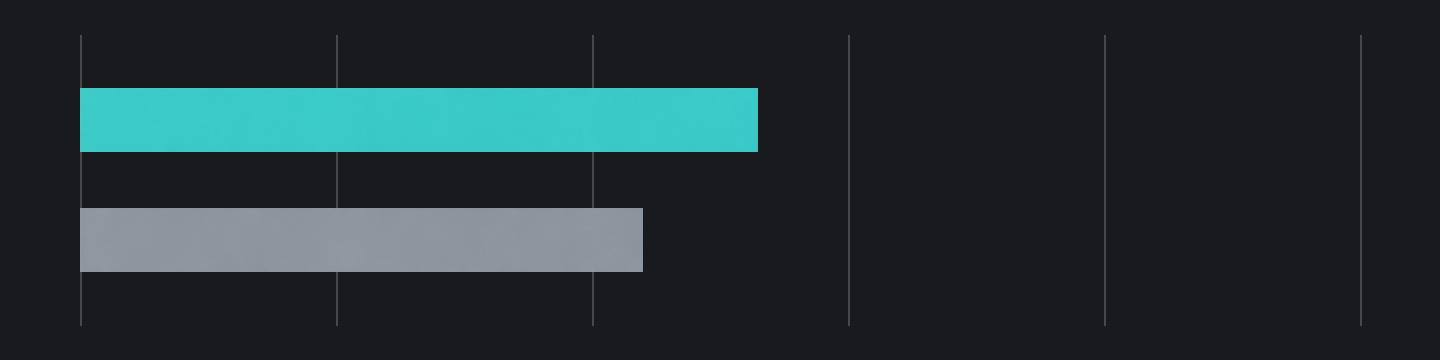
Fable 5.1: 52%Kimi K3: 13%
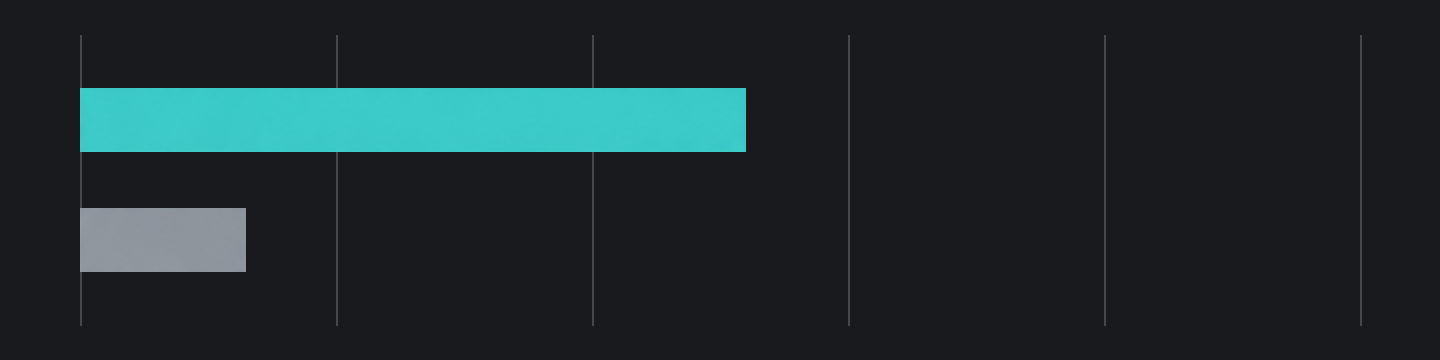
Fable 5.1: 85%Kimi K3: 89%
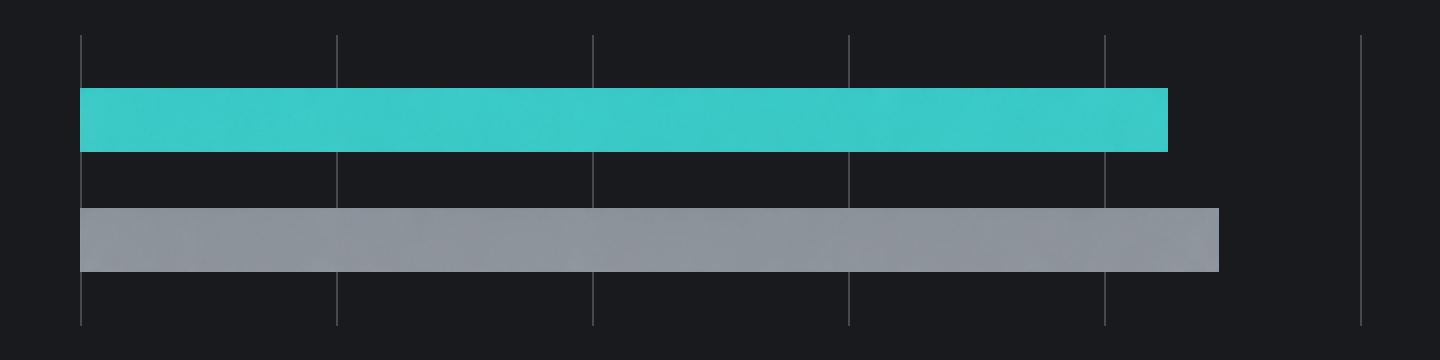
| Vergleichstest | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Gegenüber Fable 5 und GPT-5.6 Sol: klarster Vorsprung beim Terminal-Programmieren
Die Werte zeigen auf den beiden Terminal-Benchmarks einen größeren Vorsprung von Fable 5.1 gegenüber GPT-5.6 Sol als auf CursorBench. Ein Kunde berichtete, dass Fable 5.1 in seinen Tests Fable 5 erreichte oder leicht übertraf und zugleich die Kosten pro Aufgabe senkte; deshalb begann er, das Modell für Codeprüfungen einzusetzen.
Gegenüber Kimi K3: Langdokumentdenken kehrt die Rangfolge um
Unsere Einschätzung: Fable 5.1 ist in diesem Vergleich insgesamt stärker. Artificial Analysis nennt einen Index von 53 für Fable 5.1 und 44 für Kimi K3 sowie Terminal-Bench-4.0-Werte von 52% und 13%. Auf AA-LCR v1.1 für langen Kontext kehrt sich die Reihenfolge um: Fable 5.1 erzielt 85%, Kimi K3 89%.
Manche Nutzer bevorzugen die Erklärungen von Kimi K3 und wechseln für Codeprüfung oder Problemverständnis dorthin. Unser aktuelles Fazit: Fable 5.1 führt bei der Gesamtfähigkeit, Kimi K3 in diesem speziellen Langdokumenttest.
Warum Claude Fable 5.1 über API Hop nutzen?
Nutzungsbasierte Abrechnung und Optimierung der Modellkosten
Die Abrechnung folgt den aktuellen API Hop-Tarifen und der tatsächlichen Nutzung. Laden Sie Ihr Guthaben bei Bedarf auf.
KI-Modelle und Daten-APIs mit zentralem Zugriff auf mehrere Modelle
Ein API-Schlüssel verbindet mehrere KI-Modelle und Datendienste, senkt Integrationskosten und ermöglicht den Wechsel mit einem Klick. Geschäftsanwendungen benötigen sowohl KI als auch Daten.
Aufrufprotokolle und Zugriffskontrollen für transparente Anfragen
Jeder API-Aufruf wird in Ihrem Dashboard protokolliert. Erstellen Sie getrennte API-Schlüssel für verschiedene Anwendungen.
Ausgaben anhand Ihrer Aufgabe bewerten
Verwenden Sie über API Hop die dokumentierte Modell-ID und unterstützten Parameter. Bewerten Sie Ausgaben anhand Ihrer Abnahmekriterien und prüfen Sie vor dem Produktionseinsatz Nutzungsprotokolle und Antwortmetadaten. Ein Modellname oder Beispiel garantiert nicht jedes Ergebnis.
So nutzen Sie Claude Fable 5.1 auf API Hop
Erstellen Sie einen API-Schlüssel in der Konsole und folgen Sie der Dokumentation, um Claude Fable 5.1 zu nutzen.
Konto vorbereiten und online testen
Melden Sie sich an, prüfen Sie Ihr Guthaben und erstellen Sie einen API-Schlüssel.
In der Testumgebung ausprobieren
Erkunden Sie die Fähigkeiten des Modells in der Testumgebung, um die beste Nutzung zu finden.
Claude Fable 5.1 in Ihr Unternehmen integrieren
Folgen Sie unserer Entwicklerdokumentation, um Claude Fable 5.1 in Ihr Unternehmen zu integrieren.
Künftige Modell-Upgrades
Prüfen Sie vor dem Wechsel auf ein neueres Modell, ob der Modellkatalog Ihres API-Schlüssels dessen exakte ID zurückgibt. Unterstützt es denselben Endpunkt und dieselben Anfragefelder, aktualisieren Sie die Modell-ID und testen Antwortformate, Streaming, Ausgabelimits und Abrechnung vor dem Produktionseinsatz. Prüfen Sie bei asynchronen Bild- oder Videoaufgaben auch Auftragserstellung, Statusabfrage und Ergebnisabruf.
Häufige Fragen zur Claude Fable 5.1-API
Ist Claude Fable 5.1 dasselbe API-Modell wie Fable 5?
Nein. Claude Fable 5.1 (API-Modellname: claude-fable-5-1) ist eine verbesserte Version von Claude Fable 5 (API-Modellname: claude-fable-5). Verwenden Sie beim API-Aufruf den richtigen model-Parameter.
Warum ist thinking leer oder die Antwort unvollständig?
Natives Fable 5.1 verwendet standardmäßig adaptives Denken und kann den Denkinhalt auslassen. Gewöhnliche Anfragen benötigen keinen thinking-Parameter; leeres thinking allein ist kein Fehler. Bei einer unvollständigen Antwort prüfen Sie Abschlussstatus und Ausgabebudget und lassen ausreichend Platz für Denken und endgültigen Text.
Wie untersuche ich Fehler bei Authentifizierung, Guthaben oder Zugriff?
Folgen Sie zur Diagnose der API-Fehlerdokumentation.
Kann ich OpenAI Responses für Claude Fable 5.1 verwenden?
OpenAI Responses wird nicht unterstützt. Claude hat sein eigenes Claude-Messages-Format; Einzelheiten stehen in der Dokumentation.
Kann ich einen Tool-Aufruf erzwingen oder eine native Messages-Unterhaltung bearbeiten?
Natives Fable 5.1 unterstützt die erzwungenen tool_choice-Typen any und tool nicht. Seien Sie vorsichtig, wenn Sie nach Änderungen früherer Nachrichten gespeichertes Denken erneut senden. Bewahren Sie native assistant-Inhaltsblöcke und ihre Signaturen bei Tool-Fortsetzungen unverändert auf.
Ist das Gesprächsgedächtnis dauerhaft?
Nein. Die API speichert Gesprächskontext nicht automatisch für folgende Anfragen. Verwalten Sie den Verlauf selbst und übergeben Sie den benötigten Kontext bei jeder Anfrage. Langzeitgedächtnis muss Ihre Anwendung implementieren.
Verwandte Text-APIs
API-Beispiele und unterstützte Parameter für Claude Fable 5.1
Schnellstart zur Claude Fable 5.1-API
claude-fable-5-1model ist erforderlich; die Beispiele verwenden die Modell-ID dieser Seite. Prüfen Sie den Modellzugriff Ihres API-Schlüssels mit GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages erfordert max_tokens. Das Beispielbudget ist anpassbar und weder ein Standardwert des Anbieters noch ein Modelllimit. Denken kann es vor der Textantwort verbrauchen; passen Sie es an Ihre Aufgabe an und prüfen Sie die Ausgabekosten.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Familien- und Protokollreferenz
Claude Messages
Vollständige API-DokumentationNative Claude-Messages-kompatible API. Dieser Endpunkt verwendet Anfrage- und Antwortstrukturen von Anthropic Messages, einschließlich Werkzeugaufrufen und Anthropic-SSE-Ereignissen.
POST
https://api.apihop.ai/anthropic/v1/messages