Trích xuất các bản ghi giả lập này thành JSON với trường id, owner, deadline và evidence: [R1] Vấn đề 41: Ana phụ trách sửa xuất dữ liệu; chưa thống nhất hạn chót. [R2] Vấn đề 42: hạn rà soát ngày 15 tháng Mười; chưa giao người phụ trách; không nêu năm. Dùng null cho giá trị thiếu và giữ ngày không đầy đủ như đã cho. Trích nguồn trong evidence. Không bịa năm hoặc người phụ trách. Đối chiếu từng trường với bản ghi; đây là tác vụ định dạng văn bản, không phải thao tác cơ sở dữ liệu.
API Claude Fable 5.1 cho lập trình và nghiên cứu
So sánh giá API Claude Fable 5.1 và lựa chọn tích hợp cho lập trình, nghiên cứu nhiều bước. Xem hướng dẫn suy luận và thử prompt văn bản trực tuyến.
Giá và tính phí API Claude Fable 5.1
Giá chính thức
- Đầu vào
- $10.0000 /M
- Đầu ra
- $50.0000 /M
- Đầu vào bộ nhớ đệm
- $0.2500 /M
- Ghi bộ nhớ đệm (5 phút)
- $12.5000 /M
- Ghi bộ nhớ đệm (1 giờ)
- $20.0000 /M
Giá API Hop Tiết kiệm 45%
- Đầu vào
- $5.5000 /M
- Đầu ra
- $27.5000 /M
- Đầu vào bộ nhớ đệm
- $0.1375 /M
- Ghi bộ nhớ đệm (5 phút)
- $6.8750 /M
- Ghi bộ nhớ đệm (1 giờ)
- $11.0000 /M
Giá tham chiếu chưa được xác minh độc lập. Kiểm tra mức giá hiện tại, đơn vị tính phí và điều khoản áp dụng của nhà phát hành trước khi so sánh chi phí.
Công cụ trò chuyện trực tuyến Claude Fable 5.1
Cài đặt mô hình
Bộ nhớ có tác dụng gì?
Bộ nhớ đưa các lượt hội thoại đã hoàn tất và có thể dùng lại vào yêu cầu tiếp theo, giúp bạn hỏi tiếp mà không cần nhắc lại ngữ cảnh.
Điều gì xảy ra khi tắt?Chỉ tin nhắn mới và prompt hệ thống nếu có được gửi. Tin nhắn hiện có vẫn hiển thị; bật lại bộ nhớ sẽ đưa các lượt trước đủ điều kiện vào yêu cầu.
Đây có phải bộ nhớ dài hạn không?Không. Đây là ngữ cảnh hội thoại, không phải bộ nhớ giữa các hội thoại riêng biệt. Phản hồi thất bại, bị dừng, cắt ngắn hoặc không thể dùng lại được loại trừ. Lịch sử dài hơn có thể dùng thêm token đầu vào và tăng chi phí.
Tham số nâng cao
0 ký tự trở lên(0/Không có giới hạn cố định)
Không có giới hạn ký tự cố định; toàn bộ yêu cầu chịu giới hạn kích thước yêu cầu và ngữ cảnh mô hình. Đây không phải số token. Hội thoại

Hôm nay tôi có thể giúp gì cho bạn?
Chưa có dữ liệu phản hồi Sẵn sàng
Ví dụ prompt Claude Fable 5.1
Đây là prompt đánh giá cho Claude Fable 5.1, không phải đầu ra mô hình đã ghi nhận. Chúng chỉ phân tích văn bản được cung cấp, không thực thi mã, kiểm tra hệ thống sản xuất hay chứng minh hiệu năng ngữ cảnh dài. Kiểm tra bằng chứng trích dẫn và tiêu chí chấp nhận, rồi xem siêu dữ liệu phản hồi cùng mức sử dụng trước khi dùng trong sản xuất.
Chỉ dùng mẫu tài liệu này: [P1] Bản sửa xuất dữ liệu đã qua kiểm tra staging. [P2] Phát hành thứ Sáu được đề xuất, chưa phê duyệt. [P3] Mei sẽ rà soát thông báo lỗi vào thứ Ba. [P4] Chưa giao người phụ trách tài liệu. Trả bảng gồm nhận định, trích dẫn hỗ trợ chính xác, ID đoạn và sự không chắc chắn. Đã phê duyệt phát hành sản xuất chưa? Ai phụ trách tài liệu? Đánh dấu dữ kiện thiếu là chưa biết. Mọi trích dẫn phải khớp mẫu được cung cấp; không suy ra thành công sản xuất từ staging. Mẫu nhỏ này không kiểm thử độ dài ngữ cảnh tối đa.
Rà soát chính sách webhook thanh toán giả định này: mỗi POST thất bại được thử lại ba lần, không lưu khóa idempotency và số dư bị trừ trước khi gửi phản hồi. Xác định rủi ro tính phí trùng, đề xuất thay đổi tối thiểu và ba kiểm thử chấp nhận. Chỉ dùng các dữ kiện này; không giả định có quyền truy cập mã, công cụ hay hệ thống sản xuất.
Claude Fable 5.1 là gì?
Lập trình và nghiên cứu nhiều bước
Claude Fable 5.1 là mô hình được Anthropic phát hành ngày 1 tháng Chín năm 2026, tập trung vào phân tích liên tục, tác vụ nhiều bước và phối hợp với công cụ. Thay vì chỉ đưa ra câu trả lời nhanh, mô hình phù hợp với vấn đề lập trình phức tạp và nghiên cứu chuyên sâu cần suy nghĩ kỹ hơn. Đặc tả gốc hỗ trợ đầu vào văn bản và hình ảnh, đầu ra văn bản, cửa sổ ngữ cảnh một triệu token và tối đa 128K token đầu ra. API gốc mặc định mức nỗ lực high, có thể điều chỉnh nỗ lực suy luận theo tác vụ.
Thử trò chuyện văn bản trước khi tích hợp API
Công cụ trực tuyến của API Hop cho phép thử Fable 5.1 nhanh chóng: đăng nhập, tạo khóa API và nạp một khoản tín dụng nhỏ để bắt đầu đánh giá mô hình mà không cần tích hợp API hay mua gói đăng ký. Bạn không cần mở tài khoản Anthropic riêng, nhưng điều này không bảo đảm tránh được hạn chế tài khoản; các điều khoản nền tảng liên quan vẫn áp dụng. Trang này hỗ trợ hội thoại văn bản, không hỗ trợ tải tệp lên, duyệt web hay thực thi mã.
Bạn có thể dùng Claude Fable 5.1 để làm gì?
Gỡ lỗi và rà soát mã
Anthropic liệt kê phát triển xuyên cơ sở mã, rà soát mã và tối ưu hiệu năng trong các trường hợp sử dụng cốt lõi của Fable 5.1. Cung cấp vết lỗi, mã liên quan, chi tiết môi trường và bước tái hiện, mô hình có thể đọc lỗi trình biên dịch, ngăn xếp và mã nguồn thư viện chưa quen để theo dõi phụ thuộc và đề xuất giải pháp. Một khách hàng mô tả sự cố hiếm mà nhóm chưa giải quyết triệt để trong nhiều năm: Fable 5.1 dịch ngược một thư viện bên ngoài, so sánh bản kết xuất sự cố và truy nguyên vấn đề đến lỗi trong thư viện đó, cuối cùng giải quyết được.
Bạn cũng có thể yêu cầu kiểm tra tính tương thích giao diện, luồng ngoại lệ, kiểm tra quyền, giải phóng tài nguyên và tính nhất quán dữ liệu. Hãy coi mô hình là trợ lý có kinh nghiệm đề xuất phương án, còn lập trình viên vẫn chịu trách nhiệm quyết định.
Nghiên cứu và phân tích
Nghiên cứu và phân tích là trường hợp sử dụng cốt lõi khác. Ngoài tóm tắt tài liệu, Fable 5.1 có thể tiếp tục tính toán quanh một câu hỏi, quan sát kết quả và điều chỉnh cách tiếp cận. Một khách hàng báo cáo tác vụ tối ưu cần nhắc thêm với Fable 5 nhưng không còn cần hướng dẫn tương tự với Fable 5.1. Với công cụ tìm kiếm hoặc dữ liệu do ứng dụng cung cấp, mô hình có thể phân tích dữ liệu công khai, soạn đề xuất và đưa ra đánh giá theo nhu cầu; bản thân trang văn bản này không duyệt web.
Dữ liệu công khai có thể chứa nhiều nhiễu. Chúng tôi đề nghị xây dựng nguồn đáng tin cậy dựa trên hiểu biết của bạn về hoạt động kinh doanh, hoặc dùng API dữ liệu API Hop do nhóm kỹ thuật và kinh doanh của chúng tôi lựa chọn.
Viết và soạn thảo tài liệu
Cải tiến viết chính của Fable 5.1 là diễn đạt rõ hơn và tuân thủ yêu cầu viết tốt hơn, thay vì chỉ tạo bài dài hơn. Hướng dẫn viết của Anthropic khuyên giữ mô hình ở vai trò trợ lý thay vì coi là tác giả nội dung chính, đồng thời tiếp tục tự rà soát và đánh giá nội dung do AI tạo.
Anthropic khuyên xác định đối tượng đọc, thông tin hoặc vấn đề người đọc cần được giải quyết, thông tin bắt buộc có và cách diễn đạt cần tránh. Mục tiêu, cấu trúc và ví dụ cụ thể có khả năng tạo bản thảo hữu ích hơn việc chỉ yêu cầu một bài viết chuyên nghiệp.
Tài liệu dài và thảo luận nhiều lượt
Trong so sánh của Artificial Analysis, Fable 5.1 có chỉ số tổng hợp cao hơn Kimi K3, nhưng đạt 85% so với 89% của Kimi K3 ở suy luận ngữ cảnh dài AA-LCR v1.1. Cấu hình là Fable 5.1 ở Max với Default Fallback và Kimi K3 ở Max. Vì vậy Kimi K3 dẫn đầu bài kiểm tra suy luận tài liệu dài cụ thể này; kết quả không ủng hộ việc gọi Fable 5.1 là mô hình tài liệu dài mạnh nhất.
Sau khi nén ngữ cảnh trong quy trình dài, ràng buộc quan trọng, quyết định đã đưa ra hoặc chi tiết chính xác có thể bị mất, như hướng dẫn viết câu lệnh của Anthropic đề cập. Nếu có thể triển khai trong ứng dụng, chúng tôi đề nghị giữ thông tin thiết yếu trong mọi hội thoại.
Đo chuẩn Claude Fable 5.1: lập trình, suy luận và tốc độ
Đánh giá khi ra mắt của Anthropic và đánh giá độc lập của Artificial Analysis được trình bày riêng bên dưới. Thiết lập của chúng khác nhau và không bên nào là phép đo của API Hop.
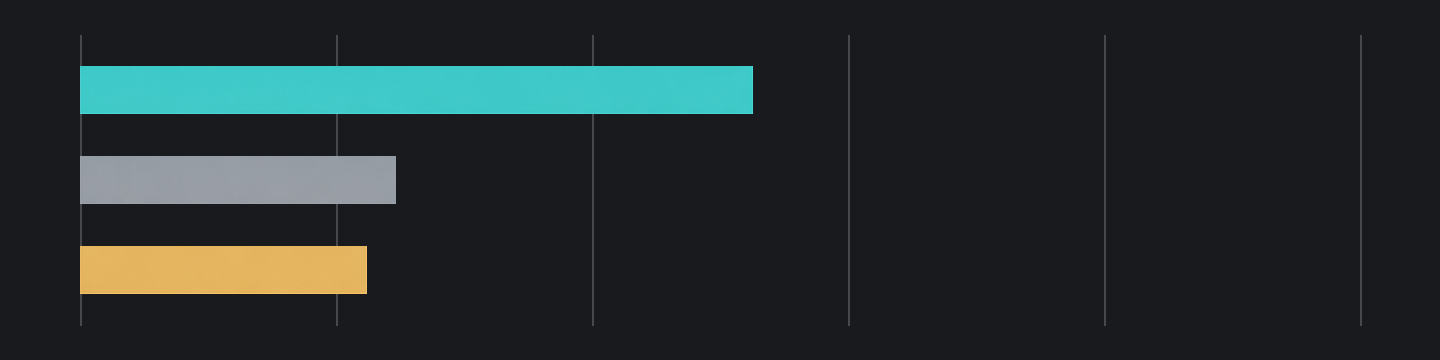
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
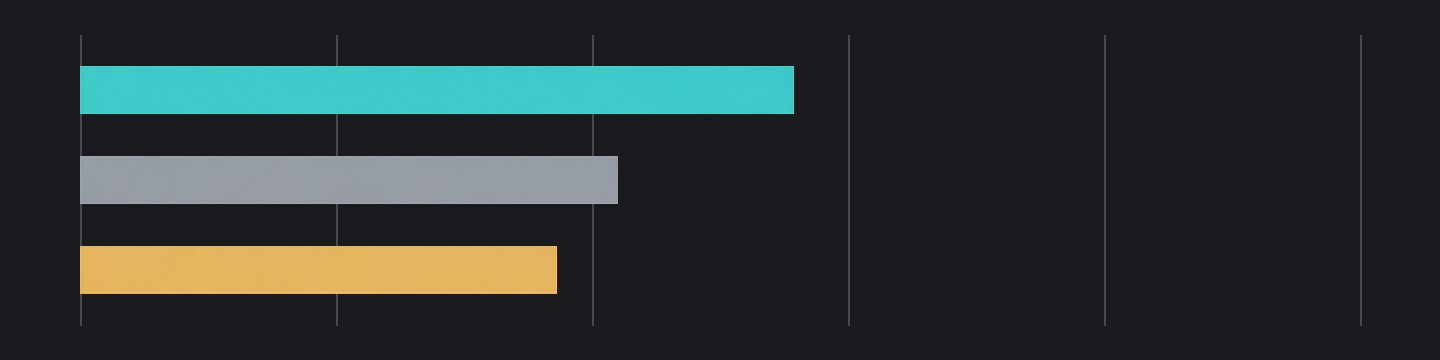
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
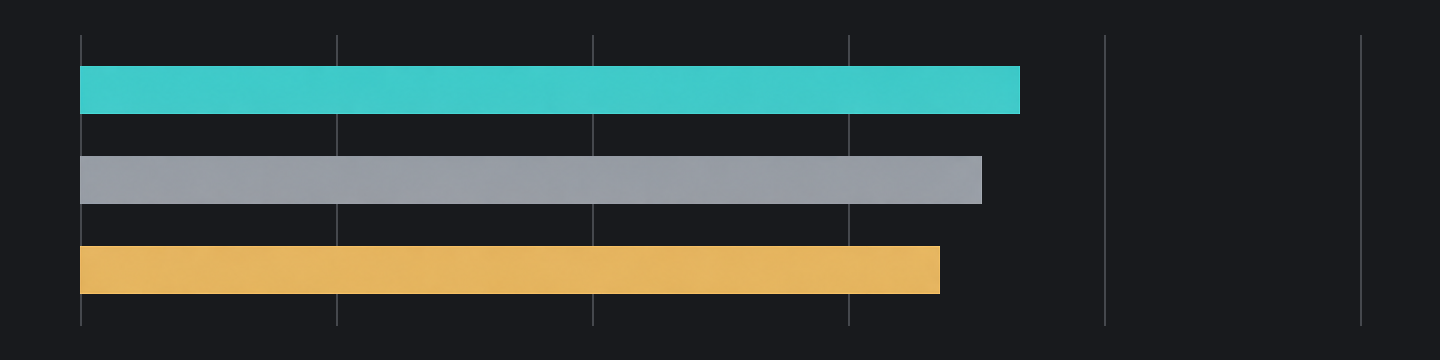
Fable 5.1: 60.9%Fable 5: 57.8%
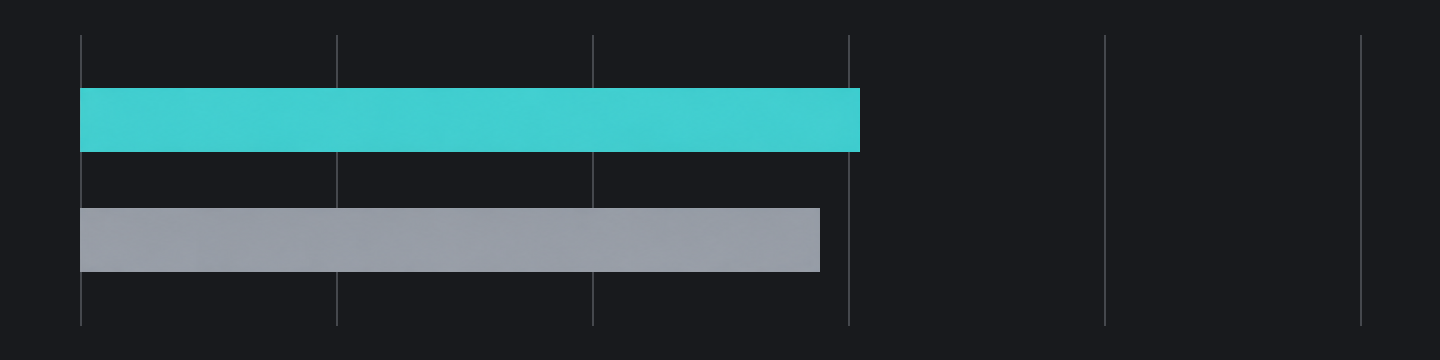
Fable 5.1: 65.0%Fable 5: 63.8%
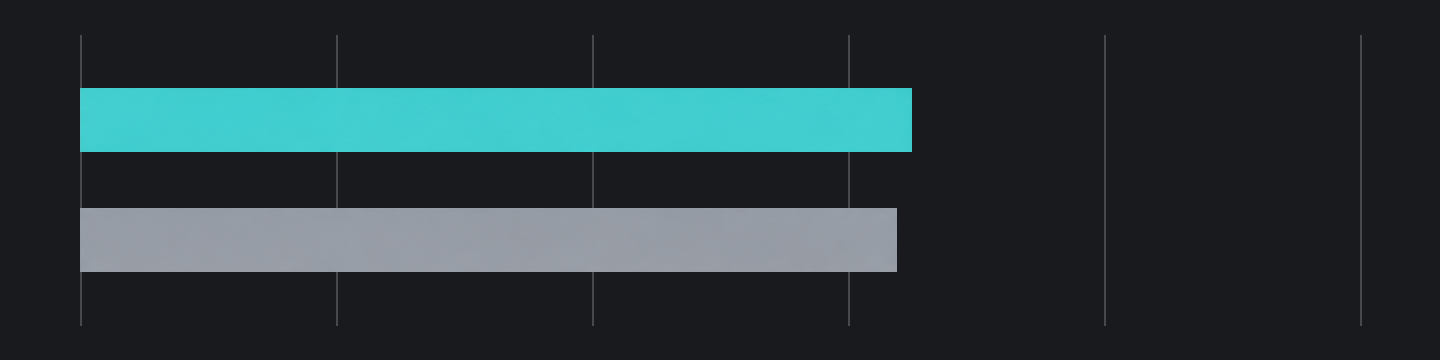
Lập trình: bước tiến lớn nhất ở công việc thiết bị đầu cuối
Cải tiến lập trình rõ nhất của Fable 5.1 nằm ở tác vụ thiết bị đầu cuối cần vận hành môi trường, xử lý kết quả thực thi và tiếp tục công việc, thay vì cải tiến đồng đều ở mọi tác vụ lập trình. Anthropic báo cáo mức tăng so với Fable 5 là 27.9 điểm phần trăm ở Terminal-Bench-Science 0.1, 13.8 điểm ở Terminal-Bench 4.0 và 2.9 điểm ở CursorBench 3.2.0. Khác biệt này gợi ý khả năng thực hiện tác vụ phức tạp mạnh hơn thay vì bước nhảy đồng đều về chất lượng tạo mã.
Giá trị nằm ở việc kết nối phân tích với hành động thực tế. Anthropic mô tả phát triển xuyên cơ sở mã, tự viết kiểm thử và dùng kết quả trực quan để kiểm tra triển khai có đạt mục tiêu hay không. Theo diễn giải của chúng tôi, mô hình có điều kiện tốt hơn để hiểu, sửa, xác minh và hoàn thiện giải pháp thay vì dừng ở đề xuất có vẻ hợp lý.
Suy luận: mức tăng nhỏ hơn và phụ thuộc thiết lập
Suy luận đã cải thiện, nhưng một số kiểm tra công bố cho mức tăng nhỏ hơn tác vụ thiết bị đầu cuối. Ở Humanity's Last Exam, điểm không dùng công cụ tăng từ 57.8% của Fable 5 lên 60.9%, còn điểm có công cụ từ 63.8% lên 65.0%: tăng 3.1 và 1.2 điểm phần trăm.
Chúng tôi không coi mức nỗ lực là công tắc đơn giản mà cao hơn luôn thông minh hơn. Hướng dẫn Anthropic xác định đây là điều khiển chính đối với năng lực, độ trễ và chi phí, đồng thời lưu ý nhãn nỗ lực giống nhau giữa các mô hình không đại diện lượng suy nghĩ giống nhau.
Thảo luận cộng đồng đưa ra phản ví dụ hữu ích. Người dùng Hacker News seaurchinzee diễn giải thẻ hệ thống là mức nỗ lực cao nhất không đạt tốt nhất ở FrontierCode Extended, và thiết lập cao hơn có thể tăng thay đổi không được yêu cầu. Điều này liên quan một đánh giá lập trình cụ thể, không phải HLE, nhưng nhấn mạnh suy luận nhiều hơn không luôn tuân thủ tác vụ tốt hơn. Phạm vi quan trọng cùng tính đúng đắn, và hướng dẫn viết câu lệnh của Anthropic cũng đề cập riêng thay đổi bổ sung và mở rộng phạm vi.
Chỉ số độc lập và thông lượng: hai câu hỏi riêng
Chúng tôi cho rằng năng lực tổng thể và tốc độ phản hồi của Fable 5.1 nên được đánh giá riêng thay vì gộp thành một điểm. Theo kiểm tra ngày 4 tháng Mười năm 2026, Artificial Analysis ghi nhận Intelligence Index 53 cho cấu hình Max, Default Fallback, khoảng 66.2 token đầu ra mỗi giây và khoảng 259.12 giây đến token đầu tiên.
Trên cùng tác vụ vẽ SVG, high mất khoảng 29.6 giây và max khoảng 13 phút 54 giây. Chúng tôi đánh giá kết quả ở mức nỗ lực cao nhất tốt hơn, nhưng thời gian chờ và mức sử dụng đầu ra cũng tăng đáng kể. Kết luận của chúng tôi là suy luận thêm có thể cải thiện một số đầu ra phức tạp.
Claude Fable 5.1 so với Fable 5, GPT-5.6 Sol và Kimi K3
Bằng chứng trực tiếp nhất ủng hộ Fable 5.1 vẫn là lợi thế ở tác vụ thiết bị đầu cuối. Bảng sau là đánh giá khi ra mắt của Anthropic.
Fable 5.1: 53Kimi K3: 44
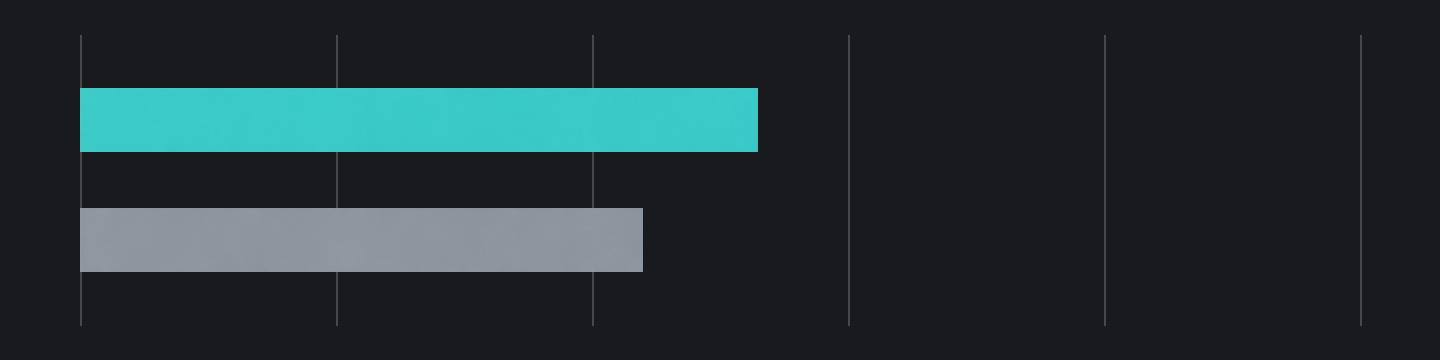
Fable 5.1: 52%Kimi K3: 13%
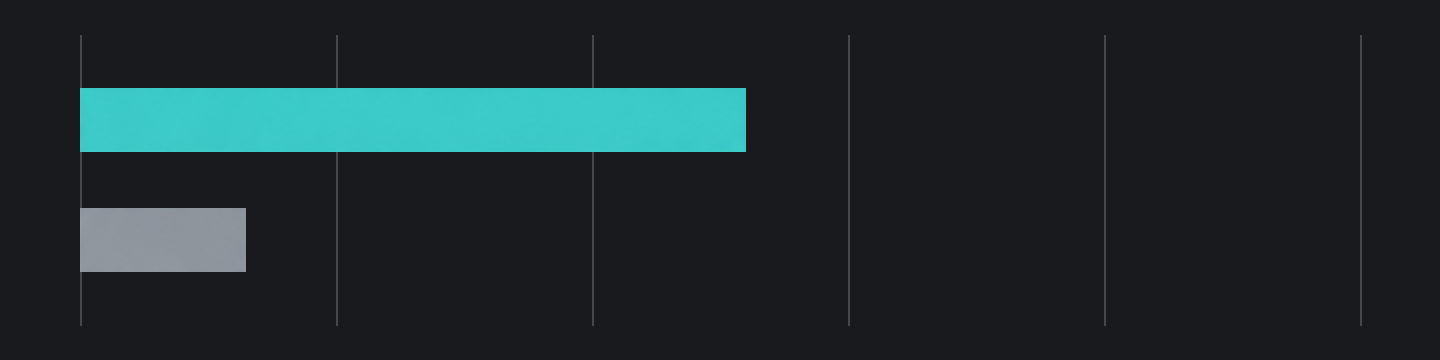
Fable 5.1: 85%Kimi K3: 89%
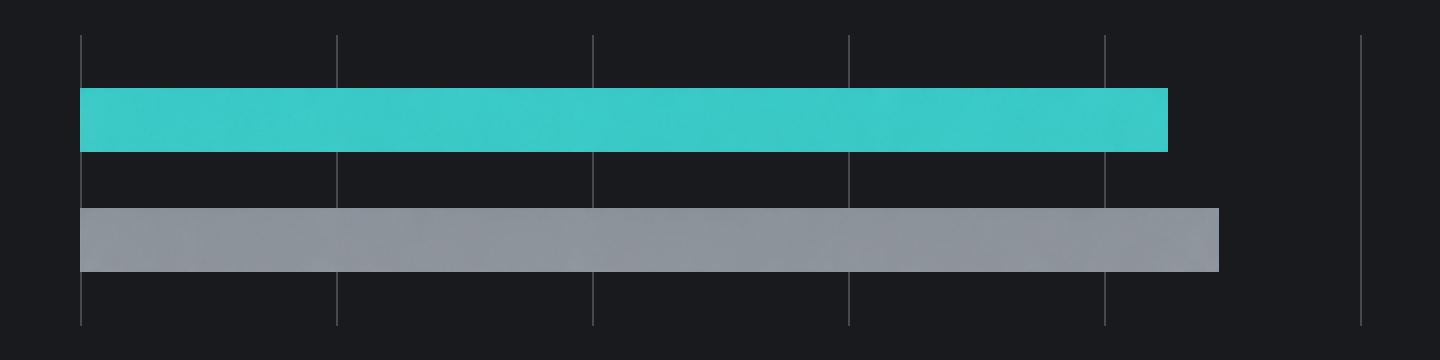
| Bài đo chuẩn | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
So với Fable 5 và GPT-5.6 Sol: lợi thế rõ nhất là lập trình trong thiết bị đầu cuối
Các điểm số này cho thấy lợi thế của Fable 5.1 trước GPT-5.6 Sol ở hai bài đo chuẩn thiết bị đầu cuối lớn hơn ở CursorBench. Một khách hàng báo cáo Fable 5.1 ngang hoặc nhỉnh hơn Fable 5 trong kiểm tra của họ đồng thời giảm chi phí mỗi tác vụ, khiến họ bắt đầu dùng mô hình để rà soát mã.
So với Kimi K3: suy luận tài liệu dài đảo ngược thứ hạng
Chúng tôi đánh giá Fable 5.1 mạnh hơn ở đánh giá tổng hợp trong so sánh này. Artificial Analysis ghi nhận chỉ số 53 cho Fable 5.1 và 44 cho Kimi K3, với điểm Terminal-Bench 4.0 lần lượt là 52% và 13%. Ở suy luận ngữ cảnh dài AA-LCR v1.1, thứ hạng đảo ngược: Fable 5.1 đạt 85% còn Kimi K3 đạt 89%.
Một số người dùng có thể thích lời giải thích của Kimi K3 hơn và chuyển sang mô hình đó để rà soát mã hoặc hiểu vấn đề. Kết luận hiện tại của chúng tôi là Fable 5.1 dẫn đầu năng lực tổng hợp, còn Kimi K3 dẫn đầu bài kiểm tra tài liệu dài cụ thể này.
Vì sao dùng Claude Fable 5.1 qua API Hop?
Tính phí theo mức sử dụng và tối ưu chi phí mô hình
Phí theo giá API Hop hiện tại và mức sử dụng thực tế. Nạp tiền theo nhu cầu.
Mô hình AI và API dữ liệu thống nhất, truy cập nhiều mô hình ở cùng một nơi
Một khóa API kết nối nhiều mô hình AI và dịch vụ dữ liệu, giảm chi phí tích hợp và cho phép chuyển bằng một lần nhấp. Ứng dụng kinh doanh cần cả AI lẫn dữ liệu.
Nhật ký lệnh gọi và kiểm soát truy cập ứng dụng, minh bạch từng lệnh gọi
Mỗi lệnh gọi API được ghi trong bảng điều khiển. Tạo khóa API riêng cho các ứng dụng khác nhau.
Đánh giá đầu ra theo tác vụ
Dùng ID mô hình trong tài liệu và tham số được hỗ trợ qua API Hop. Đánh giá đầu ra theo tiêu chí chấp nhận của bạn, rồi kiểm tra bản ghi sử dụng và siêu dữ liệu phản hồi trước khi dùng trong sản xuất. Tên mô hình hoặc ví dụ không đảm bảo từng kết quả.
Cách dùng Claude Fable 5.1 trên API Hop
Sau khi tạo khóa API trong bảng điều khiển, làm theo tài liệu để bắt đầu với Claude Fable 5.1.
Chuẩn bị tài khoản và thử trực tuyến
Đăng nhập, xác nhận số dư và tạo khóa API.
Thử trong khu thử nghiệm
Khám phá khả năng mô hình trong khu thử nghiệm để tìm cách dùng phù hợp nhất.
Tích hợp Claude Fable 5.1 vào doanh nghiệp
Làm theo tài liệu lập trình viên để tích hợp Claude Fable 5.1 vào doanh nghiệp.
Nâng cấp mô hình trong tương lai
Để chuyển sang mô hình mới hơn, trước tiên xác nhận danh mục mô hình của khóa API trả đúng ID đó. Nếu hỗ trợ cùng endpoint và trường yêu cầu, cập nhật ID mô hình rồi kiểm thử định dạng phản hồi, truyền trực tiếp, giới hạn đầu ra và tính phí trước khi gửi lưu lượng sản xuất. Với tác vụ hình ảnh hoặc video bất đồng bộ, cũng xác minh gửi tác vụ, thăm dò trạng thái và lấy kết quả.
Câu hỏi thường gặp về API Claude Fable 5.1
Claude Fable 5.1 có cùng mô hình API với Fable 5 không?
Không. Claude Fable 5.1 (tên mô hình API: claude-fable-5-1) là phiên bản nâng cấp của Claude Fable 5 (tên mô hình API: claude-fable-5). Dùng đúng tham số model khi gọi API.
Vì sao thinking rỗng hoặc câu trả lời chưa đầy đủ?
Fable 5.1 gốc mặc định dùng suy luận thích ứng và có thể không hiển thị nội dung suy luận. Yêu cầu thông thường không cần tham số thinking; riêng thinking rỗng không phải thất bại. Nếu câu trả lời chưa đầy đủ, kiểm tra trạng thái hoàn tất và giới hạn đầu ra, dành đủ dung lượng cho cả suy luận lẫn văn bản cuối.
Cách xử lý lỗi xác thực, số dư hoặc quyền truy cập?
Làm theo tài liệu lỗi API để chẩn đoán vấn đề.
Có thể dùng OpenAI Responses cho Claude Fable 5.1 không?
Không hỗ trợ OpenAI Responses. Claude có định dạng Claude Messages riêng; xem tài liệu để biết chi tiết.
Có thể bắt buộc gọi công cụ hoặc chỉnh sửa hội thoại Messages gốc không?
Fable 5.1 gốc không hỗ trợ kiểu tool_choice bắt buộc any hoặc tool. Thận trọng khi gửi lại suy luận đã lưu sau khi chỉnh sửa tin nhắn trước đó. Giữ nguyên khối nội dung assistant gốc và chữ ký khi tiếp tục công cụ.
Bộ nhớ hội thoại có vĩnh viễn không?
Không. API không tự lưu ngữ cảnh hội thoại cho yêu cầu tiếp theo. Tự quản lý lịch sử và kèm ngữ cảnh cần thiết trong mỗi yêu cầu. Ứng dụng của bạn phải triển khai bộ nhớ dài hạn.
API văn bản liên quan
Ví dụ API Claude Fable 5.1 và tham số được hỗ trợ
Bắt đầu nhanh API Claude Fable 5.1
claude-fable-5-1model là bắt buộc; ví dụ dùng ID mô hình của trang hiện tại. Kiểm tra quyền truy cập mô hình của khóa API bằng GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages yêu cầu max_tokens. Hạn mức trong ví dụ này có thể sửa, không phải mặc định thượng nguồn hay giới hạn mô hình. Suy luận có thể dùng hết trước khi có văn bản trả lời; điều chỉnh theo tác vụ và kiểm tra chi phí đầu ra.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Tham chiếu nhóm và giao thức
API Claude Messages
Tài liệu API đầy đủAPI tương thích Claude Messages nguyên bản. Điểm cuối dùng cấu trúc yêu cầu và phản hồi Anthropic Messages, gồm lời gọi công cụ và sự kiện Anthropic SSE.
POST
https://api.apihop.ai/anthropic/v1/messages