इन कृत्रिम रिकॉर्ड को id, owner, deadline और evidence फ़ील्ड वाले JSON में निकालें: [R1] समस्या 41: Ana निर्यात सुधार की ज़िम्मेदार हैं; समय सीमा तय नहीं। [R2] समस्या 42: समीक्षा 15 अक्टूबर तक करनी है; ज़िम्मेदार तय नहीं; वर्ष नहीं बताया गया। गुम वैल्यू के लिए null इस्तेमाल करें और अधूरी तारीखें जैसी दी गई हैं वैसी रखें। evidence में स्रोत उद्धृत करें। वर्ष या ज़िम्मेदार व्यक्ति न गढ़ें। हर फ़ील्ड उसके रिकॉर्ड से जाँचें; यह टेक्स्ट प्रारूपण का कार्य है, डेटाबेस ऑपरेशन नहीं।
कोडिंग और शोध के लिए Claude Fable 5.1 API
कई चरणों वाली कोडिंग और शोध के लिए Claude Fable 5.1 API मूल्य और इंटीग्रेशन विकल्पों की तुलना करें। तर्क मार्गदर्शन पढ़ें और टेक्स्ट प्रॉम्प्ट ऑनलाइन जाँचें।
Claude Fable 5.1 API मूल्य और बिलिंग
आधिकारिक मूल्य
- इनपुट
- $10.0000 /M
- आउटपुट
- $50.0000 /M
- कैश किया गया इनपुट
- $0.2500 /M
- कैश लेखन (5 मिनट)
- $12.5000 /M
- कैश लेखन (1 घंटा)
- $20.0000 /M
API Hop मूल्य बचत 45%
- इनपुट
- $5.5000 /M
- आउटपुट
- $27.5000 /M
- कैश किया गया इनपुट
- $0.1375 /M
- कैश लेखन (5 मिनट)
- $6.8750 /M
- कैश लेखन (1 घंटा)
- $11.0000 /M
संदर्भ मूल्य का स्वतंत्र सत्यापन नहीं हुआ है। लागत की तुलना करने से पहले प्रकाशक की वर्तमान दरें, बिलिंग इकाइयाँ और लागू शर्तें जाँचें।
Claude Fable 5.1 ऑनलाइन चैट टूल
मॉडल सेटिंग
स्मृति क्या करती है?
यह इस बातचीत के पूरे और दोबारा इस्तेमाल योग्य आदान-प्रदान को आपके अगले अनुरोध में शामिल करती है, ताकि आप संदर्भ दोहराए बिना आगे के सवाल पूछ सकें।
बंद होने पर क्या होता है?केवल आपका नया संदेश और कोई सिस्टम प्रॉम्प्ट भेजा जाता है। मौजूदा संदेश दिखते रहते हैं; स्मृति फिर चालू करने पर योग्य पुराने आदान-प्रदान फिर शामिल हो जाते हैं।
क्या यह दीर्घकालिक स्मृति है?नहीं। यह इसी बातचीत का संदर्भ है, अलग बातचीतों के बीच की स्मृति नहीं। विफल, रोके गए, अधूरे या दोबारा इस्तेमाल न किए जा सकने वाले जवाब शामिल नहीं होते। अधिक इतिहास से इनपुट टोकन और लागत बढ़ सकते हैं।
उन्नत पैरामीटर
0 या अधिक अक्षर(0/कोई तय सीमा नहीं)
अक्षरों की कोई तय सीमा नहीं; पूरा अनुरोध आकार और मॉडल संदर्भ की सीमाओं के अधीन है। यह टोकन की संख्या नहीं है। बातचीत

आज मैं आपकी कैसे मदद कर सकता हूँ?
अभी प्रतिक्रिया डेटा नहीं है तैयार
Claude Fable 5.1 प्रॉम्प्ट उदाहरण
ये Claude Fable 5.1 के मूल्यांकन प्रॉम्प्ट हैं, दर्ज मॉडल आउटपुट नहीं। ये केवल दिए टेक्स्ट का विश्लेषण करते हैं; कोड नहीं चलाते, प्रोडक्शन प्रणालियों की जाँच नहीं करते और लंबे संदर्भ का प्रदर्शन साबित नहीं करते। उद्धृत प्रमाण तथा स्वीकृति मानदंड जाँचें, फिर प्रोडक्शन उपयोग से पहले प्रतिक्रिया मेटाडेटा और उपयोग देखें।
केवल इस दस्तावेज़ नमूने का उपयोग करें: [P1] निर्यात सुधार स्टेजिंग जाँच में पास हुआ। [P2] शुक्रवार की रिलीज़ प्रस्तावित हुई, मंज़ूर नहीं। [P3] Mei मंगलवार को त्रुटि संदेशों की समीक्षा करेंगी। [P4] दस्तावेज़ों का कोई ज़िम्मेदार तय नहीं है। दावा, सटीक समर्थन उद्धरण, अनुच्छेद ID और अनिश्चितता की तालिका लौटाएँ। क्या प्रोडक्शन रिलीज़ मंज़ूर है? दस्तावेज़ों का ज़िम्मेदार कौन है? गुम तथ्य अज्ञात लिखें। हर उद्धरण दिए नमूने से मेल खाना चाहिए; स्टेजिंग से प्रोडक्शन सफलता न मानें। यह छोटा नमूना अधिकतम संदर्भ लंबाई नहीं जाँचता।
इस काल्पनिक भुगतान वेबहुक नीति की समीक्षा करें: हर विफल POST तीन बार दोहराया जाता है, कोई idempotency कुंजी सहेजी नहीं जाती और प्रतिक्रिया भेजने से पहले बैलेंस कटता है। दोहरे शुल्क के जोखिम पहचानें, न्यूनतम बदलाव और तीन स्वीकृति परीक्षण सुझाएँ। केवल इन्हीं तथ्यों का उपयोग करें; कोड, टूल या प्रोडक्शन प्रणालियों की पहुँच न मानें।
Claude Fable 5.1 क्या है?
कई चरणों की कोडिंग और शोध
Claude Fable 5.1 Anthropic द्वारा 1 सितंबर, 2026 को जारी मॉडल है, जिसका ध्यान निरंतर विश्लेषण, कई चरणों के कार्य और टूल के साथ सहयोग पर है। केवल तेज़ जवाब देने के बजाय यह गहरे विचार की ज़रूरत वाली जटिल कोडिंग समस्याओं और विस्तृत शोध के लिए उपयुक्त है। इसके मूल विनिर्देश टेक्स्ट और इमेज इनपुट, टेक्स्ट आउटपुट, दस लाख टोकन संदर्भ विंडो तथा अधिकतम 128K आउटपुट टोकन समर्थित करते हैं। मूल API में high प्रयास डिफ़ॉल्ट है और कार्य के अनुसार तर्क प्रयास बदला जा सकता है।
API जोड़ने से पहले टेक्स्ट चैट आज़माएँ
API Hop का ऑनलाइन टूल Fable 5.1 जल्दी आज़माने देता है: लॉग इन करें, API कुंजी बनाएँ और थोड़ा बैलेंस जोड़कर API इंटीग्रेशन या सदस्यता खरीदे बिना मॉडल परखें। अलग Anthropic खाता खोलने की ज़रूरत नहीं, लेकिन यह खाते के प्रतिबंधों से बचने की गारंटी नहीं; लागू प्लेटफ़ॉर्म शर्तें बनी रहती हैं। यह पेज टेक्स्ट बातचीत समर्थित करता है, फ़ाइल अपलोड, वेब ब्राउज़िंग या कोड निष्पादन नहीं।
Claude Fable 5.1 किस काम में इस्तेमाल कर सकते हैं?
डीबगिंग और कोड समीक्षा
Anthropic, Fable 5.1 के प्रमुख उपयोगों में कई कोडबेस का विकास, कोड समीक्षा और प्रदर्शन कार्य बताता है। त्रुटि ट्रेस, संबंधित कोड, वातावरण विवरण और दोहराने के चरण दें; यह कंपाइलर त्रुटियाँ, स्टैक और अपरिचित लाइब्रेरी स्रोत पढ़कर निर्भरताएँ समझ और समाधान सुझा सकता है। एक ग्राहक ने वर्षों से पूरी तरह न सुलझे दुर्लभ क्रैश का वर्णन किया: Fable 5.1 ने बाहरी लाइब्रेरी डिसअसेंबल की, क्रैश डंप की तुलना की और समस्या का कारण उसी लाइब्रेरी के दोष तक ढूँढ़कर अंततः हल किया।
आप इससे इंटरफ़ेस संगतता, अपवाद पथ, अनुमति जाँच, संसाधन सफ़ाई और डेटा संगति भी जाँचवा सकते हैं। इसे विकल्प सुझाने वाला अनुभवी सहायक समझें; निर्णयों की ज़िम्मेदारी डेवलपर की रहती है।
शोध और विश्लेषण
शोध और विश्लेषण एक और प्रमुख उपयोग है। सामग्री का सार देने से आगे Fable 5.1 किसी सवाल पर गणना कर, परिणाम देख और अपना तरीका बदल सकता है। एक ग्राहक के अनुसार अनुकूलन कार्य में Fable 5 को अतिरिक्त निर्देश चाहिए थे, लेकिन Fable 5.1 को वही मार्गदर्शन नहीं चाहिए था। एप्लिकेशन से मिले खोज या डेटा टूल के साथ यह सार्वजनिक डेटा का विश्लेषण, प्रस्ताव का मसौदा और ज़रूरत के अनुसार मूल्यांकन कर सकता है; यह टेक्स्ट पेज स्वयं वेब नहीं ब्राउज़ करता।
सार्वजनिक डेटा में काफ़ी अप्रासंगिक सामग्री हो सकती है। व्यवसाय की अपनी समझ के अनुसार भरोसेमंद स्रोत बनाएँ या हमारी इंजीनियरिंग और व्यावसायिक टीम द्वारा चुने API Hop डेटा API इस्तेमाल करें।
लेखन और दस्तावेज़ मसौदे
Fable 5.1 के प्रमुख लेखन सुधार केवल लंबे लेख बनाना नहीं, बल्कि स्पष्ट अभिव्यक्ति और लेखन आवश्यकताओं का बेहतर पालन हैं। Anthropic का लेखन मार्गदर्शन मॉडल को मुख्य लेखक के बजाय सहायक की भूमिका में रखने तथा AI सामग्री की स्वयं समीक्षा और निर्णय जारी रखने की सलाह देता है।
Anthropic दर्शक, पाठक की जानकारी या समस्या की ज़रूरत, आवश्यक जानकारी और बचने वाली अभिव्यक्तियाँ स्पष्ट करने की सलाह देता है। केवल पेशेवर लेख माँगने की तुलना में ठोस लक्ष्य, संरचना और उदाहरण उपयोगी मसौदा मिलने की संभावना बढ़ाते हैं।
लंबे दस्तावेज़ और कई चरणों की चर्चा
Artificial Analysis की तुलना में Fable 5.1 का समग्र सूचकांक Kimi K3 से ऊँचा है, लेकिन AA-LCR v1.1 लंबे संदर्भ के तर्क में इसके 85% के मुकाबले Kimi K3 के 89% हैं। कॉन्फ़िगरेशन Fable 5.1 के लिए Max और Default Fallback तथा Kimi K3 के लिए Max हैं। इसलिए इस विशेष लंबे दस्तावेज़ तर्क परीक्षण में Kimi K3 आगे है; इससे Fable 5.1 को सबसे मजबूत लंबे दस्तावेज़ मॉडल कहना उचित नहीं।
लंबे वर्कफ़्लो में संदर्भ संक्षिप्त होने के बाद महत्वपूर्ण सीमाएँ, पहले लिए निर्णय या सटीक विवरण खो सकते हैं, जैसा Anthropic का प्रॉम्प्ट मार्गदर्शन बताता है। अपने एप्लिकेशन में संभव हो तो हर बातचीत में आवश्यक जानकारी बनाए रखें।
Claude Fable 5.1 बेंचमार्क: कोडिंग, तर्क और गति
नीचे Anthropic के लॉन्च मूल्यांकन और Artificial Analysis के स्वतंत्र मूल्यांकन अलग दिए हैं। उनकी सेटिंग अलग हैं और कोई भी API Hop का माप नहीं है।
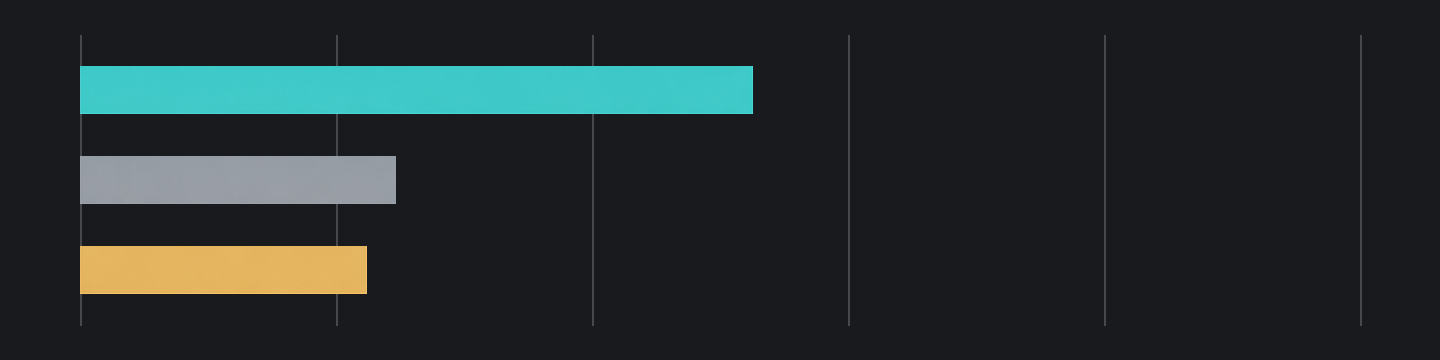
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
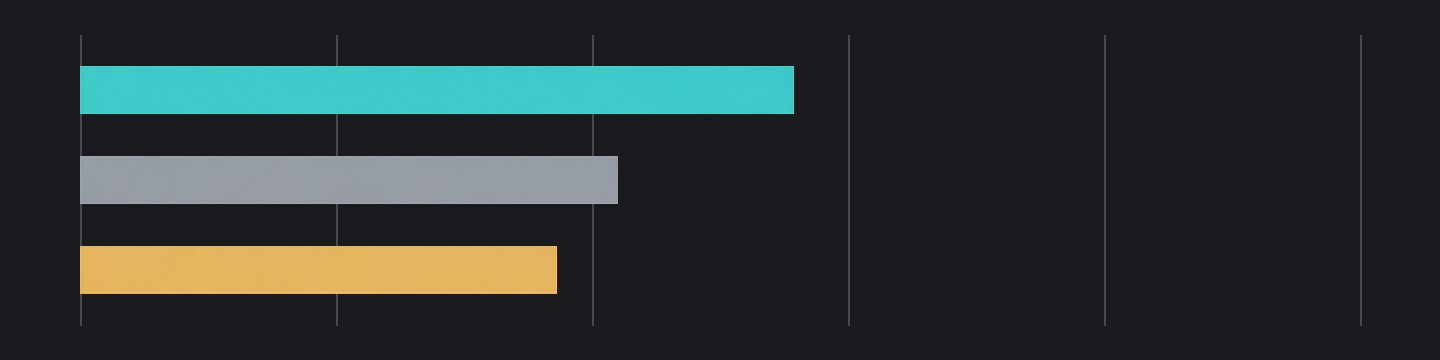
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
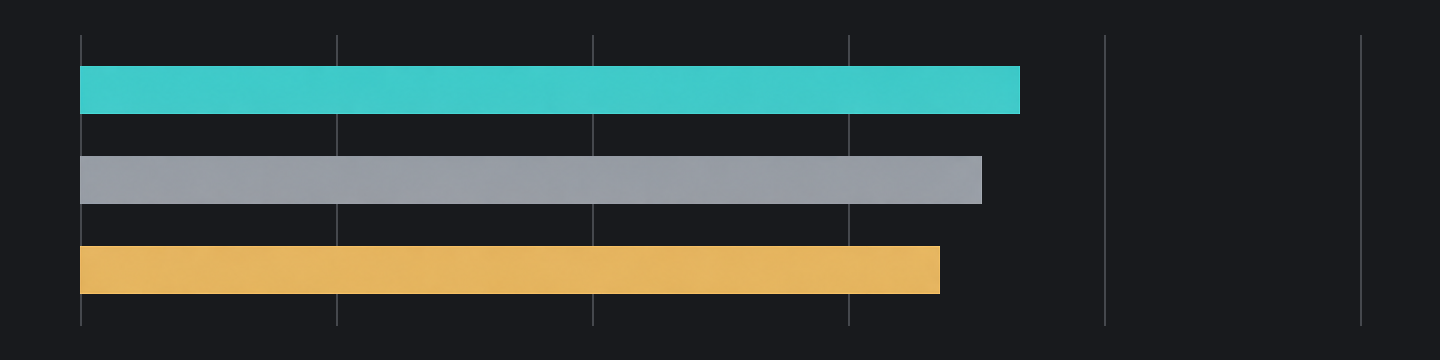
Fable 5.1: 60.9%Fable 5: 57.8%
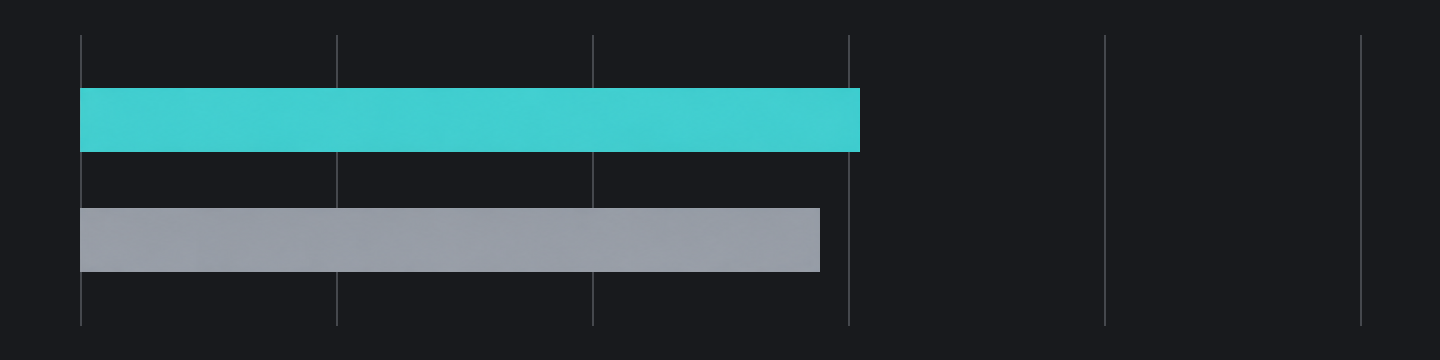
Fable 5.1: 65.0%Fable 5: 63.8%
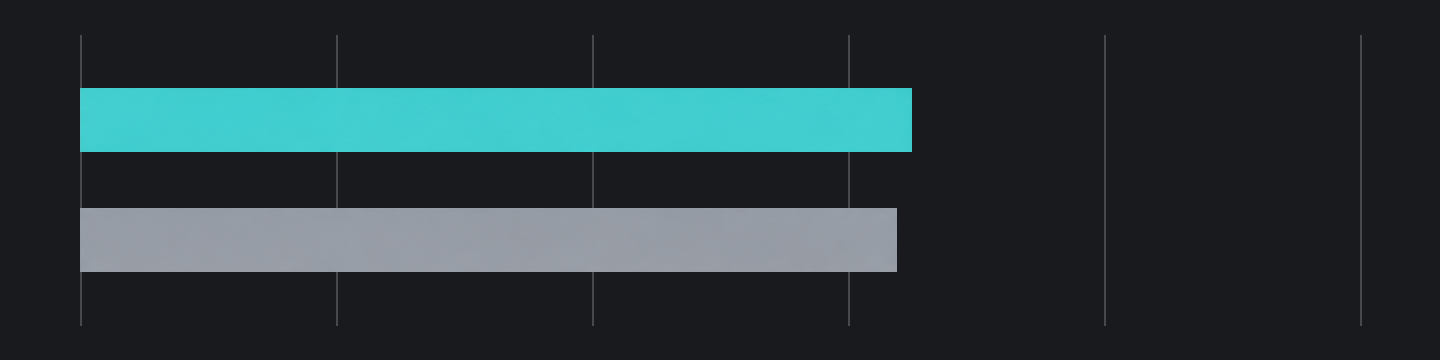
कोडिंग: सबसे बड़ा सुधार टर्मिनल कार्य में
Fable 5.1 का सबसे स्पष्ट कोडिंग सुधार उन टर्मिनल कार्यों में है जिनमें वातावरण चलाना, निष्पादन परिणाम सँभालना और काम जारी रखना पड़ता है, हर कोडिंग कार्य में समान औसत सुधार नहीं। Anthropic, Fable 5 से Terminal-Bench-Science 0.1 पर 27.9 प्रतिशत अंक, Terminal-Bench 4.0 पर 13.8 अंक और CursorBench 3.2.0 पर 2.9 अंक की वृद्धि बताता है। ये अंतर कोड जनरेशन गुणवत्ता में समान छलाँग के बजाय जटिल कार्य निष्पादन मजबूत होने का संकेत देते हैं।
महत्व विश्लेषण को व्यावहारिक कार्रवाई से जोड़ने में है। Anthropic कई कोडबेस में विकास, स्वतंत्र परीक्षण लेखन और दृश्य परिणामों से कार्यान्वयन लक्ष्य पूरे होने की जाँच बताता है। हमारी व्याख्या है कि यह संभावित प्रस्ताव पर रुकने के बजाय समाधान समझने, बदलने, सत्यापित करने और सुधारने के लिए बेहतर स्थिति में है।
तर्क: छोटे सुधार, जो सेटिंग पर निर्भर हैं
तर्क बेहतर हुआ है, लेकिन कुछ प्रकाशित परीक्षणों में टर्मिनल कार्यों से छोटा सुधार है। Humanity's Last Exam में टूल के बिना स्कोर Fable 5 के 57.8% से 60.9% और टूल के साथ 63.8% से 65.0% होता है: क्रमशः 3.1 और 1.2 प्रतिशत अंक की वृद्धि।
हम प्रयास को ऐसा सरल स्विच नहीं मानते जिसमें अधिक हमेशा अधिक बुद्धिमान हो। Anthropic का मार्गदर्शन इसे क्षमता, विलंब और लागत का प्रमुख नियंत्रण बताता है तथा स्पष्ट करता है कि अलग मॉडल में समान प्रयास लेबल समान मात्रा में तर्क नहीं दर्शाते।
सामुदायिक चर्चा उपयोगी प्रतिउदाहरण देती है। Hacker News उपयोगकर्ता seaurchinzee की सिस्टम कार्ड की व्याख्या है कि सबसे अधिक प्रयास FrontierCode Extended पर सर्वोत्तम प्रदर्शन नहीं करता और ऊँची सेटिंग बिना माँगे बदलाव बढ़ा सकती हैं। यह खास कोडिंग मूल्यांकन है, HLE नहीं, लेकिन दिखाता है कि अधिक तर्क हमेशा कार्य का बेहतर पालन नहीं है। शुद्धता के साथ दायरा भी महत्वपूर्ण है और Anthropic का प्रॉम्प्ट मार्गदर्शन अतिरिक्त बदलाव तथा दायरा बढ़ाने पर अलग चर्चा करता है।
स्वतंत्र सूचकांक और थ्रूपुट: दो अलग सवाल
हमारे अनुसार Fable 5.1 की समग्र क्षमता और प्रतिक्रिया गति को एक स्कोर में समेटने के बजाय अलग परखना चाहिए। 4 अक्टूबर, 2026 की जाँच में Artificial Analysis, Max और Default Fallback कॉन्फ़िगरेशन के लिए Intelligence Index 53, लगभग 66.2 आउटपुट टोकन प्रति सेकंड तथा पहले टोकन तक लगभग 259.12 सेकंड दर्ज करता है।
उसी SVG चित्र कार्य में high को लगभग 29.6 सेकंड और max को लगभग 13 मिनट 54 सेकंड लगे। हमें सबसे अधिक प्रयास का परिणाम बेहतर लगता है, लेकिन प्रतीक्षा और आउटपुट उपयोग भी काफ़ी बढ़े। हमारा निष्कर्ष है कि अतिरिक्त तर्क कुछ जटिल आउटपुट बेहतर कर सकता है।
Claude Fable 5.1 बनाम Fable 5, GPT-5.6 Sol और Kimi K3
Fable 5.1 के पक्ष में सबसे प्रत्यक्ष प्रमाण टर्मिनल कार्यों में उसकी बढ़त है। नीचे की तालिका Anthropic का लॉन्च मूल्यांकन है।
Fable 5.1: 53Kimi K3: 44
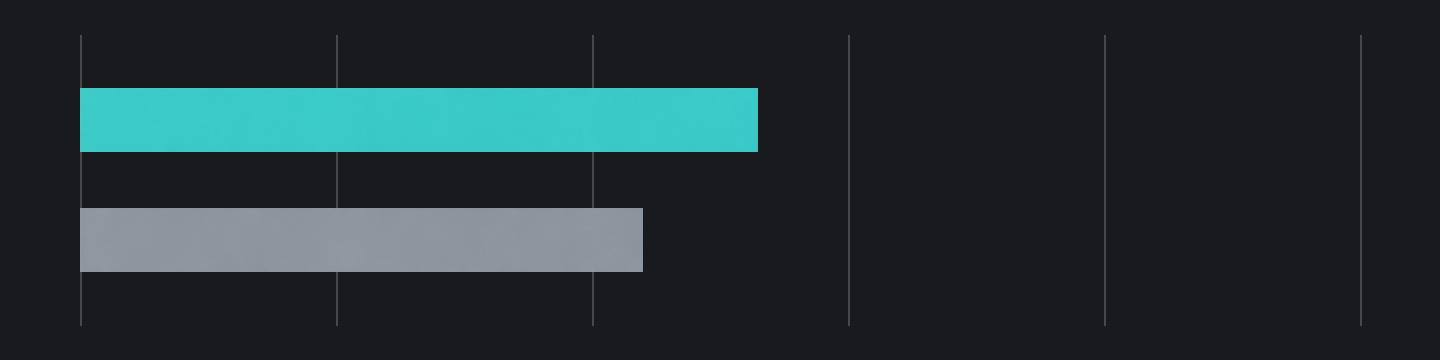
Fable 5.1: 52%Kimi K3: 13%
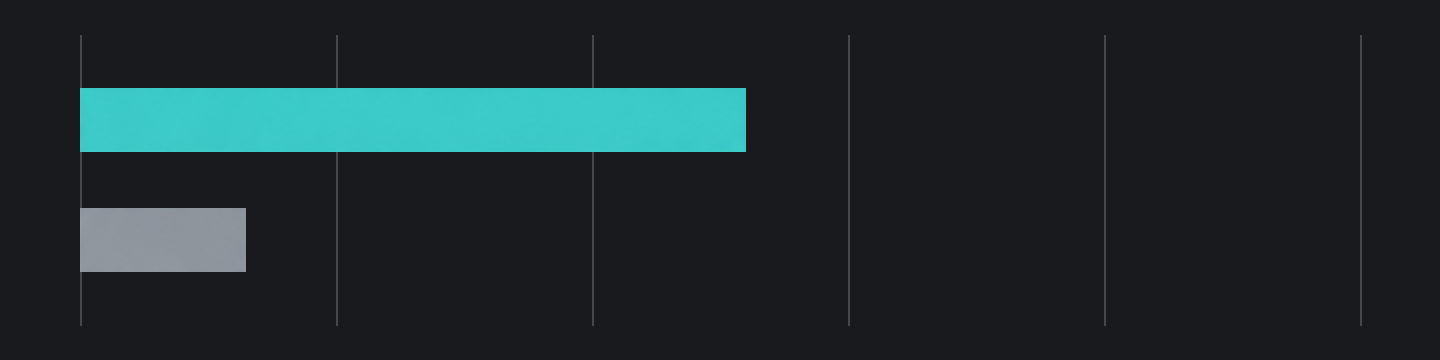
Fable 5.1: 85%Kimi K3: 89%
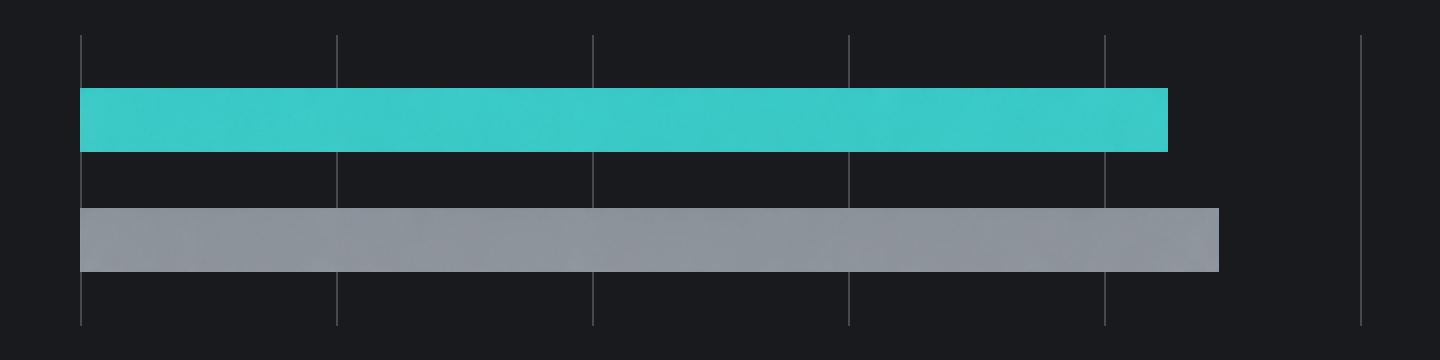
| बेंचमार्क | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Fable 5 और GPT-5.6 Sol के मुकाबले: सबसे स्पष्ट बढ़त टर्मिनल कोडिंग में
ये स्कोर दिखाते हैं कि GPT-5.6 Sol पर Fable 5.1 की बढ़त दोनों टर्मिनल बेंचमार्क में CursorBench से अधिक है। एक ग्राहक ने बताया कि उसके परीक्षणों में Fable 5.1 ने प्रति कार्य लागत घटाते हुए Fable 5 के बराबर या थोड़ा बेहतर प्रदर्शन किया, इसलिए उसने कोड समीक्षा में मॉडल इस्तेमाल करना शुरू किया।
Kimi K3 के मुकाबले: लंबे दस्तावेज़ तर्क में क्रम उलटता है
हमारा मूल्यांकन है कि इस तुलना के समग्र मूल्यांकन में Fable 5.1 मजबूत है। Artificial Analysis में Fable 5.1 का सूचकांक 53 और Kimi K3 का 44 है, जबकि Terminal-Bench 4.0 स्कोर क्रमशः 52% और 13% हैं। AA-LCR v1.1 लंबे संदर्भ के तर्क में क्रम उलटता है: Fable 5.1 के 85% और Kimi K3 के 89% हैं।
कुछ उपयोगकर्ताओं को Kimi K3 के स्पष्टीकरण बेहतर लग सकते हैं और वे कोड समीक्षा या समस्या समझने के लिए उस पर स्विच कर सकते हैं। हमारा वर्तमान निष्कर्ष है कि समग्र क्षमता में Fable 5.1 आगे है, जबकि इस विशेष लंबे दस्तावेज़ परीक्षण में Kimi K3 आगे है।
API Hop के ज़रिए Claude Fable 5.1 क्यों इस्तेमाल करें?
उपयोग आधारित बिलिंग और मॉडल लागत अनुकूलन
शुल्क वर्तमान API Hop दरों और वास्तविक उपयोग के अनुसार हैं। ज़रूरत पर बैलेंस जोड़ें।
एकीकृत AI मॉडल और डेटा API, एक जगह कई मॉडल की पहुँच
एक API कुंजी कई AI मॉडल और डेटा सेवाएँ जोड़ती है, जिससे इंटीग्रेशन लागत घटती है और आप एक क्लिक में स्विच कर सकते हैं। व्यावसायिक एप्लिकेशन को AI और डेटा दोनों चाहिए।
हर कॉल की स्पष्ट जानकारी के साथ कॉल लॉग और एप्लिकेशन पहुँच नियंत्रण
हर API कॉल आपके डैशबोर्ड में दर्ज होती है। अलग एप्लिकेशन के लिए अलग API कुंजियाँ बनाएँ।
अपने कार्य के अनुसार आउटपुट का मूल्यांकन करें
API Hop से दस्तावेज़ में दी मॉडल ID और समर्थित पैरामीटर इस्तेमाल करें। अपने स्वीकृति मानदंडों पर आउटपुट परखें, फिर प्रोडक्शन उपयोग से पहले उपयोग रिकॉर्ड और प्रतिक्रिया मेटाडेटा जाँचें। मॉडल का नाम या उदाहरण हर परिणाम की गारंटी नहीं देता।
API Hop पर Claude Fable 5.1 कैसे इस्तेमाल करें
कंसोल में API कुंजी बनाने के बाद दस्तावेज़ के अनुसार Claude Fable 5.1 से शुरुआत करें।
खाता तैयार करें और ऑनलाइन जाँचें
लॉग इन करें, बैलेंस की पुष्टि करें और API कुंजी बनाएँ।
प्रयोग टूल में आज़माएँ
इस्तेमाल करने का सही तरीका जानने के लिए प्रयोग टूल में मॉडल की क्षमताएँ आज़माएँ।
Claude Fable 5.1 को अपने व्यवसाय में जोड़ें
Claude Fable 5.1 को अपने व्यवसाय में जोड़ने के लिए हमारे डेवलपर दस्तावेज़ देखें।
आगे के मॉडल अपग्रेड
नए मॉडल पर स्विच करने से पहले पुष्टि करें कि आपकी API कुंजी के मॉडल कैटलॉग में उसकी सटीक ID लौटती है। वही एंडपॉइंट और अनुरोध फ़ील्ड समर्थित होने पर मॉडल ID बदलें, फिर प्रोडक्शन ट्रैफ़िक भेजने से पहले प्रतिक्रिया प्रारूप, स्ट्रीमिंग, आउटपुट सीमा और बिलिंग जाँचें। एसिंक्रोनस इमेज या वीडियो कार्यों के लिए कार्य भेजना, स्थिति पोलिंग और परिणाम प्राप्ति भी सत्यापित करें।
Claude Fable 5.1 API के सामान्य सवाल
क्या Claude Fable 5.1 और Fable 5 एक ही API मॉडल हैं?
नहीं। Claude Fable 5.1 (API मॉडल नाम: claude-fable-5-1), Claude Fable 5 (API मॉडल नाम: claude-fable-5) का उन्नत संस्करण है। API कॉल में सही model पैरामीटर इस्तेमाल करें।
thinking खाली या जवाब अधूरा क्यों है?
मूल Fable 5.1 डिफ़ॉल्ट रूप से अनुकूलनीय तर्क इस्तेमाल करता है और तर्क का टेक्स्ट छिपा सकता है। सामान्य अनुरोधों में thinking पैरामीटर आवश्यक नहीं है और केवल खाली thinking का अर्थ विफलता नहीं है। जवाब अधूरा हो तो समाप्ति स्थिति और आउटपुट सीमा जाँचें, और तर्क तथा अंतिम टेक्स्ट दोनों के लिए पर्याप्त जगह रखें।
प्रमाणीकरण, बैलेंस या पहुँच की त्रुटियों का निवारण कैसे करें?
समस्या का निदान करने के लिए API त्रुटि दस्तावेज़ देखें।
क्या Claude Fable 5.1 के साथ OpenAI Responses इस्तेमाल कर सकते हैं?
OpenAI Responses समर्थित नहीं है। Claude का अपना Claude Messages प्रारूप है; विवरण के लिए दस्तावेज़ देखें।
क्या टूल कॉल अनिवार्य कर सकते हैं या मूल Messages बातचीत संपादित कर सकते हैं?
मूल Fable 5.1 अनिवार्य tool_choice any या tool समर्थित नहीं करता। पुराने संदेश संपादित करने के बाद सहेजा गया तर्क दोबारा भेजते समय सावधानी बरतें। टूल कार्य जारी रखते समय मूल assistant सामग्री ब्लॉक और हस्ताक्षर पूरे सुरक्षित रखें।
क्या बातचीत की स्मृति स्थायी रहती है?
नहीं। API अगले अनुरोधों के लिए बातचीत का संदर्भ अपने आप नहीं रखता। इतिहास स्वयं प्रबंधित करें और हर अनुरोध में ज़रूरी संदर्भ शामिल करें। दीर्घकालिक स्मृति आपके एप्लिकेशन को लागू करनी होगी।
संबंधित टेक्स्ट API
Claude Fable 5.1 API उदाहरण और समर्थित पैरामीटर
Claude Fable 5.1 API त्वरित शुरुआत
claude-fable-5-1model आवश्यक है; ये उदाहरण वर्तमान पेज की मॉडल ID इस्तेमाल करते हैं। GET /v1/models से अपनी API कुंजी की मॉडल पहुँच जाँचें।
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages में max_tokens आवश्यक है। इस उदाहरण की सीमा बदली जा सकती है; यह अपस्ट्रीम डिफ़ॉल्ट या मॉडल सीमा नहीं है। कोई जवाब आने से पहले तर्क प्रक्रिया इसे खर्च कर सकती है; अपने कार्य के अनुसार बदलें और आउटपुट लागत जाँचें।
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
मॉडल समूह और प्रोटोकॉल संदर्भ
Claude Messages इंटरफ़ेस
पूरे API दस्तावेज़मूल Claude Messages-संगत API। यह एंडपॉइंट Anthropic Messages अनुरोध और उत्तर संरचनाएँ इस्तेमाल करता है, जिनमें टूल कॉल और Anthropic SSE इवेंट शामिल हैं।
POST
https://api.apihop.ai/anthropic/v1/messages