Wyodrębnij te syntetyczne rekordy do JSON z polami id, owner, deadline i evidence: [R1] Zgłoszenie 41: Ana odpowiada za poprawkę eksportu; nie ustalono terminu. [R2] Zgłoszenie 42: przegląd do 15 października; nie przypisano osoby odpowiedzialnej; nie podano roku. Użyj null dla brakujących wartości i zachowaj częściowe daty w podanej postaci. Zacytuj źródło w evidence. Nie wymyślaj roku ani osoby odpowiedzialnej. Sprawdź każde pole z jego rekordem; to zadanie formatowania tekstu, a nie operacja na bazie danych.
API Claude Fable 5.1 do programowania i badań
Porównaj ceny API Claude Fable 5.1 i opcje integracji do wieloetapowego programowania oraz badań. Sprawdź wskazówki rozumowania i testuj polecenia tekstowe online.
Ceny i rozliczenia API Claude Fable 5.1
Cena oficjalna
- Wejście
- $10.0000 /M
- Wyjście
- $50.0000 /M
- Wejście z pamięci podręcznej
- $0.2500 /M
- Zapis w pamięci podręcznej (5 min)
- $12.5000 /M
- Zapis w pamięci podręcznej (1 godz.)
- $20.0000 /M
Cena API Hop Oszczędność 45%
- Wejście
- $5.5000 /M
- Wyjście
- $27.5000 /M
- Wejście z pamięci podręcznej
- $0.1375 /M
- Zapis w pamięci podręcznej (5 min)
- $6.8750 /M
- Zapis w pamięci podręcznej (1 godz.)
- $11.0000 /M
Cena referencyjna nie została niezależnie zweryfikowana. Przed porównaniem kosztów sprawdź aktualny cennik wydawcy, jednostki rozliczeniowe i obowiązujące warunki.
Narzędzie czatu online Claude Fable 5.1
Ustawienia modelu
Do czego służy pamięć?
Dołącza zakończone, możliwe do ponownego użycia wymiany z tej rozmowy do kolejnego żądania, aby umożliwić dalsze pytania bez powtarzania kontekstu.
Co się dzieje po wyłączeniu?Wysyłana jest tylko nowa wiadomość i ewentualne polecenie systemowe. Dotychczasowe wiadomości pozostają widoczne; ponowne włączenie pamięci znów dołącza odpowiednie wcześniejsze wymiany.
Czy to pamięć długoterminowa?Nie. To kontekst rozmowy, a nie pamięć między oddzielnymi rozmowami. Nieudane, zatrzymane, ucięte lub nienadające się do ponownego użycia odpowiedzi są pomijane. Dłuższa historia może zużywać więcej tokenów wejściowych i zwiększać koszt.
Parametry zaawansowane
0 lub więcej znaków(0/Brak stałego limitu)
Brak stałego limitu znaków; pełne żądanie podlega limitom rozmiaru żądania i kontekstu modelu. To nie jest liczba tokenów. Rozmowa

W czym mogę dziś pomóc?
Brak danych odpowiedzi Gotowe
Przykłady poleceń Claude Fable 5.1
To polecenia do oceny Claude Fable 5.1, a nie zarejestrowane wyniki modelu. Analizują tylko podany tekst; nie wykonują kodu, nie sprawdzają systemów produkcyjnych ani nie dowodzą wydajności długiego kontekstu. Sprawdź cytowane dowody i kryteria akceptacji, a przed użyciem produkcyjnym przejrzyj metadane odpowiedzi oraz użycie.
Użyj tylko tej próbki dokumentu: [P1] Poprawka eksportu przeszła kontrole w środowisku testowym. [P2] Wydanie w piątek zaproponowano, ale go nie zatwierdzono. [P3] Mei sprawdzi komunikaty błędów we wtorek. [P4] Nie przypisano osoby odpowiedzialnej za dokumentację. Zwróć tabelę twierdzeń, dokładnych cytatów potwierdzających, ID akapitów i niepewności. Czy zatwierdzono wydanie produkcyjne? Kto odpowiada za dokumentację? Oznacz brakujące fakty jako nieznane. Każdy cytat musi odpowiadać próbce; nie wnioskuj o sukcesie produkcyjnym na podstawie środowiska testowego. Ta mała próbka nie sprawdza maksymalnej długości kontekstu.
Przeanalizuj tę fikcyjną politykę webhooka płatności: każdy nieudany POST jest ponawiany trzy razy, klucz idempotencji nie jest zapisywany, a saldo obciążane jest przed wysłaniem odpowiedzi. Wskaż ryzyka podwójnych opłat, zaproponuj minimalne zmiany i trzy testy akceptacyjne. Używaj wyłącznie tych faktów; nie zakładaj dostępu do kodu, narzędzi ani systemów produkcyjnych.
Czym jest Claude Fable 5.1?
Wieloetapowe programowanie i badania
Claude Fable 5.1 to model wydany przez Anthropic 1 września 2026, ukierunkowany na ciągłą analizę, zadania wieloetapowe i współpracę z narzędziami. Zamiast tylko udzielać szybkich odpowiedzi, nadaje się do złożonych problemów programistycznych i dogłębnych badań wymagających namysłu. Natywna specyfikacja obsługuje wejście tekstowe i obrazowe, wyjście tekstowe, okno kontekstu miliona tokenów i do 128K tokenów wyjściowych. Natywne API domyślnie używa wysiłku high, a poziom wysiłku rozumowania można dostosować do zadania.
Wypróbuj czat tekstowy przed integracją API
Narzędzie online API Hop pozwala szybko wypróbować Fable 5.1: zaloguj się, utwórz klucz API i dodaj niewielkie saldo, aby rozpocząć ocenę modelu bez integracji API i zakupu subskrypcji. Nie potrzebujesz osobnego konta Anthropic, ale nie gwarantuje to braku ograniczeń konta; nadal obowiązują właściwe warunki platformy. Ta strona obsługuje rozmowy tekstowe, a nie przesyłanie plików, przeglądanie internetu czy wykonywanie kodu.
Do czego używać Claude Fable 5.1?
Debugowanie i przegląd kodu
Anthropic wymienia rozwój obejmujący wiele baz kodu, przegląd kodu i pracę nad wydajnością wśród głównych zastosowań Fable 5.1. Dostarcz ślady błędów, właściwy kod, szczegóły środowiska i kroki odtworzenia, a model może odczytać błędy kompilatora, stosy i nieznane źródła bibliotek, by prześledzić zależności i zaproponować rozwiązanie. Jeden klient opisał rzadką awarię, której zespół nie rozwiązał w pełni przez lata: Fable 5.1 zdezasemblował zewnętrzną bibliotekę, porównał zrzuty awarii i powiązał problem z błędem tej biblioteki, ostatecznie go rozwiązując.
Możesz też poprosić o sprawdzenie zgodności interfejsów, ścieżek wyjątków, kontroli uprawnień, zwalniania zasobów i spójności danych. Traktuj go jak doświadczonego asystenta proponującego warianty, podczas gdy programiści zachowują odpowiedzialność za decyzje.
Badania i analiza
Badania i analiza to kolejne główne zastosowanie. Oprócz podsumowywania materiału Fable 5.1 może prowadzić obliczenia związane z pytaniem, obserwować wyniki i dostosowywać podejście. Jeden klient podał, że zadanie optymalizacyjne wymagało dodatkowych instrukcji z Fable 5, ale już nie z Fable 5.1. Z narzędziami wyszukiwania lub danych dostarczonymi przez aplikację może analizować dane publiczne, przygotowywać propozycje i oceny według Twoich potrzeb; ta strona tekstowa sama nie przegląda internetu.
Dane publiczne mogą zawierać dużo szumu. Sugerujemy budowanie zaufanych źródeł na podstawie znajomości biznesu lub używanie API danych API Hop wybranych przez nasze zespoły inżynierskie i biznesowe.
Pisanie i przygotowywanie dokumentów
Główne usprawnienia pisania w Fable 5.1 to jaśniejszy przekaz i lepsze przestrzeganie wymagań, a nie samo tworzenie dłuższych artykułów. Wskazówki Anthropic zalecają utrzymywanie modelu w roli asystenta zamiast głównego autora treści oraz dalsze samodzielne sprawdzanie i ocenianie tekstów wygenerowanych przez AI.
Anthropic zaleca określenie odbiorców, informacji lub problemu czytelnika, informacji obowiązkowych i sformułowań, których należy unikać. Konkretne cele, struktura i przykłady częściej prowadzą do użytecznej wersji roboczej niż sama prośba o profesjonalny artykuł.
Długie dokumenty i rozmowy wieloturowe
W porównaniu Artificial Analysis Fable 5.1 ma wyższy indeks złożony niż Kimi K3, lecz uzyskuje 85% wobec 89% Kimi K3 w rozumowaniu na długim kontekście AA-LCR v1.1. Konfiguracje to Fable 5.1 przy Max z Default Fallback i Kimi K3 przy Max. Kimi K3 prowadzi więc w tym konkretnym teście rozumowania na długich dokumentach; nie uzasadnia to nazywania Fable 5.1 najsilniejszym modelem długich dokumentów.
Po skróceniu kontekstu w długim procesie mogą zaginąć ważne ograniczenia, podjęte decyzje lub dokładne szczegóły, co omawiają wskazówki Anthropic dotyczące poleceń. Jeśli możesz zaimplementować to w aplikacji, sugerujemy zachowywanie kluczowych informacji w każdej rozmowie.
Benchmarki Claude Fable 5.1: programowanie, rozumowanie i szybkość
Poniżej osobno przedstawiono oceny premierowe Anthropic i niezależne oceny Artificial Analysis. Ustawienia są różne i żadne z nich nie są pomiarami API Hop.
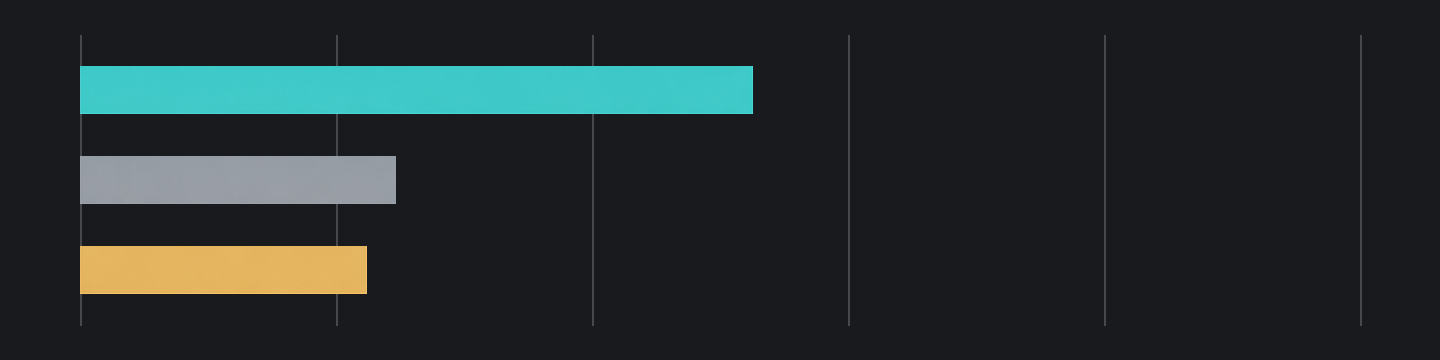
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
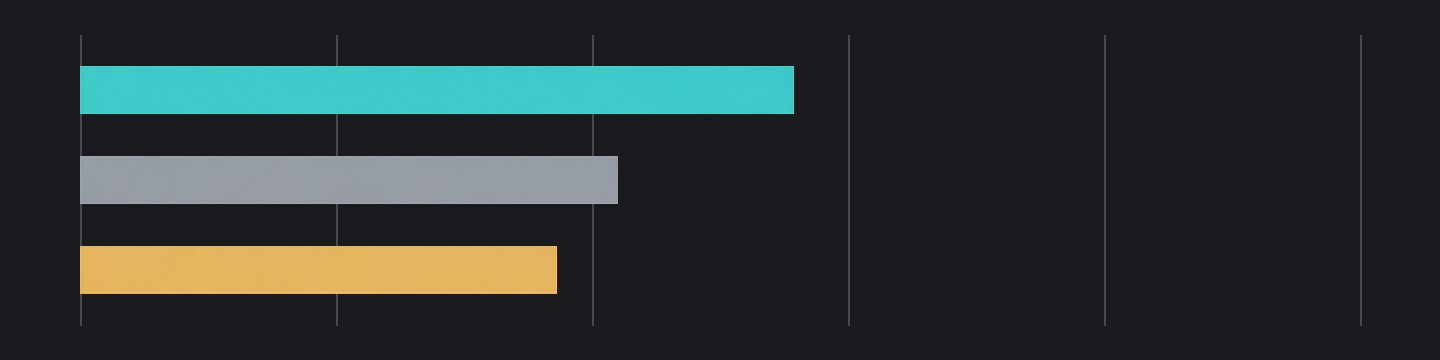
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
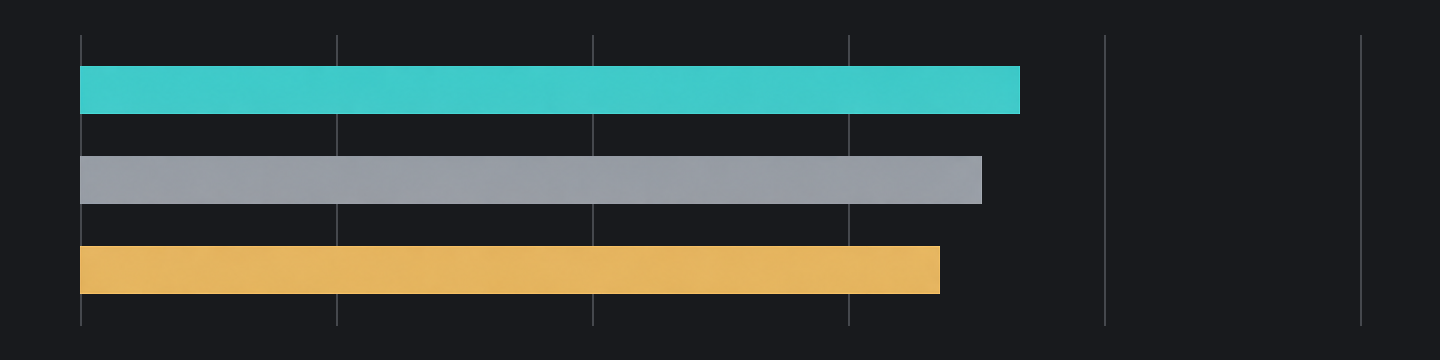
Fable 5.1: 60.9%Fable 5: 57.8%
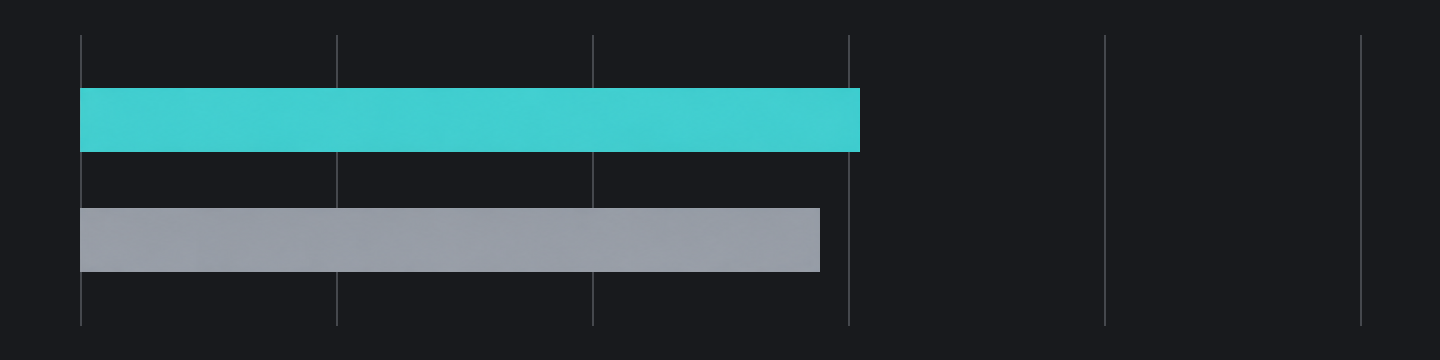
Fable 5.1: 65.0%Fable 5: 63.8%
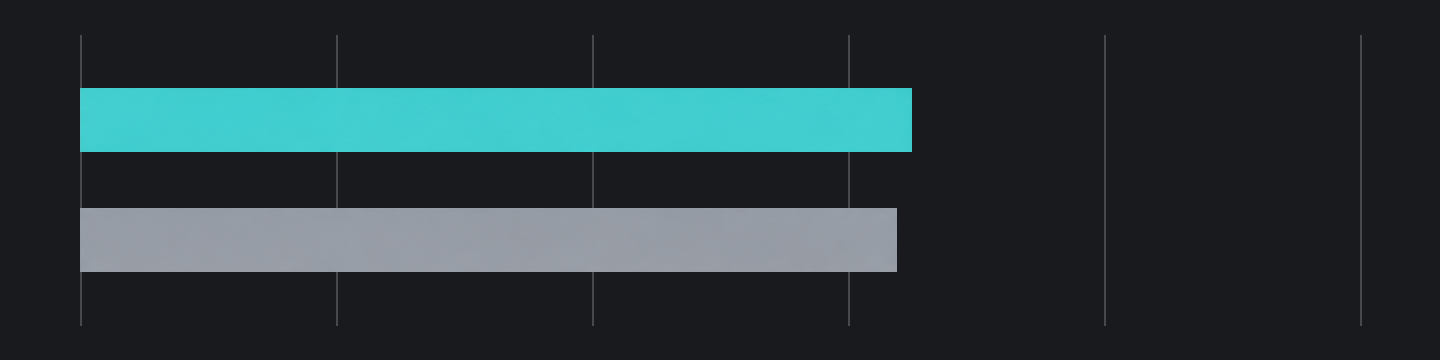
Programowanie: największy skok w pracy terminalowej
Najwyraźniejsze usprawnienie programowania Fable 5.1 dotyczy zadań terminalowych wymagających obsługi środowiska, przetwarzania wyników wykonania i kontynuowania pracy, a nie równomiernej poprawy wszystkich zadań programistycznych. Anthropic podaje wzrost względem Fable 5 o 27.9 punktu procentowego w Terminal-Bench-Science 0.1, 13.8 punktu w Terminal-Bench 4.0 i 2.9 punktu w CursorBench 3.2.0. Te różnice sugerują lepsze wykonywanie złożonych zadań, a nie jednolity skok jakości generowanego kodu.
Wartość polega na połączeniu analizy z praktycznym działaniem. Anthropic opisuje rozwój obejmujący wiele baz kodu, samodzielne pisanie testów i używanie wyników wizualnych do sprawdzania, czy implementacja spełnia cele. Interpretujemy to jako lepsze przygotowanie do zrozumienia, zmiany, weryfikacji i dopracowania rozwiązania zamiast zatrzymania się na wiarygodnej propozycji.
Rozumowanie: mniejsze zyski zależne od ustawień
Rozumowanie poprawiło się, lecz niektóre opublikowane testy pokazują mniejsze zyski niż zadania terminalowe. W Humanity's Last Exam wynik bez narzędzi rośnie z 57.8% Fable 5 do 60.9%, a z narzędziami z 63.8% do 65.0%: wzrost o 3.1 i 1.2 punktu procentowego.
Nie traktujemy wysiłku jako prostego przełącznika, gdzie wyższy zawsze oznacza mądrzejszy. Wskazówki Anthropic definiują go jako główne ustawienie możliwości, opóźnienia i kosztu oraz zaznaczają, że identyczne etykiety wysiłku w różnych modelach nie oznaczają identycznej ilości rozumowania.
Dyskusja społeczności daje użyteczny kontrprzykład. Użytkownik Hacker News seaurchinzee interpretuje kartę systemu jako wskazującą, że najwyższy wysiłek nie daje najlepszego wyniku w FrontierCode Extended, a wyższe ustawienia mogą zwiększać liczbę niezamówionych zmian. Dotyczy to konkretnej oceny programowania, a nie HLE, ale pokazuje, że więcej rozumowania nie zawsze oznacza lepsze trzymanie się zadania. Zakres ma znaczenie obok poprawności, a wskazówki Anthropic osobno omawiają dodatkowe zmiany i rozszerzanie zakresu.
Niezależny indeks i przepustowość: dwie osobne kwestie
Uważamy, że ogólne możliwości Fable 5.1 i szybkość odpowiedzi należy oceniać osobno zamiast sprowadzać do jednej oceny. Według sprawdzenia z 4 października 2026 Artificial Analysis podaje Intelligence Index 53 dla konfiguracji Max, Default Fallback, około 66.2 tokena wyjściowego na sekundę i około 259.12 sekundy do pierwszego tokenu.
W tym samym zadaniu rysowania SVG high zajęło około 29.6 sekundy, a max około 13 minut 54 sekundy. Uważamy wynik najwyższego wysiłku za lepszy, ale oczekiwanie i użycie wyjścia też znacznie wzrosły. Wnioskujemy, że dodatkowe rozumowanie może poprawić niektóre złożone wyniki.
Claude Fable 5.1 a Fable 5, GPT-5.6 Sol i Kimi K3
Najbardziej bezpośrednim argumentem za Fable 5.1 pozostaje przewaga w zadaniach terminalowych. Poniższa tabela przedstawia ocenę premierową Anthropic.
Fable 5.1: 53Kimi K3: 44
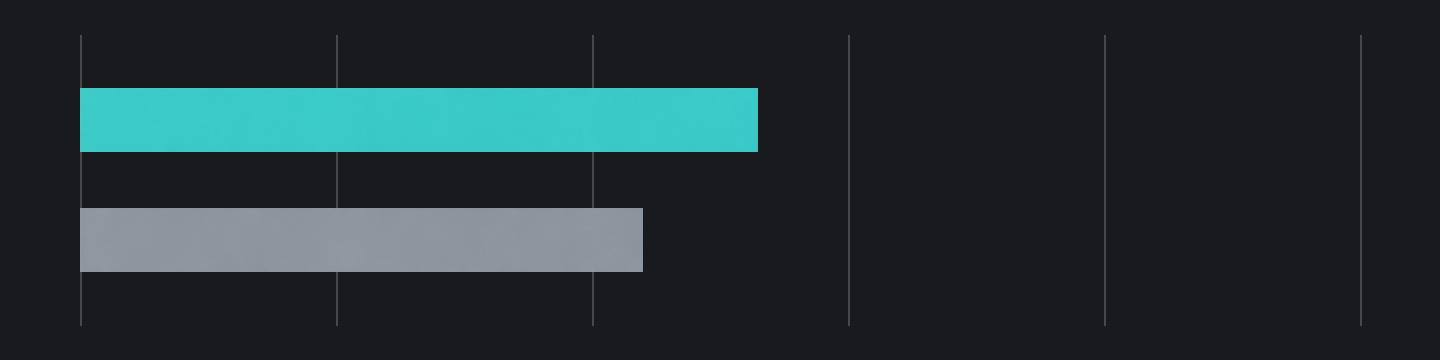
Fable 5.1: 52%Kimi K3: 13%
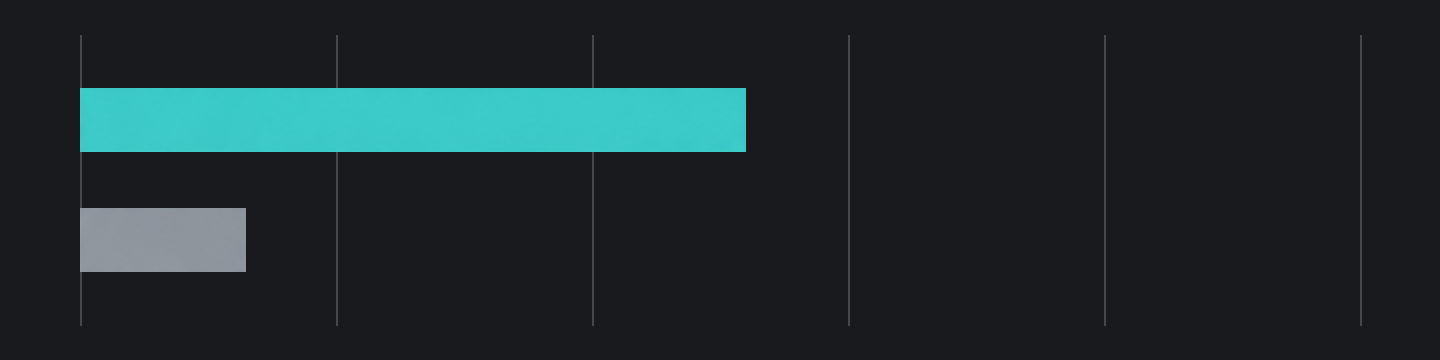
Fable 5.1: 85%Kimi K3: 89%
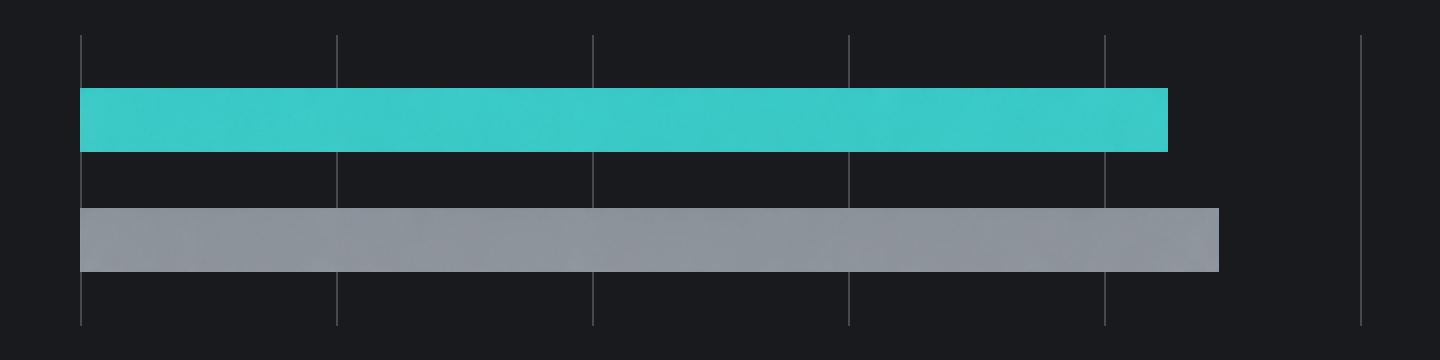
| Test porównawczy | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
Wobec Fable 5 i GPT-5.6 Sol: najwyraźniejsza przewaga w programowaniu terminalowym
Te wyniki pokazują większą przewagę Fable 5.1 nad GPT-5.6 Sol w dwóch benchmarkach terminalowych niż w CursorBench. Jeden klient podał, że Fable 5.1 dorównał lub nieznacznie przewyższył Fable 5 w jego testach, obniżając koszt zadania, co skłoniło go do używania modelu w przeglądzie kodu.
Wobec Kimi K3: rozumowanie na długich dokumentach odwraca ranking
Oceniamy, że Fable 5.1 jest silniejszy w ocenie złożonej w tym porównaniu. Artificial Analysis podaje indeks 53 dla Fable 5.1 i 44 dla Kimi K3 oraz wyniki Terminal-Bench 4.0 odpowiednio 52% i 13%. W rozumowaniu na długim kontekście AA-LCR v1.1 ranking się odwraca: Fable 5.1 uzyskuje 85%, a Kimi K3 89%.
Niektórzy użytkownicy mogą preferować wyjaśnienia Kimi K3 i wybierać go do przeglądu kodu lub zrozumienia problemu. Nasz obecny wniosek jest taki, że Fable 5.1 prowadzi pod względem łącznych możliwości, a Kimi K3 w tym konkretnym teście długich dokumentów.
Dlaczego warto używać Claude Fable 5.1 przez API Hop?
Rozliczenia za użycie i optymalizacja kosztów modeli
Opłaty wynikają z aktualnych stawek API Hop i rzeczywistego użycia. Doładowuj według potrzeb.
Wspólne modele AI i API danych z dostępem do wielu modeli w jednym miejscu
Jeden klucz API łączy wiele modeli AI i usług danych, ograniczając koszty integracji i umożliwiając przełączanie jednym kliknięciem. Aplikacje biznesowe potrzebują zarówno AI, jak i danych.
Dzienniki wywołań i kontrola dostępu aplikacji z przejrzystością każdego wywołania
Każde wywołanie API jest rejestrowane w pulpicie. Twórz osobne klucze API dla różnych aplikacji.
Oceniaj wyniki względem zadania
Używaj udokumentowanego ID modelu i obsługiwanych parametrów przez API Hop. Oceń wyniki według własnych kryteriów akceptacji, a przed użyciem produkcyjnym sprawdź zapisy użycia i metadane odpowiedzi. Nazwa modelu ani przykład nie gwarantują każdego wyniku.
Jak korzystać z Claude Fable 5.1 w API Hop
Po utworzeniu klucza API w konsoli postępuj zgodnie z dokumentacją, aby zacząć korzystać z Claude Fable 5.1.
Przygotuj konto i przetestuj online
Zaloguj się, sprawdź saldo i utwórz klucz API.
Wypróbuj w narzędziu online
Poznaj możliwości modelu w narzędziu online, aby znaleźć najlepszy sposób jego użycia.
Zintegruj Claude Fable 5.1 ze swoją firmą
Postępuj zgodnie z dokumentacją dla programistów, aby zintegrować Claude Fable 5.1 ze swoją firmą.
Przyszłe aktualizacje modeli
Aby przejść na nowszy model, najpierw potwierdź, że katalog modeli dla Twojego klucza API zwraca jego dokładny ID. Jeśli obsługuje ten sam punkt końcowy i pola żądania, zaktualizuj ID modelu, a następnie przetestuj formaty odpowiedzi, strumieniowanie, limity wyjścia i rozliczenia przed wysłaniem ruchu produkcyjnego. W asynchronicznych zadaniach obrazów lub wideo sprawdź też wysyłanie zadań, odpytywanie statusu i pobieranie wyników.
Częste pytania o API Claude Fable 5.1
Czy Claude Fable 5.1 i Fable 5 to ten sam model API?
Nie. Claude Fable 5.1 (nazwa modelu API: claude-fable-5-1) jest następcą Claude Fable 5 (nazwa modelu API: claude-fable-5). Używaj właściwej wartości model w wywołaniach API.
Dlaczego thinking jest puste lub odpowiedź niepełna?
Natywny Fable 5.1 domyślnie używa adaptacyjnego rozumowania i może ukrywać jego tekst. Zwykłe żądania nie wymagają parametru thinking, a samo puste thinking nie oznacza niepowodzenia. Jeśli odpowiedź jest niepełna, sprawdź stan zakończenia i limit wyjścia oraz zostaw miejsce zarówno na rozumowanie, jak i końcowy tekst.
Jak diagnozować błędy uwierzytelniania, salda lub dostępu?
Sprawdź dokumentację błędów API, aby zdiagnozować problem.
Czy można używać OpenAI Responses z Claude Fable 5.1?
OpenAI Responses nie jest obsługiwane. Claude używa własnego formatu Claude Messages; szczegóły znajdziesz w dokumentacji.
Czy można wymusić wywołanie narzędzia lub zmieniać natywne rozmowy Messages?
Natywny Fable 5.1 nie obsługuje wymuszania tool_choice o wartości any ani tool. Zachowaj ostrożność przy ponownym wysyłaniu zapisanego rozumowania po zmianie wcześniejszych wiadomości. Przy kontynuowaniu pracy narzędzi zachowaj w całości oryginalne bloki treści assistant i ich podpisy.
Czy pamięć rozmowy jest trwała?
Nie. API nie zachowuje automatycznie kontekstu rozmowy dla kolejnych żądań. Zarządzaj historią samodzielnie i dołączaj potrzebny kontekst do każdego żądania. Pamięć długoterminową musi zaimplementować Twoja aplikacja.
Powiązane API tekstowe
Przykłady API Claude Fable 5.1 i obsługiwane parametry
Szybki start API Claude Fable 5.1
claude-fable-5-1model jest wymagane; te przykłady używają ID modelu bieżącej strony. Sprawdź dostęp klucza API do modelu przez GET /v1/models.
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages wymaga max_tokens. Limit w tym przykładzie można edytować; nie jest domyślną wartością dostawcy ani limitem modelu. Rozumowanie może go zużyć przed tekstem odpowiedzi; dopasuj go do zadania i sprawdź koszty wyjścia.
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
Dokumentacja rodziny i protokołu
API Claude Messages
Pełna dokumentacja APINatywne API zgodne z Claude Messages. Ten punkt końcowy używa struktur żądań i odpowiedzi Anthropic Messages, w tym wywołań narzędzi i zdarzeń SSE Anthropic.
POST
https://api.apihop.ai/anthropic/v1/messages