สกัดบันทึกจำลองเหล่านี้เป็น JSON มีฟิลด์ id, owner, deadline และ evidence: [R1] ปัญหา 41: Ana ดูแลการแก้ส่งออก ยังไม่ตกลงกำหนดส่ง [R2] ปัญหา 42: กำหนดตรวจ 15 ตุลาคม ยังไม่มีผู้ดูแล ไม่ระบุปี ใช้ null สำหรับค่าที่ขาดและคงวันที่บางส่วนตามที่ให้ อ้างต้นฉบับใน evidence อย่าแต่งปีหรือผู้ดูแล ตรวจแต่ละฟิลด์เทียบกับบันทึก นี่คืองานจัดรูปแบบข้อความ ไม่ใช่การดำเนินการฐานข้อมูล
API Claude Fable 5.1 สำหรับเขียนโค้ดและวิจัย
เปรียบเทียบราคา API Claude Fable 5.1 และตัวเลือกการเชื่อมต่อสำหรับเขียนโค้ดและวิจัยหลายขั้นตอน ดูคำแนะนำการให้เหตุผลและทดสอบพรอมต์ข้อความออนไลน์
ราคาและการคิดค่าบริการ API Claude Fable 5.1
ราคาอย่างเป็นทางการ
- อินพุต
- $10.0000 /M
- เอาต์พุต
- $50.0000 /M
- อินพุตที่แคชไว้
- $0.2500 /M
- การเขียนแคช (5 นาที)
- $12.5000 /M
- การเขียนแคช (1 ชั่วโมง)
- $20.0000 /M
ราคา API Hop ประหยัด 45%
- อินพุต
- $5.5000 /M
- เอาต์พุต
- $27.5000 /M
- อินพุตที่แคชไว้
- $0.1375 /M
- การเขียนแคช (5 นาที)
- $6.8750 /M
- การเขียนแคช (1 ชั่วโมง)
- $11.0000 /M
ราคาอ้างอิงยังไม่ได้รับการตรวจสอบอย่างอิสระ โปรดตรวจสอบอัตราปัจจุบัน หน่วยคิดค่าบริการ และข้อกำหนดที่เกี่ยวข้องของผู้เผยแพร่ก่อนเปรียบเทียบต้นทุน
เครื่องมือแชตออนไลน์ Claude Fable 5.1
การตั้งค่าโมเดล
ความจำทำอะไร?
นำรอบสนทนาที่เสร็จสมบูรณ์และใช้ซ้ำได้จากบทสนทนานี้ไปในคำขอถัดไป เพื่อให้คุณถามต่อได้โดยไม่ต้องทวนบริบท
เมื่อปิดจะเกิดอะไรขึ้น?ส่งเฉพาะข้อความใหม่และพรอมต์ระบบถ้ามี ข้อความเดิมยังแสดงอยู่ การเปิดความจำอีกครั้งจะรวมรอบสนทนาก่อนหน้าที่เข้าเกณฑ์
นี่คือความจำระยะยาวหรือไม่?ไม่ใช่ นี่คือบริบทบทสนทนา ไม่ใช่ความจำข้ามบทสนทนาแยกกัน การตอบกลับที่ล้มเหลว หยุด ถูกตัด หรือใช้ซ้ำไม่ได้จะไม่รวม ประวัติที่มากขึ้นอาจใช้โทเคนอินพุตและมีค่าใช้จ่ายมากขึ้น
พารามิเตอร์ขั้นสูง
0 อักขระขึ้นไป(0/ไม่มีขีดจำกัดตายตัว)
ไม่มีขีดจำกัดอักขระตายตัว คำขอทั้งหมดอยู่ภายใต้ขีดจำกัดขนาดคำขอและบริบทโมเดล นี่ไม่ใช่จำนวนโทเคน บทสนทนา

วันนี้ให้ฉันช่วยอะไรคุณได้บ้าง?
ยังไม่มีข้อมูลการตอบกลับ พร้อม
ตัวอย่างพรอมต์ Claude Fable 5.1
นี่คือพรอมต์ประเมิน Claude Fable 5.1 ไม่ใช่เอาต์พุตโมเดลที่บันทึกไว้ วิเคราะห์เฉพาะข้อความที่ส่ง ไม่รันโค้ด ตรวจระบบจริง หรือพิสูจน์ประสิทธิภาพบริบทยาว ตรวจหลักฐานที่อ้างและเกณฑ์ยอมรับ แล้วดูเมทาดาทาการตอบกลับกับการใช้งานก่อนใช้จริง
ใช้เฉพาะตัวอย่างเอกสารนี้: [P1] การแก้ส่งออกผ่านการตรวจ staging [P2] เสนอเผยแพร่วันศุกร์แต่ยังไม่อนุมัติ [P3] Mei จะตรวจข้อความผิดพลาดวันอังคาร [P4] ยังไม่กำหนดผู้ดูแลเอกสาร ส่งตารางข้อกล่าวอ้าง คำอ้างสนับสนุนตรงต้นฉบับ ID ย่อหน้า และความไม่แน่นอน อนุมัติเผยแพร่จริงหรือยัง? ใครดูแลเอกสาร? ระบุข้อเท็จจริงที่ขาดว่าไม่ทราบ ทุกคำอ้างต้องตรงตัวอย่าง อย่าอนุมานความสำเร็จจริงจาก staging ตัวอย่างเล็กนี้ไม่ทดสอบความยาวบริบทสูงสุด
ตรวจนโยบายเว็บฮุกชำระเงินสมมตินี้: ทุก POST ที่ล้มเหลวลองซ้ำสามครั้ง ไม่เก็บคีย์ idempotency และหักยอดก่อนส่งการตอบกลับ ระบุความเสี่ยงคิดเงินซ้ำ เสนอการแก้ขั้นต่ำและการทดสอบยอมรับสามข้อ ใช้เฉพาะข้อเท็จจริงนี้ อย่าสมมติว่ามีสิทธิ์เข้าถึงโค้ด เครื่องมือ หรือระบบจริง
Claude Fable 5.1 คืออะไร?
เขียนโค้ดและวิจัยหลายขั้น
Claude Fable 5.1 เป็นโมเดล Anthropic เปิดตัววันที่ 1 กันยายน 2026 เน้นวิเคราะห์ต่อเนื่อง งานหลายขั้น และร่วมกับเครื่องมือ แทนแค่ตอบเร็ว เหมาะกับปัญหาโค้ดซับซ้อนและวิจัยลึกที่ต้องคิดมากขึ้น ข้อกำหนดดั้งเดิมรองรับอินพุตข้อความและภาพ เอาต์พุตข้อความ หน้าต่างบริบทหนึ่งล้านโทเคน และเอาต์พุตไม่เกิน 128K โทเคน API ดั้งเดิมเริ่มต้นความพยายาม high และปรับความพยายามให้เหตุผลตามงานได้
ลองแชตข้อความก่อนเชื่อม API
เครื่องมือออนไลน์ API Hop ให้ลอง Fable 5.1 เร็ว: เข้าสู่ระบบ สร้างคีย์ API และเติมเครดิตเล็กน้อยเพื่อเริ่มประเมินโดยไม่เชื่อม API หรือซื้อสมาชิก ไม่ต้องเปิดบัญชี Anthropic แยก แต่ไม่ได้รับประกันว่าจะไม่มีข้อจำกัดบัญชี เงื่อนไขแพลตฟอร์มที่เกี่ยวข้องยังมีผล หน้านี้รองรับสนทนาข้อความ ไม่รองรับอัปโหลดไฟล์ เปิดเว็บ หรือรันโค้ด
ใช้ Claude Fable 5.1 ทำอะไรได้บ้าง?
แก้บั๊กและตรวจโค้ด
Anthropic ระบุพัฒนาข้ามฐานโค้ด ตรวจโค้ด และงานประสิทธิภาพเป็นกรณีหลักของ Fable 5.1 ให้ร่องรอยข้อผิดพลาด โค้ดเกี่ยวข้อง รายละเอียดสภาพแวดล้อม และขั้นทำซ้ำ แล้วอ่านข้อผิดพลาดคอมไพเลอร์ สแต็ก และซอร์สไลบรารีไม่คุ้นเพื่อติดตามการพึ่งพาและเสนอแก้ได้ ลูกค้ารายหนึ่งอธิบายการล่มหายากที่ทีมแก้ไม่ครบหลายปี: Fable 5.1 แยกแอสเซมบลีไลบรารีภายนอก เทียบข้อมูลดัมป์ล่ม และตามถึงบกพร่องในไลบรารีจนแก้ได้
ขอให้ตรวจความเข้ากันได้อินเทอร์เฟซ เส้นทางข้อยกเว้น การตรวจสิทธิ์ คืนทรัพยากร และความสอดคล้องข้อมูลได้ด้วย ใช้เป็นผู้ช่วยมีประสบการณ์ที่เสนอทางเลือก โดยนักพัฒนายังรับผิดชอบการตัดสินใจ
วิจัยและวิเคราะห์
วิจัยและวิเคราะห์เป็นอีกกรณีหลัก นอกจากสรุปข้อมูล Fable 5.1 คำนวณตามคำถาม สังเกตผล และปรับแนวทางได้ ลูกค้ารายหนึ่งรายงานว่างานปรับปรุงต้องพรอมต์เพิ่มกับ Fable 5 แต่ไม่ต้องคำแนะนำเดิมกับ Fable 5.1 เมื่อแอปให้เครื่องมือค้นหาหรือข้อมูล สามารถวิเคราะห์ข้อมูลสาธารณะ ร่างข้อเสนอ และประเมินตามความต้องการ หน้าข้อความนี้ไม่ได้เปิดเว็บเอง
ข้อมูลสาธารณะอาจมีสัญญาณรบกวนมาก แนะนำสร้างแหล่งเชื่อถือตามความเข้าใจธุรกิจ หรือใช้ API ข้อมูล API Hop ที่ทีมวิศวกรรมและธุรกิจเราคัดเลือก
เขียนและร่างเอกสาร
การเขียน Fable 5.1 ดีขึ้นหลักที่สื่อสารชัดและทำตามข้อกำหนดเขียนดีขึ้น แทนแค่บทความยาวขึ้น แนวทางเขียน Anthropic แนะนำคงโมเดลเป็นผู้ช่วยแทนผู้เขียนหลัก และตรวจตัดสินเนื้อหา AI เองต่อไป
Anthropic แนะนำระบุผู้อ่าน ข้อมูลหรือปัญหาที่ผู้อ่านต้องการ ควรรวมข้อมูลใด และถ้อยคำที่ต้องเลี่ยง เป้าหมาย โครงสร้าง และตัวอย่างชัดมีแนวโน้มให้ร่างใช้ได้กว่าแค่ขอบทความมืออาชีพ
เอกสารยาวและอภิปรายหลายรอบ
การเทียบ Artificial Analysis ให้ Fable 5.1 ดัชนีรวมสูงกว่า Kimi K3 แต่ได้ 85% เทียบ Kimi K3 ที่ 89% บน AA-LCR v1.1 ให้เหตุผลบริบทยาว การตั้งค่าคือ Fable 5.1 ที่ Max พร้อม Default Fallback และ Kimi K3 ที่ Max ดังนั้น Kimi K3 นำทดสอบเอกสารยาวเฉพาะนี้ ไม่รองรับการเรียก Fable 5.1 ว่าเก่งเอกสารยาวที่สุด
หลังย่อบริบทในงานยาว ข้อจำกัดสำคัญ การตัดสินใจแล้ว หรือรายละเอียดแม่นยำอาจหาย ตามแนวทางพรอมต์ Anthropic หากนำไปทำในแอปได้ แนะนำเก็บข้อมูลสำคัญทุกสนทนา
ทดสอบมาตรฐาน Claude Fable 5.1: โค้ด เหตุผล และความเร็ว
การประเมินเปิดตัว Anthropic และการประเมินอิสระ Artificial Analysis แสดงแยกด้านล่าง การตั้งค่าต่างกันและทั้งคู่ไม่ใช่การวัด API Hop
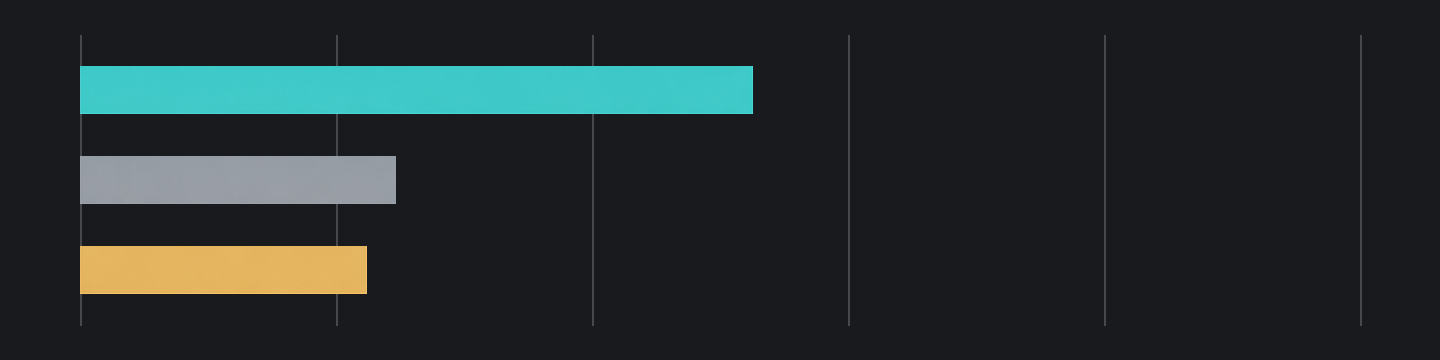
Fable 5.1: 52.6%Fable 5: 24.7%GPT-5.6 Sol: 22.4%
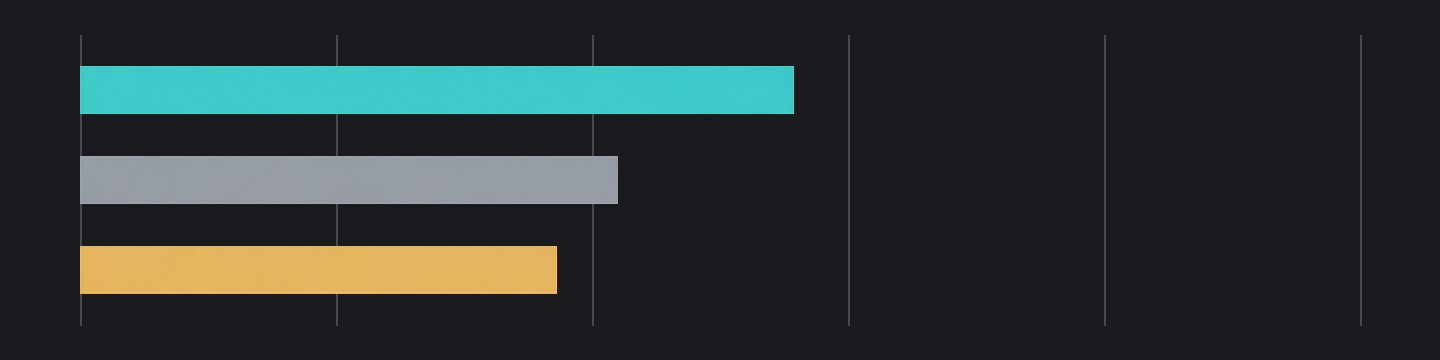
Fable 5.1: 55.8%Fable 5: 42.0%GPT-5.6 Sol: 37.3%
Fable 5.1: 73.4%Fable 5: 70.5%GPT-5.6 Sol: 67.2%
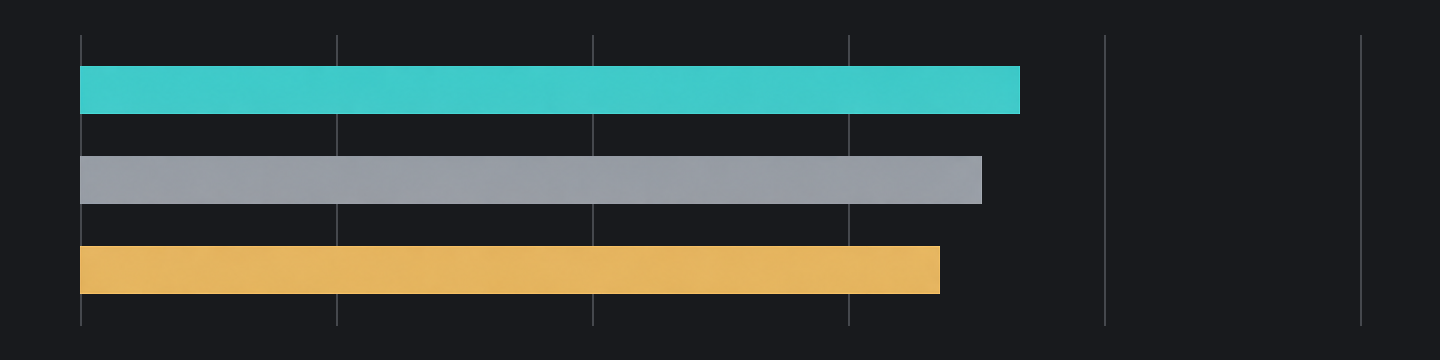
Fable 5.1: 60.9%Fable 5: 57.8%
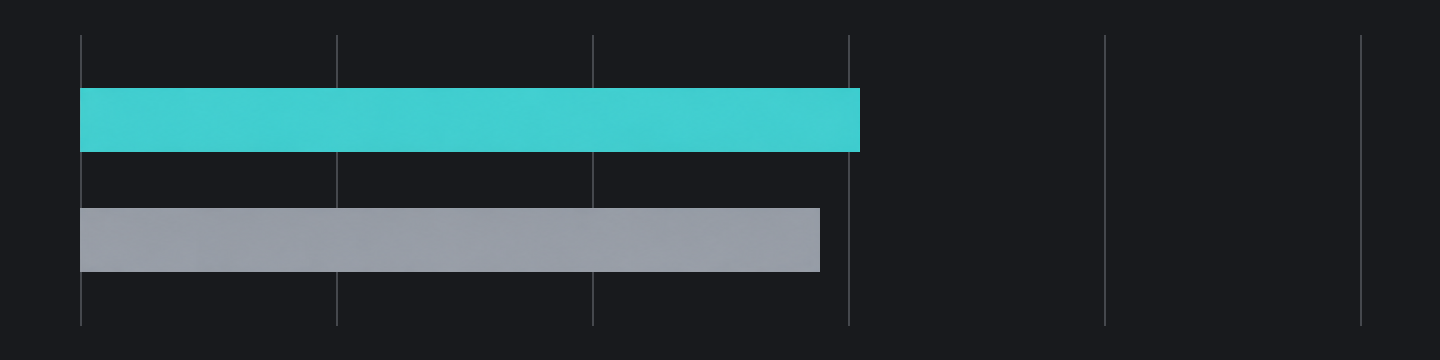
Fable 5.1: 65.0%Fable 5: 63.8%
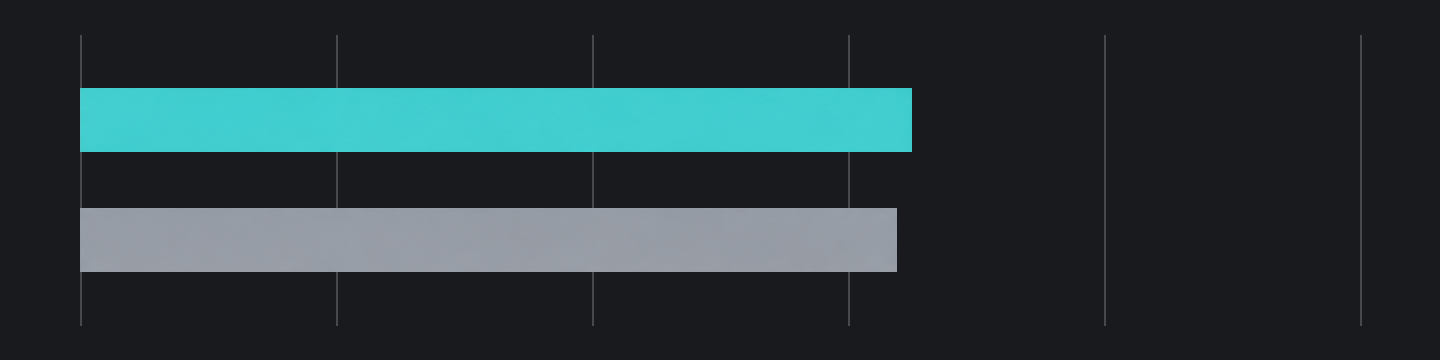
โค้ด: การก้าวหน้ามากที่สุดอยู่ที่งานเทอร์มินัล
โค้ด Fable 5.1 ดีขึ้นชัดสุดในงานเทอร์มินัลที่ต้องใช้สภาพแวดล้อม ประมวลผลรัน และทำงานต่อ ไม่ใช่ดีขึ้นเฉลี่ยทุกงานโค้ด Anthropic รายงานเพิ่มจาก Fable 5 จำนวน 27.9 จุดเปอร์เซ็นต์บน Terminal-Bench-Science 0.1, 13.8 จุดบน Terminal-Bench 4.0 และ 2.9 จุดบน CursorBench 3.2.0 ความต่างชี้การทำงานซับซ้อนแข็งแรงขึ้นแทนคุณภาพสร้างโค้ดก้าวกระโดดเท่ากันทั้งหมด
คุณค่าอยู่ที่เชื่อมวิเคราะห์กับการทำจริง Anthropic อธิบายพัฒนาข้ามฐานโค้ด เขียนทดสอบเอง และใช้ผลภาพตรวจว่าโค้ดตรงเป้าหรือไม่ เราตีความว่าพร้อมกว่าในการเข้าใจ แก้ ตรวจ และปรับวิธีแก้ แทนหยุดที่ข้อเสนอสมเหตุสมผล
เหตุผล: เพิ่มน้อยกว่าและขึ้นกับการตั้งค่า
การให้เหตุผลดีขึ้น แต่บางทดสอบเผยแพร่เพิ่มน้อยกว่างานเทอร์มินัล บน Humanity's Last Exam คะแนนไม่ใช้เครื่องมือเพิ่มจาก Fable 5 ที่ 57.8% เป็น 60.9% และใช้เครื่องมือจาก 63.8% เป็น 65.0% เพิ่ม 3.1 และ 1.2 จุดเปอร์เซ็นต์
เราไม่มอง effort เป็นสวิตช์ง่ายที่สูงแปลว่าฉลาดกว่าเสมอ แนวทาง Anthropic นิยามเป็นตัวควบคุมหลักของความสามารถ เวลาแฝง และต้นทุน และระบุว่าป้าย effort เดียวกันข้ามโมเดลไม่แทนปริมาณการคิดเท่ากัน
การอภิปรายชุมชนมีตัวอย่างแย้งมีประโยชน์ ผู้ใช้ Hacker News ชื่อ seaurchinzee ตีความการ์ดระบบว่า effort สูงสุดไม่ได้ดีที่สุดบน FrontierCode Extended และระดับสูงขึ้นอาจเพิ่มการเปลี่ยนที่ไม่ได้ขอ เป็นการประเมินโค้ดเฉพาะ ไม่ใช่ HLE แต่ชี้ว่าเหตุผลมากขึ้นไม่แปลว่าตามงานดีขึ้นเสมอ ขอบเขตสำคัญร่วมกับความถูกต้อง และแนวทางพรอมต์ Anthropic กล่าวถึงการเปลี่ยนเพิ่มและขยายขอบเขตแยกด้วย
ดัชนีอิสระและอัตราเอาต์พุต: สองคำถามแยกกัน
เราเห็นว่าความสามารถรวมกับความเร็วตอบ Fable 5.1 ควรประเมินแยก ไม่ลดเหลือคะแนนเดียว ตามตรวจวันที่ 4 ตุลาคม 2026 Artificial Analysis บันทึก Intelligence Index 53 สำหรับการตั้งค่า Max, Default Fallback เอาต์พุตประมาณ 66.2 โทเคนต่อวินาที และเวลาโทเคนแรกประมาณ 259.12 วินาที
ในงานวาด SVG เดียวกัน high ใช้ประมาณ 29.6 วินาที และ max ประมาณ 13 นาที 54 วินาที เราเห็นว่าผล effort สูงสุดดีกว่า แต่เวลารอและการใช้เอาต์พุตเพิ่มมากด้วย ข้อสรุปเราคือเหตุผลเพิ่มอาจปรับปรุงเอาต์พุตซับซ้อนบางอย่าง
Claude Fable 5.1 เทียบ Fable 5, GPT-5.6 Sol และ Kimi K3
หลักฐานตรงที่สุดสนับสนุน Fable 5.1 ยังเป็นการนำงานเทอร์มินัล ตารางต่อไปเป็นการประเมินเปิดตัว Anthropic
Fable 5.1: 53Kimi K3: 44
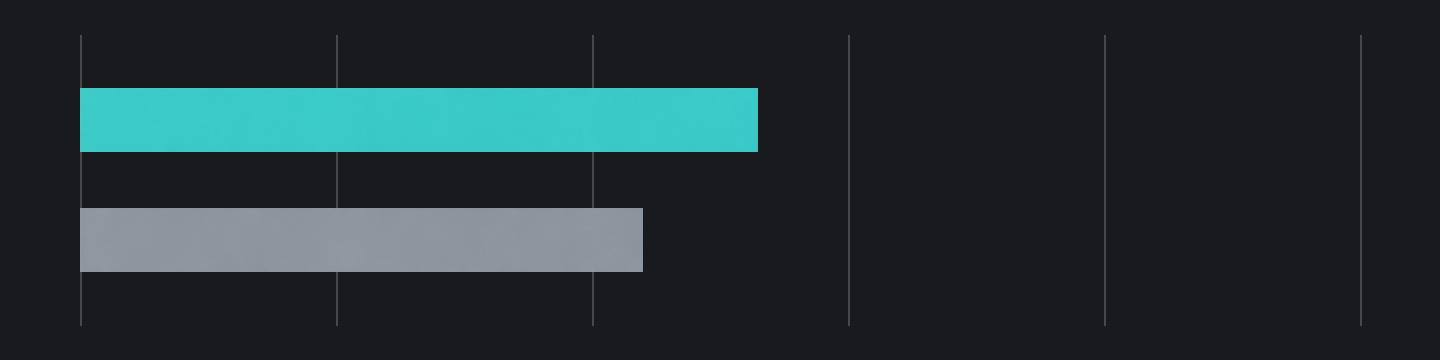
Fable 5.1: 52%Kimi K3: 13%
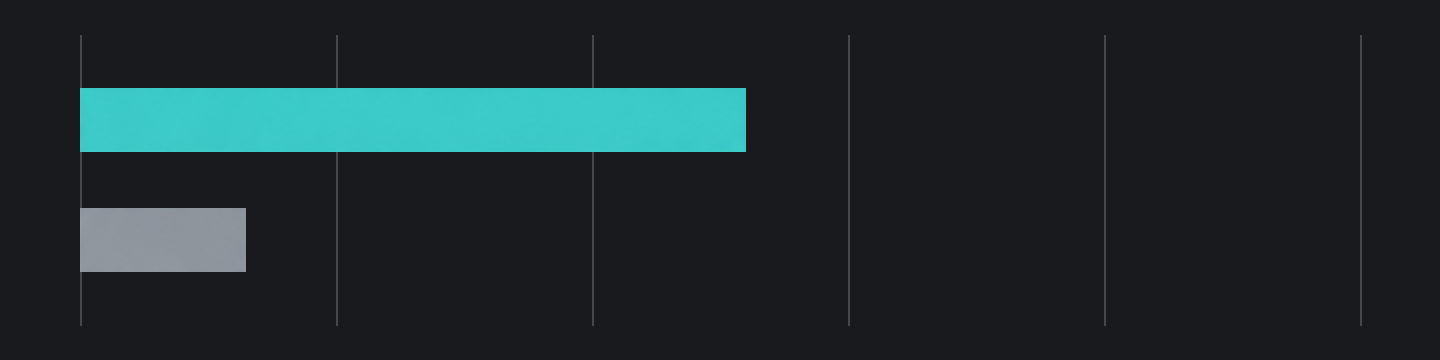
Fable 5.1: 85%Kimi K3: 89%
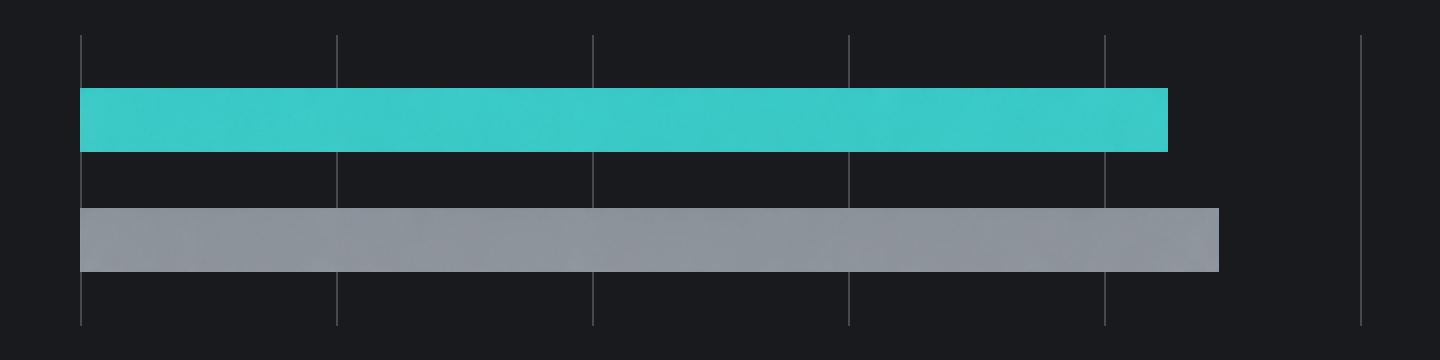
| การทดสอบมาตรฐาน | Fable 5.1 | Fable 5 | GPT-5.6 Sol |
|---|---|---|---|
| Terminal-Bench-Science 0.1 | 52.6% | 24.7% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 37.3% |
| CursorBench 3.2.0 | 73.4% | 70.5% | 67.2% |
เทียบ Fable 5 และ GPT-5.6 Sol: นำชัดสุดที่โค้ดเทอร์มินัล
คะแนนแสดง Fable 5.1 นำ GPT-5.6 Sol มากกว่าบนทดสอบเทอร์มินัลสองชุดเทียบ CursorBench ลูกค้ารายหนึ่งรายงาน Fable 5.1 เท่าหรือดีกว่า Fable 5 เล็กน้อยในการทดสอบ พร้อมลดต้นทุนต่องาน จึงเริ่มใช้โมเดลตรวจโค้ด
เทียบ Kimi K3: เหตุผลเอกสารยาวสลับอันดับ
เราประเมินว่า Fable 5.1 แข็งแรงกว่าในการประเมินรวมของการเทียบนี้ Artificial Analysis บันทึกดัชนี 53 สำหรับ Fable 5.1 และ 44 สำหรับ Kimi K3 พร้อมคะแนน Terminal-Bench 4.0 ที่ 52% และ 13% ตามลำดับ บน AA-LCR v1.1 เหตุผลบริบทยาวอันดับกลับ: Fable 5.1 ได้ 85% และ Kimi K3 ได้ 89%
ผู้ใช้บางคนอาจชอบคำอธิบาย Kimi K3 และสลับไปตรวจโค้ดหรือเข้าใจปัญหา ข้อสรุปปัจจุบันเราคือ Fable 5.1 นำความสามารถรวม ส่วน Kimi K3 นำทดสอบเอกสารยาวเฉพาะนี้
ทำไมจึงใช้ Claude Fable 5.1 ผ่าน API Hop?
คิดค่าบริการตามการใช้งานและปรับต้นทุนโมเดล
ค่าบริการเป็นไปตามอัตรา API Hop ปัจจุบันและการใช้งานจริง เติมเงินตามต้องการ
รวมโมเดล AI และ API ข้อมูล เข้าถึงหลายโมเดลในที่เดียว
คีย์ API เดียวเชื่อมต่อหลายโมเดล AI และบริการข้อมูล ลดต้นทุนการเชื่อมต่อและสลับได้ในคลิกเดียว แอปธุรกิจต้องการทั้ง AI และข้อมูล
บันทึกการเรียกใช้และควบคุมการเข้าถึงแอป ชัดเจนทุกการเรียก
การเรียก API ทุกครั้งบันทึกในแดชบอร์ด สร้างคีย์ API แยกสำหรับแต่ละแอป
ประเมินเอาต์พุตเทียบกับงานของคุณ
ใช้ ID โมเดลตามเอกสารและพารามิเตอร์ที่รองรับผ่าน API Hop ประเมินเอาต์พุตตามเกณฑ์ยอมรับของคุณ แล้วตรวจบันทึกการใช้งานและเมทาดาทาการตอบกลับก่อนใช้งานจริง ชื่อโมเดลหรือตัวอย่างไม่รับประกันแต่ละผลลัพธ์
วิธีใช้ Claude Fable 5.1 บน API Hop
หลังสร้างคีย์ API ในคอนโซล ให้ทำตามเอกสารเพื่อเริ่มใช้ Claude Fable 5.1
เตรียมบัญชีและทดสอบออนไลน์
เข้าสู่ระบบ ตรวจสอบยอดเงิน และสร้างคีย์ API
ลองในพื้นที่ทดลอง
สำรวจความสามารถโมเดลในพื้นที่ทดลองเพื่อหาวิธีใช้ที่เหมาะที่สุด
เชื่อมต่อ Claude Fable 5.1 เข้ากับธุรกิจของคุณ
ทำตามเอกสารนักพัฒนาของเราเพื่อเชื่อมต่อ Claude Fable 5.1 เข้ากับธุรกิจ
การอัปเกรดโมเดลในอนาคต
หากจะเปลี่ยนเป็นโมเดลใหม่กว่า ให้ยืนยันก่อนว่าแค็ตตาล็อกโมเดลของคีย์ API ส่ง ID ที่ตรงกันกลับมา หากรองรับเอนด์พอยต์และฟิลด์คำขอเดียวกัน ให้อัปเดต ID แล้วทดสอบรูปแบบการตอบกลับ สตรีม ขีดจำกัดเอาต์พุต และการคิดค่าบริการก่อนส่งทราฟฟิกจริง สำหรับงานภาพหรือวิดีโอแบบอะซิงโครนัส ให้ตรวจการส่งงาน โพลสถานะ และดึงผลลัพธ์ด้วย
คำถามที่พบบ่อยของ API Claude Fable 5.1
Claude Fable 5.1 เป็นโมเดล API เดียวกับ Fable 5 หรือไม่?
ไม่ใช่ Claude Fable 5.1 (ชื่อโมเดล API: claude-fable-5-1) เป็นรุ่นอัปเกรดของ Claude Fable 5 (ชื่อโมเดล API: claude-fable-5) ใช้พารามิเตอร์ model ที่ถูกต้องเมื่อเรียก API
ทำไม thinking ว่างหรือคำตอบไม่สมบูรณ์?
Fable 5.1 แบบเนทีฟใช้การคิดแบบปรับตัวเป็นค่าเริ่มต้นและอาจไม่แสดงข้อความการคิด คำขอทั่วไปไม่ต้องระบุพารามิเตอร์ thinking และ thinking ว่างเพียงอย่างเดียวไม่ได้หมายความว่าล้มเหลว หากคำตอบไม่สมบูรณ์ ให้ตรวจสอบสถานะสิ้นสุดและขีดจำกัดเอาต์พุต โดยเผื่อพื้นที่สำหรับการคิดและข้อความสุดท้ายให้เพียงพอ
แก้ปัญหาข้อผิดพลาดการยืนยันตัวตน ยอดเงิน หรือการเข้าถึงอย่างไร?
ทำตามเอกสารข้อผิดพลาด API เพื่อวินิจฉัยปัญหา
ใช้ OpenAI Responses กับ Claude Fable 5.1 ได้หรือไม่?
ไม่รองรับ OpenAI Responses โดย Claude มีรูปแบบ Claude Messages ของตนเอง ดูรายละเอียดในเอกสาร
บังคับเรียกเครื่องมือหรือแก้ไขบทสนทนา Messages แบบเนทีฟได้หรือไม่?
Fable 5.1 แบบเนทีฟไม่รองรับ tool_choice แบบบังคับ any หรือ tool ระวังเมื่อส่งการคิดที่บันทึกไว้ซ้ำหลังแก้ไขข้อความก่อนหน้า เก็บบล็อกเนื้อหา assistant แบบเนทีฟและลายเซ็นไว้ครบถ้วนเมื่อดำเนินการเครื่องมือต่อ
ความจำบทสนทนาคงอยู่ถาวรหรือไม่?
ไม่ API ไม่เก็บบริบทบทสนทนาโดยอัตโนมัติสำหรับคำขอถัดไป จัดการประวัติเองและรวมบริบทที่ต้องการในแต่ละคำขอ แอปของคุณต้องพัฒนาความจำระยะยาวเอง
API ข้อความที่เกี่ยวข้อง
ตัวอย่าง API Claude Fable 5.1 และพารามิเตอร์ที่รองรับ
เริ่มต้น API Claude Fable 5.1 อย่างรวดเร็ว
claude-fable-5-1ต้องระบุ model ตัวอย่างนี้ใช้ ID โมเดลของหน้าปัจจุบัน ตรวจสอบสิทธิ์เข้าถึงโมเดลของคีย์ API ด้วย GET /v1/models
Chat CompletionsPOST /v1/chat-completions
curl -X POST "https://api.apihop.ai/v1/chat-completions" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
-d '{"model":"claude-fable-5-1","messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'MessagesPOST /anthropic/v1/messages
Messages ต้องระบุ max_tokens ขีดจำกัดในตัวอย่างนี้แก้ไขได้ ไม่ใช่ค่าเริ่มต้นต้นทางหรือขีดจำกัดโมเดล การคิดอาจใช้หมดก่อนมีข้อความคำตอบ ปรับให้เหมาะกับงานและตรวจสอบค่าใช้จ่ายเอาต์พุต
curl -X POST "https://api.apihop.ai/anthropic/v1/messages" \
  -H "Authorization: Bearer <API_KEY>" \
  -H "Content-Type: application/json" \
  -H 'anthropic-version: 2023-06-01' \
  -d '{"model":"claude-fable-5-1","max_tokens":4096,"messages":[{"role":"user","content":"Hello, introduce yourself in one sentence."}],"stream":false}'
เอกสารอ้างอิงกลุ่มและโปรโตคอล
Claude Messages
เอกสาร API ฉบับเต็มAPI ดั้งเดิมที่เข้ากันได้กับ Claude Messages เอนด์พอยต์นี้ใช้รูปแบบคำขอและตอบกลับ Anthropic Messages รวมการเรียกเครื่องมือและเหตุการณ์ Anthropic SSE
POST
https://api.apihop.ai/anthropic/v1/messages